

 微信扫一扫,关注公众号
科技行者
算力行者


见证连接与计算的「力量」

人工智能将“吞噬”数据
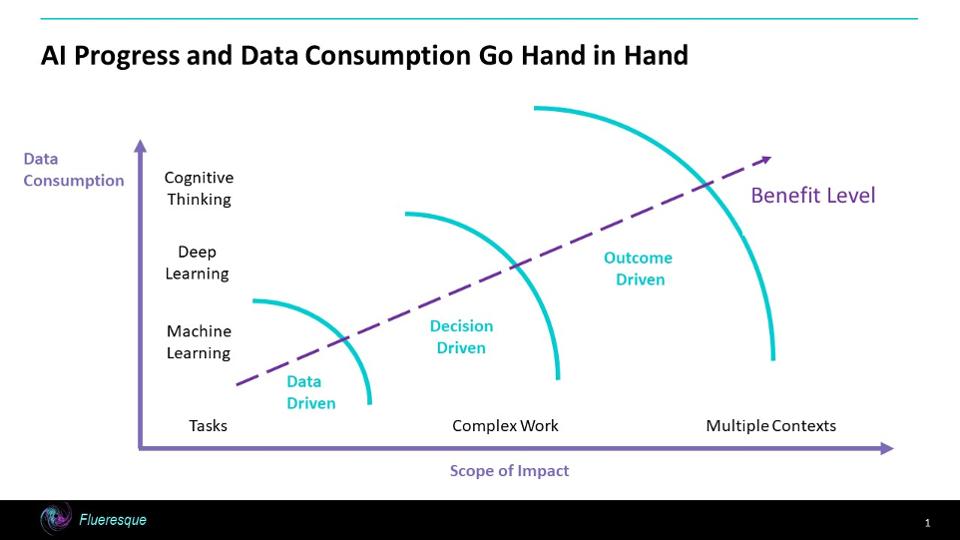


那些从事机器学习(ML)项目的人都知道机器学习需要大量数据来训练算法。有的人会说数据永远不嫌多。数据量和生成的机器学习模型的复杂程度之间通常存在着正相关性。随着人工智能向着新的领域发展,用到的人工智能功能变得愈加复杂,这种对数据的饥渴只会变得更加强烈。除了人工智能的复杂性,其他一些趋势也在加剧这一问题,因此组织面前就出现了这样一个问题:“他们是否拥有适当的数据以成功推动人工智能项目?”如果他们没有足够的资源,他们是否应该为人工智能盛宴做更多的准备?
图1:人工智能/数据连续性
组织已经收集的所有大数据不太可能都是正确的数据,但是了解人工智能的发展方向能够让组织获得“立足点”,在未来几十年人工智能的发展过程中筛选和收集更多正确的数据。
人工智能的发展改变了数据游戏
这又导致对数据的更多需求,在某些情况下,从本质上而言,这些需求可能是迫切或者实时的。
从数据驱动到结果驱动的转变
这只是推动数据使用量需求的源动力之一。
不断变化的问题范围影响数据需求
这些场景中的每一个都可能以不同的速率变化和变形,因此,也就会需要更多的数据。
总结
它将改变或拓展数据管理策略、方法和技术。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站






 推荐文章
政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案
论文提出动态民主同意框架,融合伯奈斯公关理论与系统动力学反馈模型,分析政治支持率如何受滚雪球增长、选民饱和、感知延迟和制度信任侵蚀四种机制影响,揭示宣传投放为何会失效甚至反噬。
让AI开一年网店,结果它把自己搞破产了
阿里巴巴团队推出E-Commerce Bench基准,让18个顶尖AI模型经营虚拟网店一年,揭示AI在长周期自主商业决策、供应商谈判防骗、现金流管理及经验学习方面存在巨大能力差异与隐藏短板。
雷达和光学,两张脸拍同一片地
本文解读ReFlowSET框架,它通过系统评测多款图像压缩器选出最适合雷达与光学图像的编解码器,并从零训练轻量生成模型完成雷达图到光学图的翻译,在多个数据集上取得领先的感知与分布质量表现。
DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据
阿里团队提出DICS方法,通过评估图片、问题、答案三者的内在一致性给训练数据打分,结合自适应采样策略筛选高质量子集。仅用25%的LLaVA-1.5-665K数据训练即超越全量数据效果,并在600万样本规模验证下用不到四分之一数据逼近官方InternVL3-8B性能。

政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案

让AI开一年网店,结果它把自己搞破产了

雷达和光学,两张脸拍同一片地

DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据





