

 微信扫一扫,关注公众号
科技行者
算力行者


见证连接与计算的「力量」

双流卷积网络:当深度学习第一次在视频动作识别上打败了手工特征


2014年之前,如果你把一段视频丢给一个深度学习模型,让它识别里面的人在做什么动作,结果大概率会很尴尬。
不是因为深度学习不行。恰恰相反,那两年深度学习正在图像识别领域横扫一切,AlexNet 在 2012 年一鸣惊人之后,卷积神经网络几乎成了计算机视觉的标准答案。但奇怪的是,把同样的思路搬到视频上,效果却始终不如一种叫"密集轨迹"的老派手工特征方法。
这事儿说出来你可能觉得不可思议:一个需要人工设计规则、需要研究者绞尽脑汁去想"什么样的数学描述能代表运动"的老方法,居然在打败了国际象棋世界冠军的深度学习面前,稳稳占据上风长达两年。这在当时的计算机视觉圈子里,是一件让人挠头的事。
牛津大学的 Karen Simonyan 和 Andrew Zisserman 决定搞清楚这是为什么。他们的答案,写成了一篇后来影响深远的论文,题目叫《用于视频动作识别的双流卷积网络》。这篇论文里提出的方法,第一次让深度学习在这个任务上反超了手工特征,而且反超的方式相当巧妙,值得慢慢讲清楚。
问题到底难在哪里
要理解这篇论文的价值,得先搞明白视频动作识别和普通图像识别的根本区别在哪。
识别一张静态图片里有没有猫,你只需要看懂空间信息就够了:形状、颜色、纹理,这些东西都摆在一张图里,模型学起来相对直接。但识别视频里的动作,比如判断一个人是在"打网球"还是"打棒球",光看一帧画面往往不够。想象你只截取了运动员挥拍瞬间的一张照片,如果没有上下文,你甚至分不清他是在打网球还是打羽毛球。
动作是时间上的连续变化,这是它和静态图像最本质的不同。
问题是,卷积神经网络这套工具,最早是为静态图像设计的。它擅长从一堆像素里提取空间结构,比如边缘、纹理、形状,但它天生不懂"运动"这个概念。你如果简单粗暴地把视频的每一帧都扔给一个图像分类网络,让它单独判断,再把结果做个投票平均,效果确实不理想。
在这篇论文发表之前,效果最好的方法是牛津大学同一批研究者提出的"密集轨迹",配合一种叫 Fisher 向量的编码方式。这套手工设计的方法在 UCF-101 这个动作识别数据集上能达到大约 87.9% 的准确率。而当时最好的深度学习尝试,比如一种叫 slow fusion 的时空卷积网络,只能做到 65.4% 左右。
这个差距有多大?
意味着每识别 5 段视频,深度学习方法就要比手工特征多犯将近 1 次错误,这在实际应用里几乎是不可接受的差距。深度学习在图像分类上已经把传统方法甩开了一大截,但在视频动作识别这件事上,居然被倒打一耙。
Simonyan 和 Zisserman 琢磨的问题就是:卷积网络到底缺了什么,才会在视频任务上如此拉胯?
他们的答案很直接:卷积网络缺的不是"看懂画面"的能力,而是"看懂运动"的能力。而运动信息,恰恰是手工设计的密集轨迹方法最擅长捕捉的部分。于是一个大胆的想法诞生了:如果卷积网络本身不擅长直接从原始视频帧里学出运动模式,那能不能先把运动信息用某种方式"提炼"出来,单独喂给一个网络去学?
光流:把运动这件事翻译成图像
这个提炼运动信息的工具,叫做光流。
> 光流:描述视频里每个像素点从一帧到下一帧移动方向和速度的一种表示方法,本质上是一张记录了"每个点往哪儿动、动多快"的位移图。
光流不是这篇论文发明的,它是计算机视觉里一个很老的概念,早在几十年前就有研究者在做。但这篇论文的关键洞察是:光流本身就是一种可以被当作"图像"来处理的东西。
你可以这样理解:普通的图片是每个像素点记录了颜色和亮度,而光流场是每个像素点记录了一个位移向量,水平方向挪动了多少,垂直方向挪动了多少。如果你把水平位移和垂直位移分别当成一张灰度图来看待,你就得到了两张可以直接喂给卷积网络的"运动地图"。
这一步的巧妙之处在于,它把一个网络本身不擅长的任务(理解时间维度上的变化)转化成了一个网络已经很擅长的任务(处理静态图像里的空间模式)。网络不需要自己去猜测运动的规律,运动信息已经被提前算好、摆在那里了,网络只需要像处理普通图片一样去学习这些光流图里的模式。
这就好比你要教一个从没学过乐理的人分析一首曲子的节奏变化。如果直接把整首曲子的录音丢给他,让他从声波里自己摸索出节奏规律,他可能无从下手。但如果你先把每个音符的时间戳和强弱标注出来,做成一张清晰的节奏图谱,再让他去分析这张图,他立刻就能看出规律。光流对卷积网络起的就是这个"提前标注"的作用,如果不做这一步提炼,直接把原始像素序列丢给网络去暴力学习运动规律,网络就得同时兼顾"看懂空间形状"和"看懂时间变化"两件事,而实验证明这对当时的网络架构来说太难了。
双流架构:空间和时间分开学,最后再合并
搞清楚光流的作用之后,论文接下来的设计就顺理成章了:既然空间信息和运动信息是两种性质不同的东西,那就用两个完全独立的卷积网络分别去学,最后再把两边的判断结果融合起来。
这就是论文标题里"双流"的来源。
第一条流叫空间流,输入是视频中单独抽取出来的一帧画面,处理方式和普通的图像分类网络几乎一样。它负责学习画面里的静态信息:场景是什么样的、物体长什么样、人物的姿态如何。
第二条流叫时间流,输入是一连串连续帧计算出来的光流图,通常是取相邻十帧左右的光流叠在一起,形成一个包含多个通道的输入。它负责学习运动模式:肢体怎么摆动、物体怎么移动、这种移动轨迹在不同动作里有什么区别。
两条流的网络结构大体相似,都是当时流行的卷积网络架构,但各自独立训练,互不干扰。到了最后判断阶段,两条流各自输出一个分类结果,再通过简单的加权平均或者训练一个小型的支持向量机把两边的判断融合成最终答案。
> 空间流:只处理单帧静态画面的卷积网络分支,负责捕捉场景、物体外观等静态视觉信息。
> 时间流:只处理光流图的卷积网络分支,负责捕捉动作和运动模式。
这个设计里有一个反直觉的地方。你可能会觉得,既然两种信息都重要,把它们从一开始就混在一起训练,让网络自己去平衡,是不是更聪明?但论文的实验恰恰证明了分开训练效果更好。
原因不难理解。空间信息和运动信息的统计特性差别很大,一个是颜色和纹理的分布,一个是位移向量的分布,如果强行用同一套网络参数去同时拟合这两种截然不同的模式,网络很容易在两者之间顾此失彼,学得两头都不够精。分开训练相当于给网络分了工,每条流只需要专注做好一件事。
这就像让一个人同时学骑自行车和学书法,如果要求他必须在同一堂课、用同一种练习方法把两件事一起练熟,大概率两件事都学不精。但如果分成两门独立的课,一门专攻手部的精细控制,一门专攻身体的平衡协调,各自练到位之后再看这个人是不是能在需要的场合把两种技能都用上,效果会好得多。如果不分开训练,会发生什么?论文里没有直接给出"混合训练"这一条对比实验,但从两条流各自单独测试的结果就能看出分工的价值:单独用空间流,UCF-101上的准确率是72.6%;单独用时间流,能达到81.0%。这中间将近10个百分点的差距说明,运动信息本身承载的判别力,远比很多人直觉里认为的"背景重要"要强得多。而两条流融合之后,准确率进一步跳到88.0%,说明两种信息确实是互补的,谁也替代不了谁。
多任务训练:用两个数据集一起喂饱一个网络
双流架构解决了"从哪里获取运动信息"的问题,但另一个现实困难摆在面前:训练一个深度卷积网络需要海量数据,而当时的视频动作识别数据集,比如 UCF-101,只有13000多个视频片段,这个规模对于训练一个不过拟合的深度网络来说,实在有点单薄。
这里又有一个值得琢磨的细节。当时还有另一个规模稍大的数据集叫 HMDB-51,但两个数据集的动作类别定义、标注标准都不完全一致,不能简单地把两堂数据拼在一起当成一个更大的数据集来训练。
研究者们的解法是多任务学习。
> 多任务学习:让同一个网络同时学习完成两个不同的分类任务,网络的底层结构共享,但最后输出的分类层针对每个任务各自独立。
具体做法是,网络的前面大部分层参数是共享的,只在最后接了两个并列的输出层,一个负责预测 UCF-101 里的类别,一个负责预测 HMDB-51 里的类别。训练的时候,一个批次的数据里既有来自 UCF-101 的样本也有来自 HMDB-51 的样本,网络会根据样本来源,只更新对应那个输出层的参数,但共享层的参数会被两边的数据共同塑造。
这个思路背后的逻辑是:尽管两个数据集的具体类别定义不一样,但它们背后需要的底层视觉能力,比如识别人体姿态、识别常见物体、识别典型的运动模式,是相通的。让网络在两个数据集上同时练习,相当于变相扩充了训练数据量,网络的底层表征能学得更扎实,即使最后的分类头是分开的。
这跟一个学生同时准备两门内容有重叠但考试范围不同的考试是类似的情况。如果两门课都涉及基础的阅读理解能力,学生可以用两门课的阅读材料一起练习阅读理解这项底层技能,尽管最后两门考试的具体题型和考点不同,需要分别应对。如果这个学生只死磕一门课的题目量,因为题量有限,阅读理解能力练不到位;但如果他能把两门课的阅读材料都用来打磨这项通用能力,效果会好很多。如果不采用多任务学习,只用单一数据集训练,论文里对比的结果显示,这种多任务的训练方式确实带来了实际的准确率提升,说明"数据不够就想办法共享底层能力"这个思路,是在数据稀缺场景下让深度学习真正跑起来的关键一环。
最终效果:反超手工特征的那一刻
把所有设计拼起来之后,论文在 UCF-101 数据集上取得的最终准确率是 88.0%。
这个数字放在当时的语境里,意义相当重大。它第一次让基于深度学习的方法超过了当时最好的手工特征方法(密集轨迹加 Fisher 向量编码,大约 87.9%)。虽然从数字上看只多了0.1个百分点,差距看起来很小,但这标志着一个方向性的转折:深度学习不再是"理论上很有潜力但实际打不过手工方法"的存在,它证明了自己在这个任务上是可行的,而且是可以持续优化、继续往前推进的路径。
下面这张表格大致展示了当时几种代表性方法在 UCF-101 上的表现对比:
| 方法 | 准确率 |
|---|---|
| 手工特征(密集轨迹+Fisher向量) | 87.9% |
| 深度学习(slow fusion时空卷积) | 65.4% |
| 单独空间流 | 72.6% |
| 单独时间流 | 81.0% |
| **双流网络融合** | **88.0%** |
从这张表里能看出几个关键信息。单独的空间流表现明显弱于单独的时间流,说明运动信息在动作识别里的分量比很多人以为的更重。而两条流融合之后的提升,也证明了空间信息和运动信息确实是互补而非冗余的关系。
这篇论文发表的时间点也值得一提。Simonyan 和 Zisserman 同一年,也就是几个月之后,发表了另一篇同样影响深远的论文,提出了 VGGNet,那篇论文奠定了后来很多网络架构设计的基础。两篇论文出自同一个研究小组、同一年发表,某种程度上也说明了这个团队当时在卷积网络这件事上的持续深耕。
后来的路:这个思路怎么被继续往前推
双流网络的思路提出之后,很快成了视频理解领域的一个重要基线,后续大量工作都在它的框架上做延伸。
2016年,Feichtenhofer等人提出了将双流网络进行更深度融合的方法,探索了在网络的中间层就把空间流和时间流的信息进行交互,而不是等到最后才简单相加,这一步改进进一步提升了识别准确率,说明"分开学习、最后融合"这个策略本身还有更精细的优化空间。
2017年,Carreira 和 Zisserman(还是同一位 Zisserman)提出了 I3D 网络,把双流网络里的二维卷积扩展成三维卷积,让网络能直接在时间维度上做卷积操作,同时还引入了一个大规模的视频数据集 Kinetics 用于预训练。这一步相当于往前多走了一步:既然运动信息这么重要,能不能让网络直接从原始视频里学会怎么提取运动信息,而不再依赖预先计算好的光流?I3D 在多个数据集上都取得了当时最好的成绩,进一步证明了双流网络提出的"空间和时间需要被分别对待"这一核心洞察,即便实现方式在演进,底层逻辑一直被保留了下来。
这两个后续工作有一个共同的脉络:它们都没有否定双流网络最初的判断,运动信息和空间信息应该被区别对待,但它们都在想办法减少对手工计算光流这一步骤的依赖,因为提前计算光流本身是一个耗时且不能端到端训练的步骤。这也提示了双流网络本身留下的一个明显短板:它依赖一个网络之外的、传统的光流计算算法,整个系统不是完全由数据驱动、端到端学习出来的。这个短板在后续研究里被逐步补上。
写在后面
读这篇论文最触动我的一点,是研究者面对"深度学习打不过手工方法"这个尴尬局面时的反应方式。他们没有简单地把网络做得更深、参数调得更多去硬撑,而是先停下来问:手工方法到底赢在哪儿?答案是光流,这个几十年前就存在的运动表征方法。于是他们没有摒弃传统方法,而是把它当成一种输入,嫁接到深度网络上。
这提示了一个经常被忽略的道理:新工具不一定要完全取代旧工具才算成功,有时候旧工具提炼出的洞察,可以直接喂给新工具,让新工具跑得更快。
论文里空间流和时间流准确率差了将近9个百分点这件事,也值得多想一层。这多少说明了在动作识别这个任务里,"这个人长什么样、背景是什么"远不如"他怎么动"来得关键,这和人类直觉里"先看整体画面"的判断方式恰好是错位的。
如果给这套方法留一个问题,那就是:既然运动信息比静态信息更关键,为什么后来的很多视频理解系统,包括不少大规模预训练模型,还是习惯性地把视频简化成几帧静态图片去处理?这中间的取舍,恐怕还没有一个真正让人满意的答案。
Q&A
Q1:双流卷积网络是什么?
A:这是牛津大学研究者Karen Simonyan和Andrew Zisserman在2014年提出的视频动作识别方法,用两个独立的卷积网络分别处理静态画面(空间流)和光流图(时间流),最后融合两边的判断结果,第一次让深度学习方法在UCF-101数据集上超过了传统手工特征方法。
Q2:双流网络为什么要用光流而不是直接用原始视频帧?
A:因为卷积网络原本擅长处理静态图像的空间模式,但不擅长直接从像素序列里学习时间维度上的运动规律。光流把每个像素点的移动方向和速度提前计算成一张类似图片的位移图,相当于把网络不擅长的任务转化成了它已经擅长的任务。
Q3:双流网络后来被哪些研究改进了?
A:2016年Feichtenhofer等人提出了在网络中间层就融合两条流信息的方法,提升了准确率;2017年Carreira和Zisserman提出I3D网络,用三维卷积让网络直接从视频里学习运动信息,减少了对预先计算光流的依赖,并引入了大规模Kinetics数据集做预训练。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站






 推荐文章
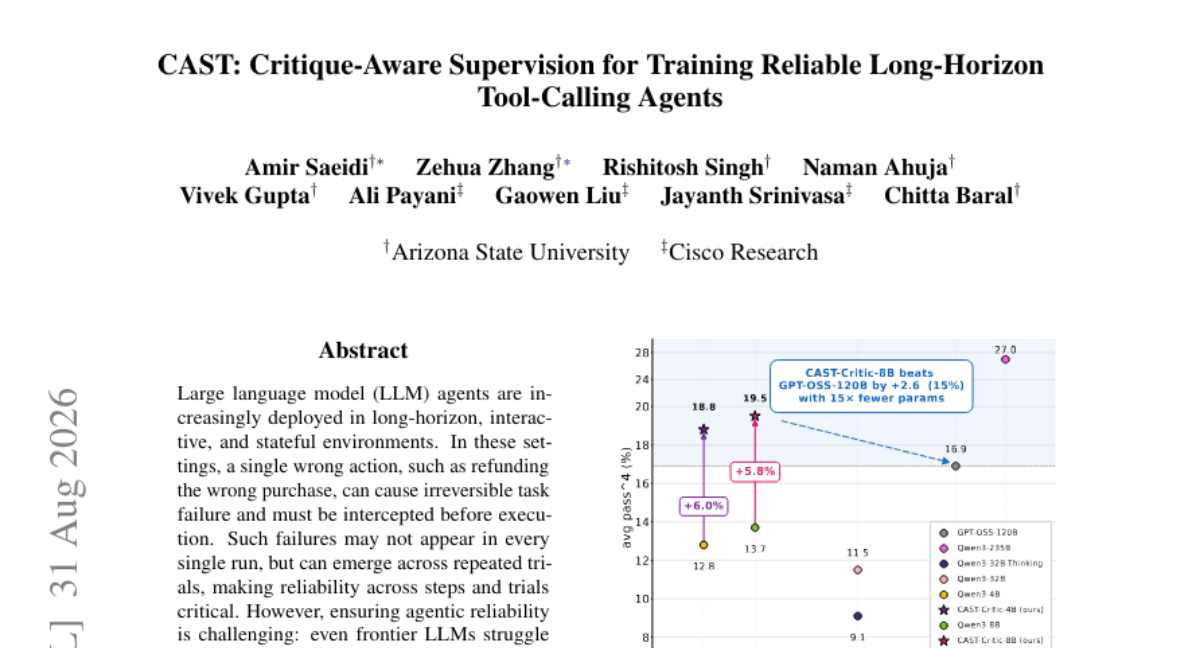
AI 帮你退货却改错订单:为什么能力强的智能体,依然会搞砸不可逆业务?
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。

AI 帮你退货却改错订单:为什么能力强的智能体,依然会搞砸不可逆业务?

当机器人学会走路,却依然找不到答案

老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录

让AI给自己出考题:科研计划训练里那个作弊漏洞





