

 微信扫一扫,关注公众号
科技行者
算力行者


见证连接与计算的「力量」

双流卷积网络:当深度学习第一次学会"看"视频里的动作


2014年之前,如果你问计算机视觉领域的人一个问题:深度学习能不能识别视频里的动作,很多人会摇头。
不是因为没人尝试过。是因为尝试的人都撞了墙。
当时最强的视频动作识别方法,靠的是一套叫做"密集轨迹"的手工设计特征,在UCF-101这个标准测试集上能跑到87.9%的准确率。而当时最好的深度学习方法呢,只有65.4%左右。整整差了20多个百分点。
20个百分点是什么概念?意味着每5个动作里,深度学习就要比手工方法多认错1个。这在图像识别领域是不可想象的差距,因为就在两年前的2012年,AlexNet已经用深度学习把图像分类问题打得手工特征毫无还手之力。可换成视频,深度学习突然就不灵了。
这事儿透着一股别扭。图像能学,视频学不了,问题出在哪?
牛津大学的Karen Simonyan和Andrew Zisserman决定把这个问题掰开揉碎了看。他们的答案后来发表在2014年的NeurIPS上,论文叫《Two-Stream Convolutional Networks for Action Recognition in Videos》。这篇论文后来被引用了上万次,几乎成了视频动作识别领域绕不开的起点。有意思的是,Simonyan和Zisserman同一年还发表了另一篇更有名的论文,就是VGGNet。两篇论文出自同一个组,同一年,这不是巧合,是他们当时确实在系统性地攻克卷积网络的各种应用场景。
问题出在哪:视频比图片难在哪里
先说清楚为什么视频这么难啃。
一张图片,卷积网络要学的是空间信息:这是一只猫还是一条狗,物体的形状、颜色、纹理长什么样。这件事深度学习已经证明自己很擅长了。
但视频不一样,视频的关键往往不在"长什么样",而在"怎么动"。
一个人张开手臂,可能是在打招呼,也可能是在做体操,也可能是在跳舞。单看一帧画面,这三个动作可能长得几乎一样。真正区分它们的信息,藏在连续帧之间的运动轨迹里。
当时的深度学习方法,基本套路是把视频的每一帧或者一小段时间窗口喂给卷积网络,指望网络自己从像素变化里学出运动模式。听起来合理,但实际效果很差。网络学到的更多是背景、场景这些静态线索,而不是真正的动作本质。
**这就好比让一个从没学过乐理的人去听一整场交响乐,然后问他哪段是小提琴独奏。他能感觉到"声音变化了",但抓不住那个变化的规律。**
如果不解决这个问题会怎样?答案已经摆在眼前了,65.4%对87.9%,深度学习输得明明白白。
核心思路:把"形状"和"动作"分开学
Simonyan和Zisserman的洞察其实挺朴素的。他们说,人类视觉系统本身就分成两条通路,一条处理物体形状,一条处理物体运动,这在神经科学里叫双流假说*。
> 双流假说:视觉皮层里存在两条相对独立的信息处理通路,一条叫腹侧流负责识别"这是什么物体",另一条叫背侧流负责感知"这个物体在怎么运动"。
如果人脑分开处理这两件事,那卷积网络是不是也应该分开处理?
于是他们设计了两条独立的卷积网络。
第一条叫空间流*。
> 空间流:输入单张RGB图像帧,负责识别画面中的物体、场景、外观这些静态视觉信息。
第二条叫时间流*。
> 时间流:输入连续多帧之间计算出的光流场,负责捕捉画面里物体和人的运动模式。
这两条网络各自独立训练,最后把它们的预测结果做加权融合,得出最终的动作分类。
这个设计的核心矛盾在于:如果只用一个网络同时处理外观和运动,网络很容易"偷懒",光靠背景和物体外观就能猜对不少动作,比如看到游泳池就猜是"游泳",根本不需要理解真正的运动轨迹。这样训练出来的网络泛化能力很差,换个场景就失灵。把两条信息流强制分开,逼着时间流网络必须专注于运动本身,因为它压根看不到RGB图像,看不到背景和颜色,它能看到的只有光流。
论文里给出的图展示了这套架构长什么样,两个卷积网络并排画着,一个吃视频帧,一个吃光流场,最后在顶端汇合,输出融合后的分类分数。看这张图会发现,两条流从头到尾都是分开走的,只在最后一步才碰头,这不是随意的架构选择,而是刻意保留了两种信息各自的独立性。
光流:让机器"看见"运动本身
时间流网络吃的是光流*这个东西,这里得多说两句。
> 光流:描述视频中每个像素点在连续两帧之间移动方向和距离的向量场,本质上是把"运动"这件事直接可视化成了图像。
想象你把一段视频的相邻两帧叠在一起做对比,每个像素往哪个方向挪动了多远,光流算法会把这个信息算出来,变成一张新的"图"。这张图不再是颜色和纹理,而是纯粹的运动信息,哪里在往左移,哪里在往右移,哪里几乎没动。
论文用的是一种叫做密集光流*的计算方式。
> 密集光流:给画面里几乎每一个像素点都计算出运动向量,而不是只挑几个关键点计算,因此得到的运动场信息非常细密完整。
具体实现上,作者把光流场拆成水平方向和垂直方向两个分量,堆叠若干帧,作为时间流网络的输入。他们还试验了另一种变体,叫轨迹光流*。
> 轨迹光流:不是简单堆叠固定位置的光流,而是沿着运动轨迹采样,让网络看到的是同一个点持续运动的路径,减少相机抖动或视角变化带来的干扰。
为什么要费这么大劲去算光流,而不是直接把连续的原始帧喂给网络,让它自己学运动?
论文的实验回答了这个问题。直接用原始帧堆叠训练出来的时间流网络,效果远不如用光流训练的。原因是原始像素里混杂了太多和运动无关的信息,颜色、纹理、光照变化,网络很难从这堆噪声里提炼出真正的运动规律。而光流已经把运动信息"预处理"好了,直接摆在网络面前,网络只需要学怎么利用这些信息,不需要再费力从像素里反推运动。
**这就像教一个新手厨师做菜,你可以给他一堆完整的食材,让他自己判断哪些该切丁、哪些该切片,也可以提前把食材都处理好摆在案头,他只需要专心琢磨怎么下锅调味。后者显然学得更快,因为省去了一道容易出错的中间步骤。如果不做这道预处理,厨师很可能把精力耗在辨认食材上,根本轮不到练手艺。**
融合两条流:1加1能不能大于2
单独看空间流网络,在UCF-101上能到大约73%左右的准确率。单独看时间流网络,能到大约83%左右。这已经比之前的深度学习方法强了不少,尤其是时间流,证明了光流确实是个好东西。
但重点是把两条流融合起来会发生什么。
论文尝试了几种融合方式,最简单的是直接对两个网络输出的分类概率做平均或者加权平均。结果融合后的准确率达到了88%左右,超过了当时最强的手工特征方法密集轨迹的87.9%。
这是深度学习第一次在视频动作识别这个任务上打赢手工特征。这句话放在2014年,分量不亚于两年前AlexNet在图像分类上的横空出世。
那如果只用空间流会怎样?准确率停留在73%左右,比手工特征低了整整15个百分点。这个数字直接说明了一件事,只靠外观信息,深度学习在视频理解上是打不过精心设计的手工特征的。真正让深度学习翻身的,是那条专门处理运动的时间流。
融合的好处在这里就特别明显了。空间流擅长利用场景和物体线索,比如看到球场大概能猜到是球类运动。时间流擅长捕捉具体的动作细节,比如挥拍、跑步的姿态变化。两者各自都有盲区,单靠外观容易被相似场景迷惑,单靠运动有时候区分不出细微的动作差异,但两者结合起来,盲区被大幅补上了。
**这有点像判断一个人的职业。你光看他穿的衣服猜,可能猜错,医生和护士的白大褂看起来差不多。你光看他的动作猜,同样可能猜错,很多职业都要重复弯腰、站立这些动作。但如果把两条信息放在一起看,穿白大褂,还在做心脏听诊的手势,答案基本就锁定了。如果只用一条线索,误判的空间会大得多。**
数据不够怎么办:用图片预训练撑起视频任务
这篇论文还解决了一个不那么起眼但很关键的问题,训练数据不够。
当时能用的视频动作识别数据集规模都不大,UCF-101只有大约13000段视频,另一个常用的HMDB-51更小。这个规模对于训练一个深层卷积网络来说远远不够,很容易过拟合*。
> 过拟合:模型在训练数据上表现很好,但换到没见过的新数据上表现骤降,说明它记住了训练集里的细节,而不是学到了真正有用的规律。
作者的解决办法是借用图片领域海量的数据资源。他们先在ImageNet这个包含上百万张图片的大型数据集上预训练空间流网络的卷积层,让网络先学会识别各种物体和场景的通用视觉特征,然后再迁移到动作识别任务上做微调。
这个思路后来被称为迁移学习*的典型应用。
> 迁移学习:把一个任务上训练好的模型知识,搬到另一个相关但数据量小的任务上继续使用,避免从零开始训练导致的数据不足问题。
时间流网络没法直接用ImageNet预训练,因为光流图像和普通RGB图像的统计特性完全不同,但作者通过多数据集联合训练、数据增强等手段,同样缓解了数据不足的问题。
**这就像一个刚毕业的医学生要去一个罕见病专科实习。这个专科病例少,直接靠这些病例从零训练一个医生是不现实的。但如果这个学生已经在综合医院完整地学过解剖学、生理学这些通用知识,再去专科积累经验,效率会高得多。如果没有前面通用知识的积累,直接扔进罕见病房,大概率会因为病例太少学不出靠谱的判断力。**
后续影响:这条路后来被怎么走下去了
双流网络这个框架提出之后,很快成为视频动作识别领域接下来几年的主流范式,后续大量工作都是在这个骨架上做改进。
2015年,Wang等人发表了《Action Recognition with Trajectory-Pooled Deep-Convolutional Descriptors》,把双流网络学到的深度特征和传统的轨迹特征结合起来做池化,进一步提升了准确率,说明手工特征和深度特征并不是非此即彼的关系,融合起来效果更好。
2016年,Feichtenhofer等人的《Convolutional Two-Stream Network Fusion for Video Action Recognition》把原本只在最后输出层做融合的两条流,改成在网络中间层就开始交互融合,让空间流和时间流能更早地互相借鉴信息,进一步把准确率往上推了一截。
再往后,2017年的I3D网络,也就是《Quo Vadis, Action Recognition?》这篇论文,把双流的思路和三维卷积结合起来,用三维卷积核直接在时空维度上做卷积,同时还是保留了双流结构,在Kinetics这个更大规模的数据集上刷出了当时的新纪录。这篇论文某种程度上是双流思想和三维卷积思想的一次合流。
这几条后续路径都没有推翻双流网络最初的判断,外观信息和运动信息应该被区别对待,这个判断到今天依然是视频理解领域的基本共识之一。
主要实验结果一览
| 方法 | UCF-101准确率 |
|---|---|
| 密集轨迹(手工特征,此前最强方法) | 87.9% |
| 单独空间流网络 | 约73.0% |
| 单独时间流网络 | 约83.7% |
| **空间流+时间流融合** | **约88.0%** |
从这张表能看得很清楚,单条流都打不过手工特征,只有两条流合体之后才实现了反超。这也印证了论文最核心的判断,视频理解不能靠单一维度的信息,外观和运动缺一不可。
写在后面
读这篇论文的时候,有个细节让我停下来想了很久。作者没有去设计一个更复杂、更深的单一网络来硬啃视频理解问题,而是先退回去问了一个更基础的问题,人是怎么看懂一个动作的。这个从神经科学借来的双流假说,某种程度上比后面的具体网络结构设计更值得琢磨。很多时候技术卡住不是因为算法不够精巧,是因为问题本身被想得太笼统了,把一个大问题拆成两个各自更纯粹的小问题,反而是最省力的解法。
另外一个值得说的是,光流这个中间表示的作用。它相当于人为地把"运动"这个抽象概念,提前翻译成了一种网络更容易消化的具体形式。这让我想到很多领域里,好的中间表示往往比更大的模型更重要。
这篇论文没解决的问题也很明显,光流本身的计算是独立于网络之外的一步,不是端到端学习出来的,这多少有点别扭。后面几年三维卷积网络的兴起,某种程度上就是想把这一步也塞进网络内部自己学。这个矛盾后来怎么被一步步磨平的,是另一个值得细讲的故事了。
Q&A
Q1:双流卷积网络是什么?
A:双流卷积网络是Simonyan和Zisserman在2014年提出的视频动作识别模型,它用两条独立的卷积网络分别处理视频的外观信息和运动信息,一条叫空间流处理单帧图像,一条叫时间流处理光流场,最后融合两者的预测结果。
Q2:双流卷积网络为什么要用光流而不是直接用原始视频帧?
A:因为原始像素里混杂了颜色、纹理、光照等大量和运动无关的信息,网络很难直接从中提炼出运动规律。光流已经把运动信息提前计算好了,网络可以直接利用,实验证明这样训练出来的时间流网络效果明显更好。
Q3:双流卷积网络的效果比之前最好的方法提升了多少?
A:在UCF-101数据集上,双流网络融合后的准确率达到约88%,超过了当时最强的手工特征方法密集轨迹的87.9%,这是深度学习第一次在视频动作识别任务上超越手工设计的特征方法。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站






 推荐文章
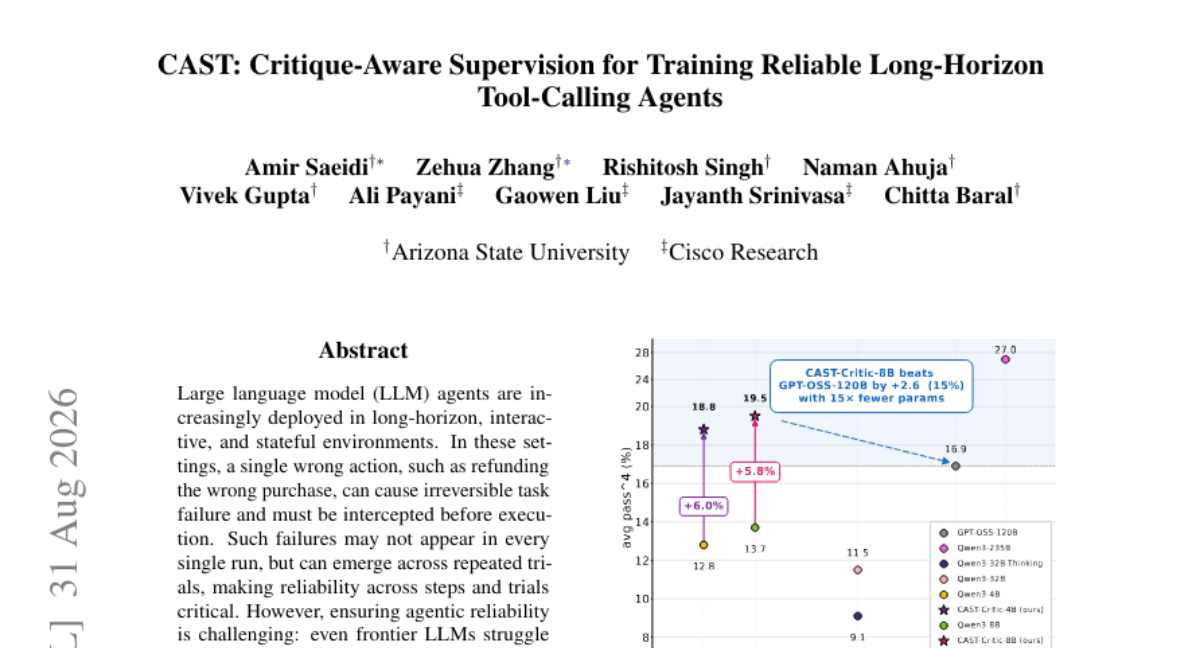
AI 帮你退货却改错订单:为什么能力强的智能体,依然会搞砸不可逆业务?
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。

AI 帮你退货却改错订单:为什么能力强的智能体,依然会搞砸不可逆业务?

当机器人学会走路,却依然找不到答案

老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录

让AI给自己出考题:科研计划训练里那个作弊漏洞





