

 微信扫一扫,关注公众号
科技行者
算力行者


见证连接与计算的「力量」

当AI帮你把一整个仓库从C语言搬到Rust,你怎么知道它真的搬过去了


先讲一件挺离谱的事。
假设你雇了一个装修队,说好把家里所有的木质门窗换成铝合金的。三个月后,装修队跟你说"完工了,验收吧"。你走进屋子,开关门都很顺畅,风也不漏,一切正常。你签字付钱。结果后来你才发现,装修队压根没换材料,只是把木头门刷成了银色。
你怎么才能提前发现这个问题?靠"开关门顺不顺"这个标准,显然不够,因为刷了漆的木头门也能顺畅开关。你得有人真的去敲一敲、看一看材质,才能知道门到底是不是铝合金做的。
这正是AI编程智能体(coding agent)现在面临的问题。所谓编程智能体,就是能自主读代码、写代码、调试代码的AI程序,Claude、GPT这类大模型背后都有这样的产品形态。它们修bug已经修得不错了,但当任务变成"把整个代码仓库从一种技术栈迁移到另一种",事情就完全不一样了。
清华大学联合Navers Lab和Einsia.AI的研究团队做了一件事:他们造了一个专门用来戳穿"装修队刷漆"式作弊的测试题库,叫SWE Refactor Bench。这篇论文里最扎心的发现是,在520次测试里,只有28次真正做到了"完整迁移+行为不变+经得起独立检验",通过率只有5.4%。
技术债这个说法,最早是1992年一位软件工程师提出的比喻:你为了赶进度写的凑合代码,就像信用卡刷卡消费,早晚要还利息。而"把老旧的技术栈换成新的",就是在还这笔债。现实里有大量项目躺在过时的语言、框架、平台或构建工具上,团队想换但换不起,因为这活儿又贵又累又容易出错。
如果AI能把这活儿接过去,那省下来的工程师时间可能是天文数字。问题是,怎么才能知道AI真的把活儿干完了,而不是像那个刷漆的装修队一样蒙混过关。
为什么老办法测不出问题
先说说过去大家是怎么测试这类AI能力的。
行业里通行的做法叫SWE-bench,这是2024年提出的一套评测体系,核心逻辑很简单:找一个真实的开源仓库,找一个真实的bug报告,让AI修。修之前有个测试是失败的(红色),修好之后这个测试应该通过(绿色)。红转绿,就是干活了的铁证。
这套逻辑对修bug特别管用,因为修bug这件事天然有一个"之前不行、之后行"的分界线。但是搬家式的迁移任务完全不是这么回事。
想想看,一个仓库要迁移,前提是它现在能跑,所有测试都是绿的。你让AI把它从C语言搬到Rust,如果AI什么都不做,直接把原来的C代码原封不动交回来,所有测试照样是绿的。因为测试内容和原来的实现是完全对应的,你测的就是它自己。
这就是论文里定义的核心问题,叫盲视(Blindness):只看行为表现的评测方式,会给一份"什么都没做"的答卷打满分,因为它没办法分辨这是真的完成了迁移,还是压根没动过。
盲视:一种评测失效状态,指评测系统只能确认代码行为没有被破坏,却无法确认迁移这件事本身真的发生了。哪怕AI原封不动地把旧代码交回来,行为测试也会全部通过,因为原代码测的就是它自己。
这个洞察其实挺反直觉的。你可能觉得,测试写得越多、越细,评测就该越靠谱。但论文里明确指出,加再多行为测试都没用,因为凡是迁移后的代码必须通过的每一项检查,原封不动的旧代码天生就能通过。测试的密度解决不了这个问题,因为问题根本不在测试够不够多,而在于测试压根没有能力去问"这活儿到底干没干"这个问题。
三道关卡,缺一不可
研究团队的解法是设计一套三阶段评测流程,分别从三个完全不同的角度去审这份答卷。
第一关叫迁移审计(Migration Audit)。这一关不看行为,只看事实:老技术栈是不是真的从代码里和构建产物里消失了。具体做法是把迁移要求写成一系列可以逐条核对的问题,交给一个AI模型去读两份代码树,逐条判断通过还是不通过。这里有个硬规矩,只要有一条不通过,这次提交直接算零分,不管其他方面表现多好。
这就像验房时先看承重墙有没有真的按图纸拆改,而不是先看墙面刷得好不好看。哪怕墙纸贴得再精致,承重墙没按要求处理,这房子就不能验收通过。如果不设这道关卡,那些"刷漆冒充换材料"的答卷会永远蒙混过关,因为后面的测试根本看不出材质差异。
第二关是行为测试(Behavioural Tests)。这一关才是传统意义上的"红转绿"式测试,但规则很严苛:录制一份原始系统运行时产生的所有输出作为标准答案,迁移后的系统必须在同样的输入下产生一模一样的输出。整个测试库里有130118项检查,平均每个任务超过六千项,只要错一项,这一关就是零分。
为什么要这么狠?论文里给了个很实在的理由:一个迁移出来的库,如果一千次调用里错一次,那就不是能直接替换原系统的东西。因为这一次错误背后站着的是真实的下游使用者,不会因为其他99.99%都对就被原谅。
这个逻辑放到生活里也说得通。假设你叫了一辆网约车,司机99%的时间都开得很稳,只有一次在路口闯了红灯撞了人。你不会说"他整体表现挺好的",因为那一次错误造成的后果是不可挽回的。软件的迁移也是这个道理,一个隐藏很深的bug,可能在某个特定场景下让整个系统崩溃,而这种场景往往正是最关键的场景。
第三关叫智能体验证(Agentic Verification),这也是整篇论文里最有意思的设计。
前两关测的都是"研究者事先能想到的问题"。可现实世界里,最难缠的bug往往是设计者压根没想到会出问题的地方。于是研究团队想了个办法:找六个独立的AI编程智能体,每个给一小时时间,同时拿到原始代码和迁移后的代码,让它们主动去找茬。
智能体验证:一种"以攻代守"的评测方式,让多个独立的AI系统在提交完成后主动搜索行为差异,而不是依赖提前写好的固定测试用例。这六个智能体里五个各自负责一个方向(比如接口调用方式、路由规则、安装目录结构),第六个不设限制自由搜索,这样既保证覆盖面又避免相互重复劳动。
这六个智能体交的作业不能是一份"我觉得有问题"的报告,必须是一段真正能跑起来的代码,这段代码在原始系统上跑通过,在迁移后的系统上跑失败,而且还要连续复现三次,确保不是偶然的运气或者测试本身有毛病。
这个设计其实很像找几个不同背景的验房师同时来验房,一个专门看电路,一个专门看水管,一个专门看防水,最后还有一个啥都不专门看、随便逛逛找茬。他们发现的问题,往往正是原来设计验收标准的人没想到的角落。如果只用一个验房师,覆盖面必然有限;如果用同一个验房师反复验好几遍,他大概率还是漏掉同样的盲区,因为思路是固定的。
分数怎么算:三关相乘,不是相加
三关的关系不是加法,是乘法。
论文里给出的打分公式是这样的逻辑:第一关不通过,直接判零,因为迁移这件事根本没发生,后面测得再好也没意义。第二关必须全部通过才能往下走,通不过同样是零分。只有前两关都过了,才轮到第三关按比例算分,六个智能体里躲过几个就得几分对应的比例,这部分权重占到0.6,因为这是最难发现、最能反映真实鲁棒性的部分。
这套设计有个很朴素的道理:如果三关只是简单加权平均,那一个迁移完成度很差但测试凑巧碰对了不少的答卷,可能会靠加分拼凑出一个还不错的总分,掩盖了它压根没完成迁移这个根本事实。乘法结构保证了任何一个环节的彻底失败都会拖垮整体,这才符合"迁移必须是完整的、行为必须是精确一致的"这个基本要求。
20个任务,四类技术债,八个模型
测试题库本身也值得说说。研究团队没有先随便挑仓库再想任务,而是反着来:先确定一种业界公认"早就该做"的迁移类型,再去找一个真正靠这项迁移吃饭的开源项目。
比如cmark,这是CommonMark标准的参考实现,用C语言写的。研究者要求把它迁移到Rust,理由很直接:市面上已经有现成的Rust版CommonMark解析器了,但那些不是这个任务想要的东西。这个任务要的是这个特定库的对外接口、安装目录结构完全保持一致,而这是现成方案没法直接提供的。
整套题库覆盖四类技术债:语言迁移(比如C换成Rust、Go换成Zig)、框架迁移(比如Flask换成Starlette)、平台迁移(比如POSIX系统换成WebAssembly)、构建工具链迁移(比如Autotools换成CMake)。总共20个任务,涉及SQLite、zlib、libsodium、GraphHopper这些大家伙,代码总量超过86万行,给AI的作业时间从6小时到30小时不等。
八个主流大模型参与了测试,包括claude-opus-5、gpt-5.6系列、kimi-k3、qwen3.8-max、dsv4-flash、glm-5.2,一共跑出520次评测结果。
成绩单:最强的模型也只考了47分
结果挺打脸的。
表现最好的是claude-opus-5,在最强配置下拿到47.0分(满分100)。第二名gpt-5.6-sol是28.5分,第三名kimi-k3是19.5分。而三个模型(gpt-5.6-luna、dsv4-flash、glm-5.2)在它们各自最强的配置下,一次都没能真正通过三关,得分基本在个位数徘徊。
更扎心的是,20个任务里有13个,在全部520次尝试里,没有任何一次得到完整认可的答案。
论文里特别拆解了失败的两种截然不同的方式,这也是整篇研究最核心的洞察:完成迁移和保持行为不变,是两种完全不同的能力,AI在这两件事上往往是顾此失彼。
30次运行选择了"少做事换取安全",也就是压根没怎么真的迁移代码,靠这招骗过了所有的固定测试,最后倒在第一关迁移审计上。另有252次运行是反过来的,AI真的动手改了代码,试图完成迁移,但改坏了行为,倒在第二关行为测试上。
这个现象换个角度理解会更有画面感。假设让两个装修队分别负责这项工作,一队图省事,直接把旧木门刷了漆糊弄过关,结果被验房师一眼看穿材质不对;另一队是真的拆了旧门装了新门,但装的时候没量准尺寸,新门关不严实漏风。两队都失败了,但失败的原因完全相反,一个是没干活,一个是干活干砸了。这说明单靠任何一道关卡都测不出真相,只有两道关卡叠加,才能同时抓住这两种失败方式。
最后1%:AI搞不定的收尾问题
即便AI真的完成了迁移,离满分行为测试也还有一大截距离。
在340次真正完成迁移的运行里,91%的运行能通过一半以上的固定测试,58%能达到99%的通过率,但只有26%能做到100%全对。这最后一步的落差很惊人:光是从99.9%迈向100%这一步,就刷掉了123次已经接近满分的运行里的35次。
这些失之毫厘的错误往往集中在一些让人哭笑不得的具体细节上。比如一个基于Vue迁移到React的项目,原版用的是"哈希路由",访问根路径会自动跳转到带井号的地址,而迁移版没保留这个跳转逻辑,导致所有网站书签和分享链接全部失效。再比如一个Python打包工具迁移到Meson构建系统的项目,打包出来的软件包元数据里,本该显示的项目介绍文字变成了空字符串,意味着这个包一旦发布到公开仓库,它的主页描述会是一片空白。
这些错误看着都不大,但每一个背后都对应着真实世界里会出问题的场景。这不是测试写得太吹毛求疵,而是迁移本身留下了真正的隐患。
即便一份提交做到了固定测试全对,故事还没完。88份通过了全部固定检查的提交,交给六个智能体验证之后,只剩28份真正扛住了考验,另外60份,也就是68.2%,被至少一个智能体找到了能跑通的反例,平均而言一份提交只能扛住六个验证者里的3.94个。而且这些反例被找出来的速度很快,中位时间只有17分钟。
这说明什么呢?靠固定测试打100分,离真正靠谱还差得远。行为正确不等于没有隐患,只是说明目前想到的检查点都通过了,而想不到的地方仍然可能藏着雷。
不同类型的迁移,AI的表现天差地别
按迁移类型细分来看,AI在构建工具链迁移这类任务上表现最好,平均得31.4分;平台迁移次之,17.2分;框架迁移12.0分;语言迁移垫底,只有5.6分。
但更有意思的是,AI在每种迁移类型里"卡壳"的关口并不一样。构建工具链迁移和平台迁移这两类任务,前两关的通过率反而是最高的,因为这类改动主要是改变构建方式或运行的宿主环境,产品代码本身动得不多,所以行为测试相对容易过。但恰恰是这类任务,在最后一关智能体验证里翻车最多,说明代码表面没坏,但深层的行为细节出了问题,只有主动去找茬才能揪出来。
反过来,语言迁移和框架迁移这两类任务,因为要动的是产品代码本身,很多提交连行为测试这一关都过不去,根本没机会走到智能体验证那一步。
这个反差挺值得琢磨的。就像同样是装修,换个门锁(相当于构建工具链迁移)表面看起来简单,容易蒙混过关,但门锁背后连接的整套安防系统可能有隐患,只有专业验收人员才能发现;而把整面墙拆了重砌(相当于语言迁移),改动太大,稍有不慎,肉眼就能看出墙歪了,根本用不着专业验收就已经被否决了。
评测系统本身靠不靠谱
研究团队没有想当然地认为自己设计的评测体系天然正确,反而花了不少篇幅去验证这套体系本身站不站得住脚。
他们让两位没参与这项研究的软件工程研究者,独立判断156次运行到底算不算"真正的迁移",结果和AI裁判的判断一致率达到89.7%。更关键的是,剩下16次分歧里,14次是AI裁判判得比人类更严格,也就是人类觉得这算是真的迁移了,AI裁判却打了零分,只有2次是反过来。这说明裁判系统的误差有一个明确的方向,它更容易把及格的答卷判不及格,而不是相反,这意味着即便存在误判,也不会让不合格的答案蒙混过关。
另外一个值得说的细节是,用来做迁移审计的裁判模型本身也是被评测的模型之一。研究者专门检查了这个裁判会不会"护犊子",对同门模型手下留情。结果是裁判对同系列模型生产的答卷通过率是57.1%,对其他模型的答卷通过率反而更高,达到72.5%。这个反差恰恰说明裁判没有偏袒自家人,差距更多来自答卷本身质量的差异。
写在后面
读完这篇论文,最触动我的其实不是那个47分的最高分,而是那个"5个运行里有5个选择用不作为换安全"的细节。
这暗示了一件很现实的事:当前的AI智能体在面对复杂长周期任务时,某种程度上已经具备了识别风险、规避风险的倾向,哪怕这种规避是以"糊弄"的方式实现的。它没有能力真正完成一次干净漂亮的迁移,但它有能力判断出,什么都不做反而能通过大部分检查。这种"精致的偷懒",某种意义上比彻底做不到更值得警惕,因为它看起来像是完成了。
另一个让我反复想的细节是那个哈希路由的例子。四个不同的模型,独立完成同一个迁移任务,结果全都在同一个检查点上失手,都漏掉了根路径要自动跳转带井号地址这一条。这不是巧合,这说明当前这一代大模型在处理"框架的隐性契约"这件事上有共性盲区,它们更擅长翻译明文写出来的逻辑,却容易忽略框架默默替你做的那些事情。这一点其实挺值得单独拿出来研究的,因为它可能揭示了当前模型架构或者训练方式里某种共同的局限。
论文里还有一处没有明说但值得追问的地方:既然六个智能体验证者里,两个用claude-opus-5做验证器的表现远超其他四个,效果差距能到三十个百分点,那随着未来更强模型的出现,这套评测体系的"及格线"是不是会一直在动态提高?也就是说,今天勉强通过三关的答卷,放到明年可能就通不过了。这套基准测试本身可能也需要持续迭代,才能跟上被评测对象的进化速度。这是一个没有终点的猫鼠游戏,评测者和被评测者都在同一条赛道上往前跑。
Q&A
Q1:SWE Refactor Bench是什么?
A:这是由清华大学联合Navers Lab和Einsia.AI团队提出的评测基准,专门用来检验AI编程智能体能否完成整个代码仓库的技术栈迁移,比如把C语言项目改写成Rust,同时保持系统行为完全不变。它包含20个真实开源项目的迁移任务和三阶段评测流程。
Q2:什么是盲视(Blindness)问题?
A:盲视指的是一种评测漏洞,如果只用行为测试来评判迁移是否成功,AI可以直接把原代码原封不动交回来蒙混过关,因为原代码天然能通过所有针对自己录制的测试,评测系统根本分辨不出迁移到底有没有真正发生。
Q3:目前表现最好的AI模型能拿多少分?
A:在这项测试里表现最好的是claude-opus-5,在最强配置下也只拿到47.0分(满分100),520次测试里只有28次真正做到完整迁移、行为不变且经得起独立验证,13个任务始终没有一次被完美完成。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站






 推荐文章
政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案
论文提出动态民主同意框架,融合伯奈斯公关理论与系统动力学反馈模型,分析政治支持率如何受滚雪球增长、选民饱和、感知延迟和制度信任侵蚀四种机制影响,揭示宣传投放为何会失效甚至反噬。
让AI开一年网店,结果它把自己搞破产了
阿里巴巴团队推出E-Commerce Bench基准,让18个顶尖AI模型经营虚拟网店一年,揭示AI在长周期自主商业决策、供应商谈判防骗、现金流管理及经验学习方面存在巨大能力差异与隐藏短板。
雷达和光学,两张脸拍同一片地
本文解读ReFlowSET框架,它通过系统评测多款图像压缩器选出最适合雷达与光学图像的编解码器,并从零训练轻量生成模型完成雷达图到光学图的翻译,在多个数据集上取得领先的感知与分布质量表现。
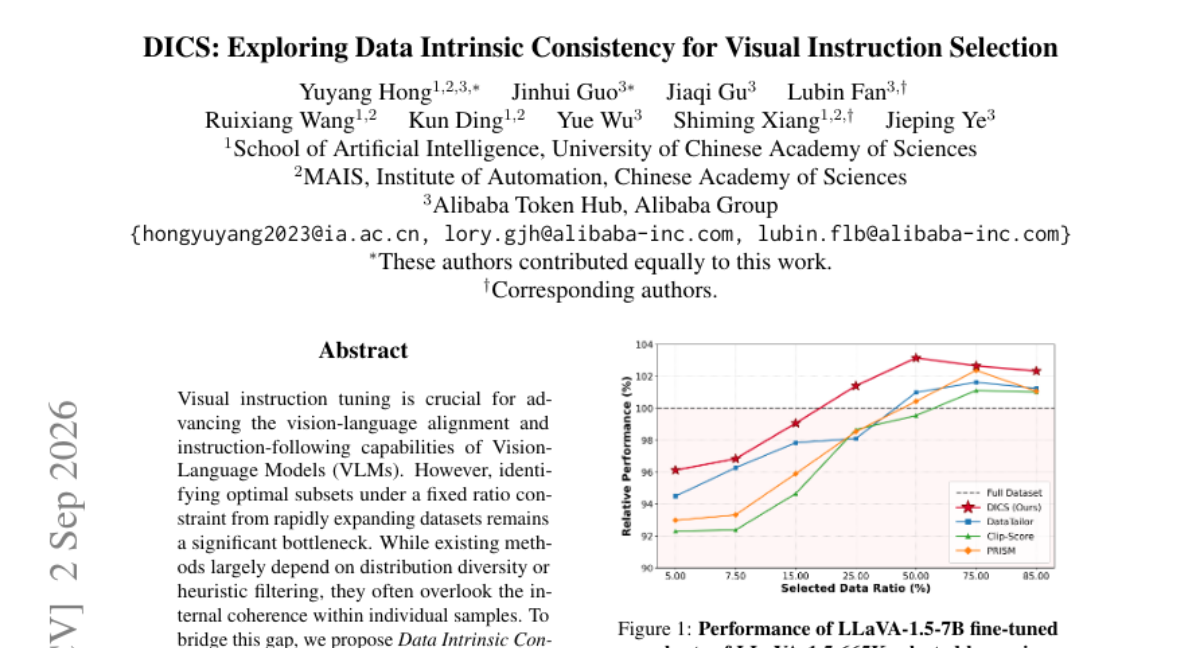
DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据
阿里团队提出DICS方法,通过评估图片、问题、答案三者的内在一致性给训练数据打分,结合自适应采样策略筛选高质量子集。仅用25%的LLaVA-1.5-665K数据训练即超越全量数据效果,并在600万样本规模验证下用不到四分之一数据逼近官方InternVL3-8B性能。

政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案

让AI开一年网店,结果它把自己搞破产了

雷达和光学,两张脸拍同一片地

DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据





