

 微信扫一扫,关注公众号

科技行者

算力行者


见证连接与计算的「力量」

血液里的秘密,为什么医院不敢把数据交给AI


2020年前后,如果你去医院抽血做个常规检查,报告单上会列出十几项数字:血红蛋白多少、白细胞多少、血小板多少。医生看一眼,大多数时候只会盯着那么两三个指标。
但这份看似普通的化验单里,可能藏着医学界还没发现的诊断线索。
这不是猜测。中性粒细胞和淋巴细胞的比值(中性粒细胞与淋巴细胞计数之比,一种衡量身体炎症状态的简单算法)这类指标,已经被证明和多种疾病相关,而且便宜、普及、不需要额外抽血。问题是,血常规报告里有十四项基础指标,理论上能组合出来的算式超过二十六万亿种。人工一个个试,一辈子也试不完。
这时候你可能会想,那就让AI来试啊。现在的大语言模型查文献、提假设、做实验设计样样在行,让它去暴力搜索这二十六万亿种组合,找出最有诊断价值的那几个,不就行了?
想法没错,但卡在了一个谁都不愿意松口的地方:医院的病历数据碰都不能让AI碰。
这篇来自哈佛医学院、Clalit医疗集团等机构的研究,就是在解决这个两难问题。他们手里握着以色列Clalit医疗系统超过540万人的病历,这是一座信息的金矿,但按照隐私法规,这些数据一步都不能走出医院的防火墙。而像Gemini 3 Pro、GPT Deep Research这些能跑复杂推理、能查文献的前沿AI模型,恰恰因为部署在医院内部网络的限制,根本碰不到。
一边是宝贵但出不了门的真实世界证据,一边是聪明但进不了门的AI大脑。这篇论文想做的事,就是搭一座桥,让两边都不用妥协。
数据不能出门,那就只放"知识"出门
研究团队的解法听起来有点像"炼丹":先在医院内部,把540万病人的数据蒸馏成一个轻量级的打分模型,然后只把这个打分模型的参数发布出去,病人的任何原始信息都留在院内。
具体怎么做的?他们针对十三种免疫相关疾病(比如系统性红斑狼疮、类风湿关节炎、1型糖尿病等),各自生成了大约两百万条随机的血常规算式。这些算式都是用血红蛋白、白细胞计数、血小板这些基础指标,通过加减乘除组合出来的树状结构,最多三层深,而且规定不能用任何数字常量,必须全由血液指标本身构成。
每一条算式在医院内部的病例对照队列上跑一遍,算出它区分患者和健康人的能力,用AUC这个指标衡量。
AUC:全称是受试者工作特征曲线下面积,是医学和机器学习里常用的一个分类效果指标,数值在0.5到1之间,0.5代表和瞎猜没区别,1代表完美区分,数值越高说明这个指标越能把病人和健康人分开。
有了两百万条"算式-得分"的配对数据,接下来就是训练一个图注意力网络(一种专门处理树状、图状结构数据的神经网络)去学习这个打分规律。关键在于,这个网络学的不是病人的具体数据,而是算式的结构和它对应分数之间的关系。训练完之后,导出的只有网络权重,病人的原始血液值、诊断标签,统统锁在医院里,永远不会被导出。
这就好比一家餐厅不愿意把祖传秘方的配料表给外人看,但愿意培训一个徒弟,让徒弟学会怎么评判一道菜好不好吃。配方本身没有泄露,但徒弟出师后,可以在外面帮任何人评估菜品。如果不这样蒸馏,而是直接把病历数据拿出去给AI训练,那涉及的是几百万人的隐私,一旦泄露后果不可逆。而蒸馏之后,即使有人拿到了这个打分模型,能看到的也只是"某种血液算式大概能打多少分"这类统计规律,没有任何一个具体病人的信息能被反推出来。
这个打分模型训练得准不准?研究团队用held-out(保留未参与训练的)测试集验证了一下,十三种疾病里,预测分数和真实AUC之间的斯皮尔曼等级相关系数(一种衡量两组排序是否一致的统计指标,数值越接近1说明排序越吻合)中位数达到0.93,最高的桥本甲状腺炎达到0.99。换句话说,这个打分模型虽然没见过一个真实病人,但它能相当准确地预测出一条算式"大概"能打多少分。
这个打分模型通过MCP(模型上下文协议,一种让AI模型能调用外部工具的标准接口)对外发布,变成了任何外部AI智能体都能调用的一个"打分工具":你给它一个疾病名和一条算式,它返回一个预测AUC,仅此而已。
AI负责想点子,内部数据负责打分
有了这个打分工具,接下来的问题是:怎么让AI真正用起来,并且确认它真的管用?
研究团队设计了两套测试。
第一套是自己搭的一个"提议-打分-精炼"循环。他们让一个AI研究智能体(用的是Opus 4.7 DeepResearch)先从文献里找出已知有效的血液比值作为起点,比如中性粒细胞与淋巴细胞的比值,然后不断提出新的候选算式,拿去让打分工具评分,分数高的留下来当下一轮的种子,循环最多十五轮。
整个过程里,AI看到的只有预测分数,从来没有机会接触到真实的外部验证结果。这一点很重要,因为这保证了评估的公正性:AI的每一步决策都是基于打分模型给出的反馈,而不是提前"偷看"了答案。
这就像蒙眼试菜。徒弟在后厨不断调整配料比例,师傅在隔壁房间尝一口告诉他"好一点"或"差一点",但从不告诉他具体好在哪、差在哪,更不会让他看到顾客的真实评价。只有等徒弟最终定稿,这道菜才会真正端给顾客试吃,打分和试吃是完全分开的两个环节。
循环跑完之后,研究团队才拿起始算式和最终发现的算式,拿到三个完全独立的外部队列上去验证真实效果,这些队列AI从头到尾没见过。结果显示,十三种疾病里,发现的算式相比起始算式,验证集上的AUC中位数提升了4.18个百分点。提升最大的是系统性红斑狼疮,从0.516飙升到0.676,提升了近十六个百分点,意味着原本接近瞎猜的指标,变成了一个有实际区分力的信号。
为了验证这个提升到底是不是打分工具的功劳,他们还做了一个对照实验:把打分工具换成一个纯随机打分器,分数在0.5到1之间瞎给,其他流程完全不变。结果呢,平均提升从5.84个百分点直接崩到0.07,十三次里只有四次碰巧有点正向提升,而且这几次的置信区间都和起始分数的区间重叠,说明纯属运气。这个对照实验非常干净地证明了,真正起作用的不是AI的创造力本身,而是打分工具提供的有效反馈信号。
第二套测试更有意思,研究团队没有用自己的循环系统,而是直接找来三个现成的前沿AI研究工具:GPT Deep Research、Gemini 3 Pro、SciSpace BM Agent,让它们各自针对每种疾病生成大约两百条候选算式。然后比较两件事:这些工具自己第一个给出的算式表现如何,以及用打分工具从这两百条里重新挑出来的最高分算式表现如何。
在81组有效比较中,打分工具重新排序选出的算式,有67.9%的情况比工具自己的首选更好,中位提升1.50个百分点。但这个优势并不是均匀分布的,在MIMIC-IV这个重症监护数据库上,打分工具赢了86.1%的比较,中位提升高达3.67个百分点;而在EHRShot这个斯坦福门诊数据库上,优势几乎消失,只赢了48.7%,和随机没有统计学差异。
这个差异本身就是一条重要信息。研究团队分析认为,EHRShot的样本量明显偏小,每种疾病平均只有47个阳性病例,统计功效本身就不足,检测不出细微的真实差异。这提醒我们一件事:任何声称"通用"的AI工具,效果都可能因为具体应用场景的数据规模和分布差异而大打折扣,没有放之四海而皆准的保证。
发现的算式,是真的懂医学,还是碰巧蒙对了
一个算式AUC分数高,不代表它背后的逻辑合理。研究团队担心的是,这些由AI搜索出来的算式,会不会只是在训练数据上过拟合,碰巧抓住了某种巧合规律,而不是真正反映了疾病的生理机制。
为了检验这一点,他们对每个发现的算式做了Shapley值归因分析。
Shapley值:源自博弈论的一种方法,用来公平地把一个整体结果拆分给每个参与的因素,在这里就是拆分出血常规里的每一项指标,到底对最终的疾病预测分数贡献了多少、是正向还是负向。
算出每个指标的贡献方向之后,团队把它和已有的临床文献一条条比对,分类成"符合预期"、"出人意料"或"不明确"三种。结果是,64个被检验的特征贡献里,41个符合已知医学规律,21个出人意料,2个证据不够明确。
符合预期的部分主要集中在一条清晰的生理轴线上:炎症性贫血。红细胞分布宽度升高、血红蛋白和红细胞计数降低,这套组合在慢性免疫性疾病里是教科书级别的表现。表现最好的两个算式,系统性红斑狼疮和类风湿关节炎,恰好也是生物学逻辑最干净的两个:前者六个成分全部符合预期,白细胞减少和贫血同时升高预测风险;后者六个成分里五个符合预期,核心驱动是红细胞分布宽度升高和血红蛋白降低。
但"出人意料"的部分也不能简单当成噪音忽略。它集中出现在几个表现较弱的算式里,比如溃疡性结肠炎,六个成分里有五个方向和文献不符,这很可能提示这些算式在训练队列上存在过拟合。研究团队也捕捉到了一个很有解释力的反常现象:平均红细胞体积升高在干燥综合征和系统性硬化症里都被预测为提高风险,这和这两种病的直接生理学关联不强,更可能反映的是患者常年服用甲氨蝶呤等药物导致的巨幼细胞贫血,或者是年龄因素造成的混杂。换句话说,AI学到的可能不是疾病本身,而是疾病背后隐藏的用药习惯或年龄分布。
这个发现挺耐人寻味。就像你想通过观察一个人的购物车来判断他是不是程序员,结果发现"买枸杞"这个特征预测准确率意外地高,细想才明白,这不是因为程序员天生爱枸杞,而是因为程序员普遍熬夜、普遍年龄偏大,枸杞只是这群人共同生活方式的一个代理指标,不是因果关系本身。如果不做这层归因分析,直接把高AUC的算式当成"发现"发表出去,很可能是在把统计巧合包装成科学发现。
一个诚实到近乎苛刻的自我审计
这篇论文有一处处理方式让人印象深刻,就是它不回避自己的局限,甚至专门设计了一套审计机制去挑自己的刺。
研究团队设定了一个"最终判定门槛":把AI循环搜索发现的算式,拿去和三个独立前沿工具提交的候选池里表现最好的那一个相比,只有超过这个最强对手,才算真正"过关"。
结果呢?在能找到对比对象的十个疾病运行中,全部十个都没能超过这个最强对手。
这是一个比前面那个"67.9%胜率"更严苛的标准。前面讲的重排序实验,问的是"打分工具能不能改善一个工具自己的排序";而这个审计门槛问的是"一次完整的十五轮盲搜索,能不能打败三个工具合并起来的最佳表现"。答案是不能。
研究团队没有把这个负面结果藏起来,反而专门写了一整段讨论它意味着什么:这说明目前的系统还没到能独立"碾压"顶尖AI工具联合输出的程度,它现在能做好的事情,是排序、筛选、提出假设,而不是无监督地产出可以直接拿去临床部署的生物标志物。
这种克制挺难得的。一篇论文做出一个有意思的结果之后,很容易把它包装成"颠覆性突破",但这篇论文选择老老实实地说:我们达到的是优化现有工具输出质量的水平,不是超越现有工具的水平。
还有一处细节也体现了这种审慎:团队发现,AI在搜索过程中偶尔会违反预设的算式深度限制(最多三层),生成了超出训练语法范围的、结构更复杂的算式。因为打分模型从没见过这么复杂的结构,它给出的分数本质上是一种"外推",可靠性没有保障。研究团队没有悄悄把这几个异常样本从结果里删掉,而是如实报告了它们,并且指出这五个超出语法范围的算式里,恰好包含了预测分数和真实验证分数差距最大的一个案例(系统性硬化症,相差14.8个百分点),也包含了唯一一个预测和验证方向相反的案例(银屑病,相差负4.9个百分点)。
这就像一个厨师在新菜单发布会上,不仅展示做得好的菜,还主动告诉顾客"这道菜我们试验时火候没完全控制住,大家吃的时候心里有数"。这种透明度本身,可能比那4.18个百分点的提升更值得记住。
隐私这道墙,真的守住了吗
整个方案成立的前提,是这个导出的打分模型本身不能泄露任何病人信息。研究团队对此做了专门的论证。
训练这个模型用的标签,不是某个病人的具体化验值,而是整个队列层面的统计量:某条算式在平衡后的病例对照子队列上算出的AUC。每个疾病的子队列规模从2390人到111835人不等,就算换掉其中任何一个病人的数据,对最终这个AUC标签的影响也小到大约千分之一,远远小于打分模型本身的预测误差(0.0030到0.0186之间)。
换句话说,就算有人拿到了这个发布出去的模型权重,想从中反推出某个具体病人的化验数据,技术上根本不可行,因为这个模型压根没见过任何单个病人的数据,它学的从头到尾都是"算式结构"和"群体统计量"之间的关系。这和那些直接用病人原始记录训练、因此存在被攻击者反推出训练数据风险的模型,是完全不同的安全等级。
这篇论文最终提供的,是一个思路上的范式,让锁在防火墙后面的医疗数据,能够以一种安全的、信息压缩后的形式,去指导外部AI工具的搜索方向,而不需要把任何一行病人记录真正拿出墙外。
写在后面
读完这篇论文,最触动我的其实不是那4.18个百分点的提升数字,而是那个"诚实的审计门槛"。
一篇论文愿意设计一套机制去主动证明自己"还没有超过现有最强方法",这种自我约束比吹嘘一个漂亮的平均提升值要难得多。很多AI+医疗的论文容易陷入一个陷阱:只报告赢的那部分比较,把输的那部分悄悄模糊过去。这篇论文选择把输赢都摆在桌面上,连MIMIC-IV和EHRShot两个队列之间巨大的效果差异都如实呈现,没有强行给出一个"平均来看我们更好"的笼统结论。
另一个让我反复琢磨的地方是那个Shapley归因分析里发现的MCV升高异常。表面上看是模型找到了一个"新发现",但深挖下去,发现背后更可能是药物副作用或者年龄分布在作祟。这提醒我,任何一个AI从海量数据里挖出来的"规律",哪怕统计上看起来再漂亮,都值得再问一句:这是疾病本身的信号,还是某个隐藏在背后的共同原因留下的影子。
这篇论文留了一个没说透的问题:如果把这套蒸馏打分的方法,从血常规这十四个指标,扩展到更复杂的化学检测、尿常规、甚至是影像数据,打分模型的训练成本和准确度会不会急剧恶化?毕竟十四个指标组合出来的算式空间已经是二十六万亿,换成几十上百个指标的多模态数据,这个数量级会膨胀到什么程度,谁也不知道。
Q&A
Q1:GAT打分工具是怎么在不接触病人数据的情况下帮AI评估血液生物标志物的?
A:研究团队先在医院内部用540万病人数据训练一个图注意力网络,让它学会从算式结构预测其区分病人和健康人的能力,训练完只导出模型权重,病人原始数据始终锁在院内,外部AI只能提交算式、拿到预测分数,接触不到任何真实病历。
Q2:AI发现的新血液算式真的比现有方法准吗?
A:在内部搜索实验里,发现的算式相比起始算式中位提升4.18个百分点,系统性红斑狼疮提升最明显,但在外部独立验证中效果因数据集不同而差异很大,MIMIC-IV上表现好,EHRShot上几乎没优势,而且十个有对比对象的疾病中没有一个能超过三个顶尖AI工具联合输出的最佳结果。
Q3:这种打分工具如何保证不泄露病人隐私?
A:模型训练用的标签是整个队列层面的AUC统计量,不是个体病人数据,换掉任意一个病人对标签影响不到千分之一,远小于模型本身的预测误差,而且导出的权重只包含算式结构和分数的对应关系,无法反推出任何具体病人信息。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站






 推荐文章
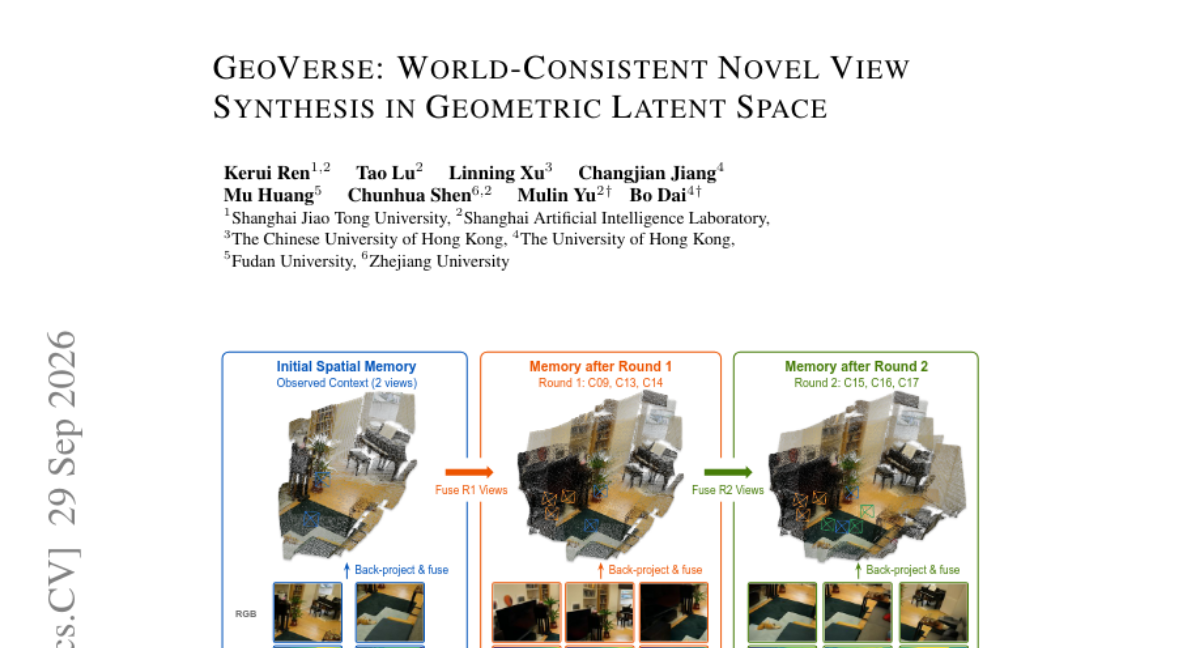
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。

GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏

TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗

AI模型能读懂自己学到了什么吗

AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





