

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

TalkingData:10亿移动互联网设备都说了什么?


“滴滴和快的到底谁的客户多?美柚和大姨吗到底谁活跃?去哪儿真的比携程大吗?”人们每天手持各种设备,却不了解整个行业。
这时候就出现了一个蓝本:10亿说。10亿,来自第三方数据服务提供商TalkingData所覆盖的移动设备,包括iOS、Android,包括智能手机、平板、智能电视等。根据设备每天产生的数据,得出用户行为报告。
这份报告就是TalkingData《2014移动互联网数据报告》。与其他数据报告不同之处在于,TalkingData CEO崔晓波大胆披露,其他的第三方数据公司也在发布报告,也在发布数据,但他们的目的好像更多的是为了盈利。
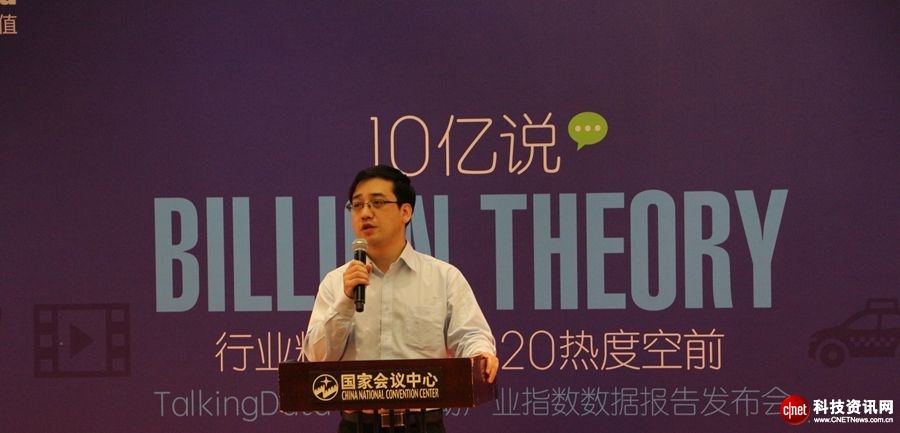
TalkingData CEO崔晓波
TakingData 数据服务部高级总监陶京琪指出,通过对分布式运算架构、海量数据处理、数据挖掘算法的长期钻研,大数据已经成为TalkingData骨子里的基因。
带着大数据基因,除定期发布数据报告外,更重要的是,TalkingData会发布一个移动数据观象台,并免费开放给整个行业,揭开这层迷雾,让大家知道所有数据的真相。该观象台已于2014年9月对外免费公布。
崔晓波进一步介绍:“这个产品,包括以前我们服务美国的基金客户,他们利用这些产品,观察中国的股市,再研究这些公司的动态。但今天我们想把它免费开放出来,最重要的是,我们希望建立一个比较健康的产业环境,让大家揭开这层迷雾,去看一看退潮之后底下到底是什么。”
实际上,从创建初,TalkingData就定位于“第三方的中立数据平台”,借助中立优势,TalkingData与国内众多机构紧密合作,汇聚大量移动互联网用户数据。目前TalkingData为超过50000款应用、游戏提供数据统计、分析服务,覆盖超过10亿独立移动设备;为招商银行、中信银行、平安保险等企业提供数据服务。
那么,10亿移动互联网数据都说了什么?
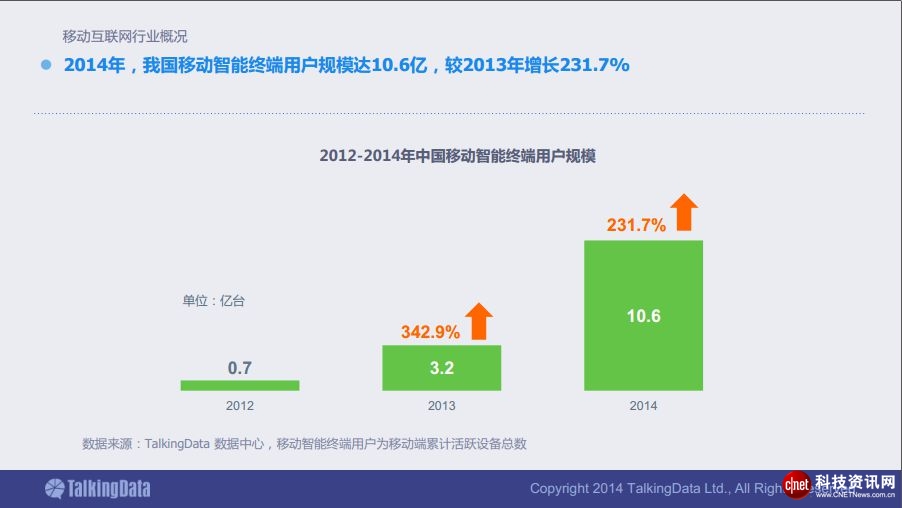
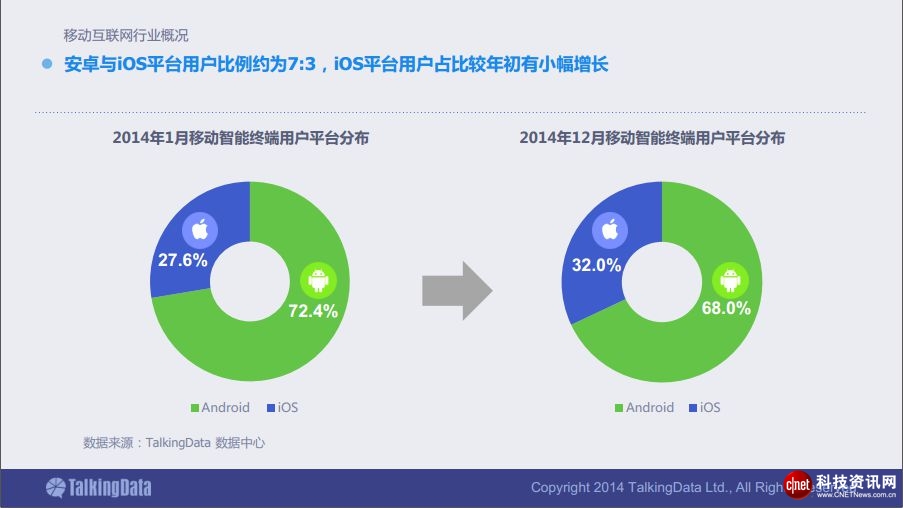
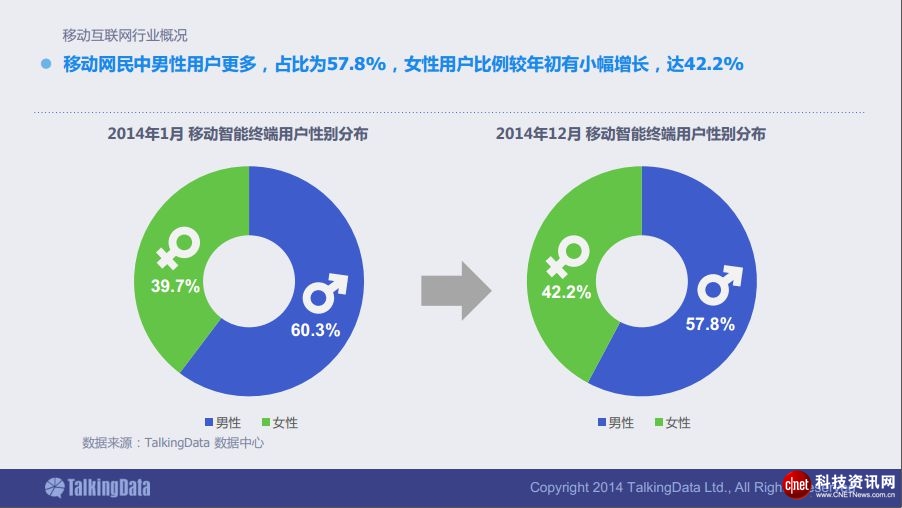
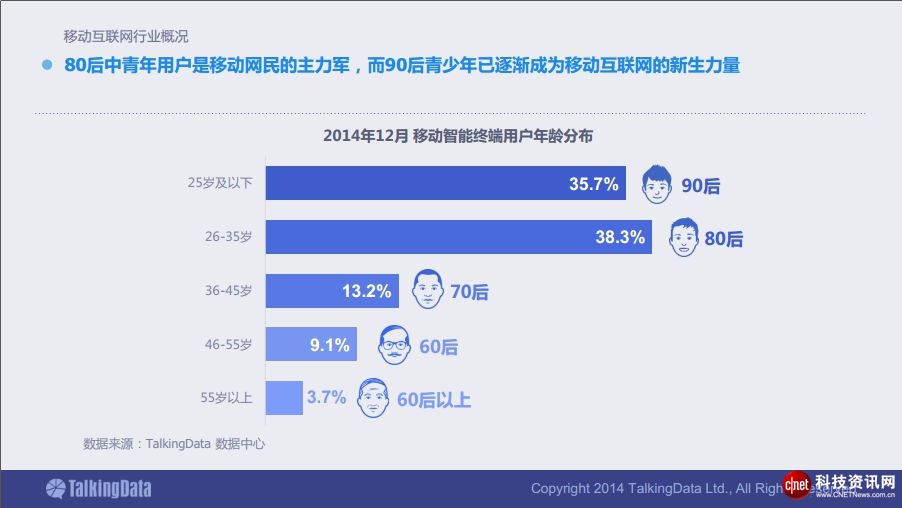
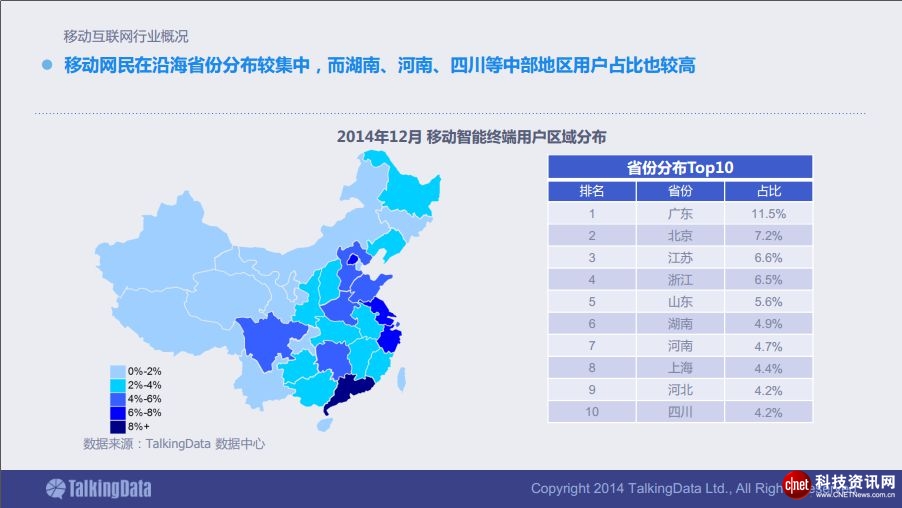
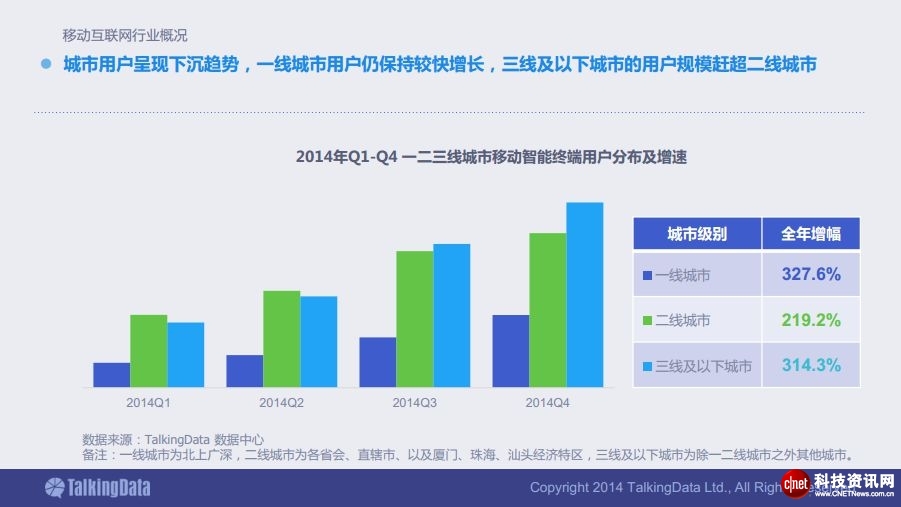
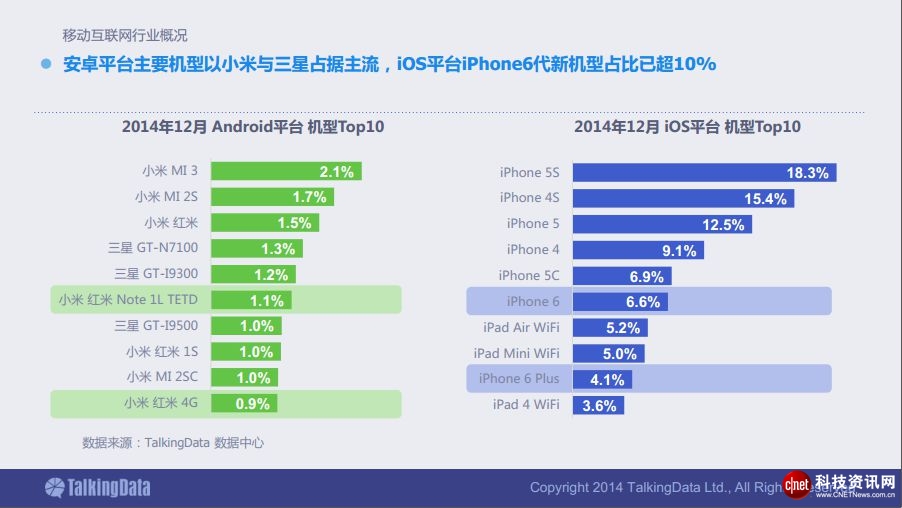
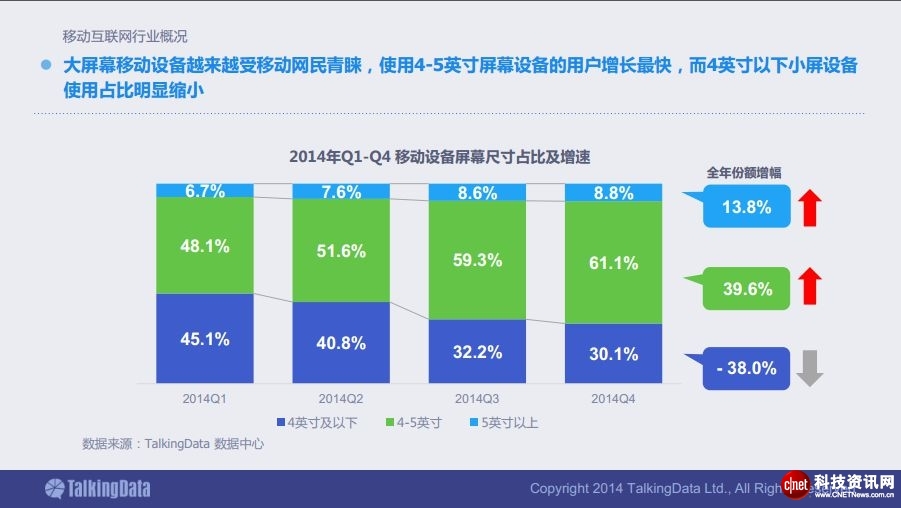
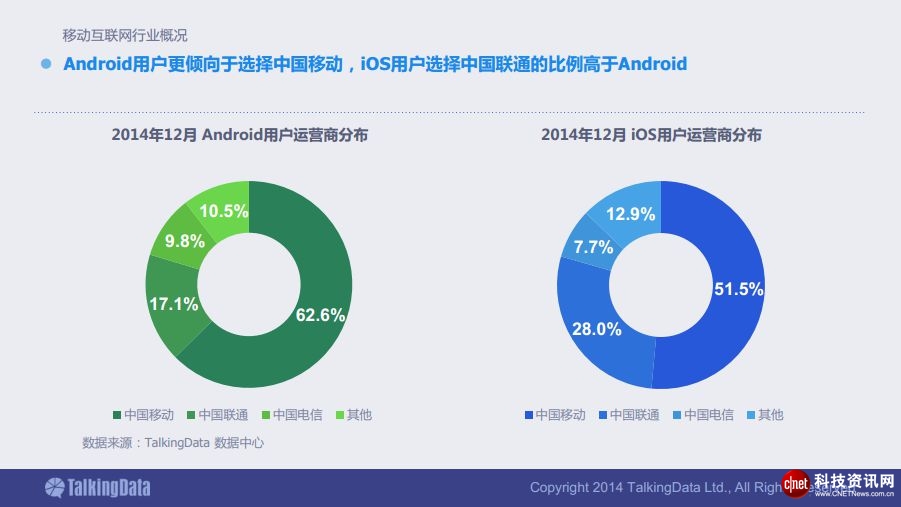
以上数据均来自TalkingData《2014移动互联网数据报告》,CNET从中摘取了一小部分,当然,也希望更多数据被TalkingData刷新。


 0赞
好文章,需要你的鼓励


至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
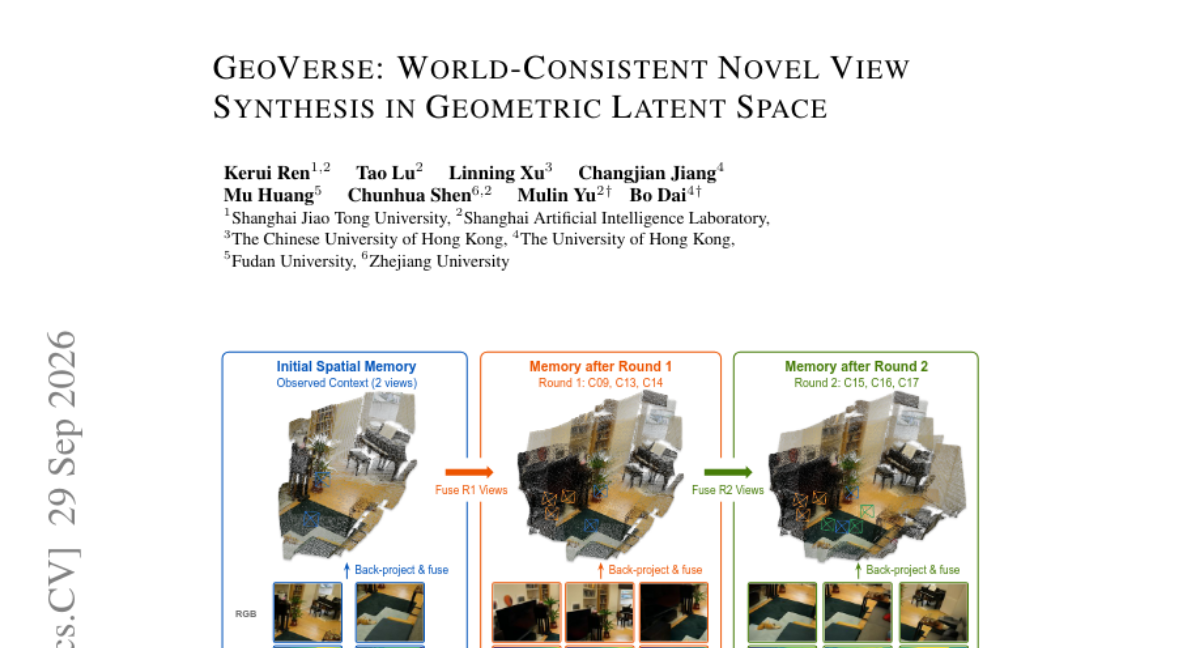
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
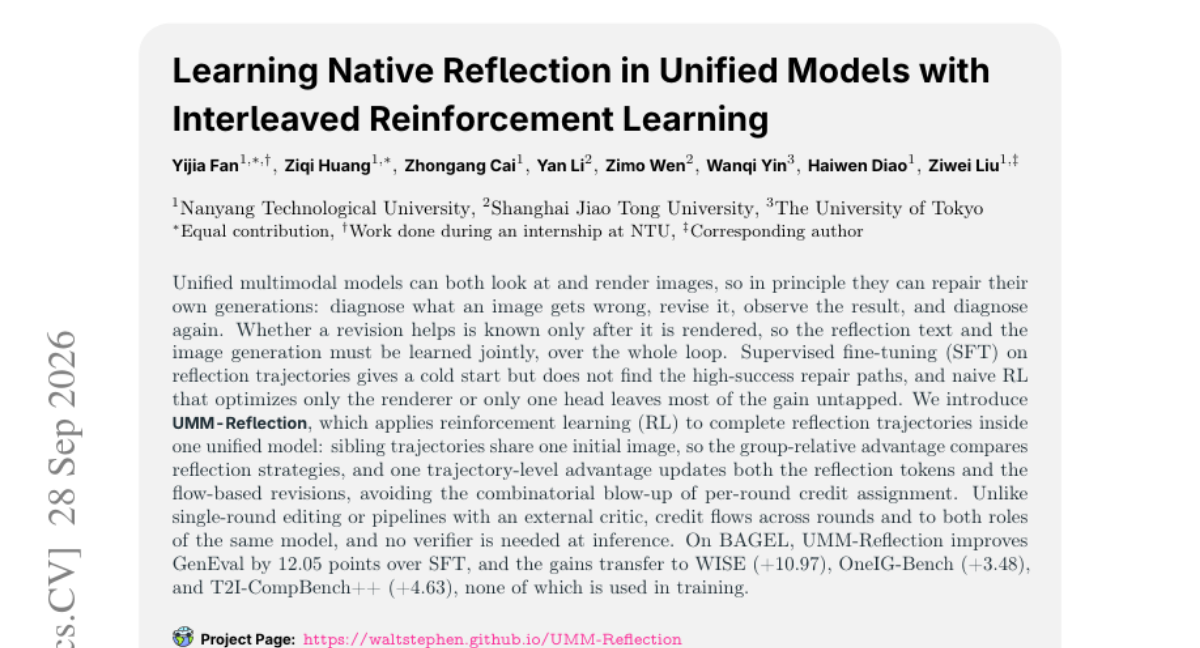
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
周雅
主编





