

 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

报告称Twitter用户最爱是视频 九成播放量来自移动设备


北京时间5月14日消息,据科技博客VentureBeat报道,Twitter委托市场调研公司Research Now发布的调查报告显示,Twitter用户热衷于观看视频,特别是在移动设备上。
报道称,为了掌握Twitter上的视频观看情况,Research Now对14个国家的用户进行了调查,每个国家调查的用户数量至少为1000人。
调查发现,大多数Twitter用户(82%)在Twitter上观看视频内容。其中,全球90%的Twitter视频是在平板电脑或智能机上观看的。Twitter用户观看的视频类型大致相同,64%的人喜欢观看突发新闻,54%的人喜欢观看体育节目集锦,50%的人喜欢观看电视节目集锦。
报告显示,在Twitter用户最希望看到的更多视频来源中,名人占比达到45%,然后是其它用户(40%)、品牌(37%)。
报道称,Twitter在此次调查中发现的最有价值数据可能是:70%的用户主要观看的是在他们的信息流中发现的视频,这意味着用户正在Twitter上挖掘新视频内容。对于考虑在Twitter上展开营销活动的广告商来说,这是一项关键参考数据。另外,只有11%的用户称他们在Twitter上使用搜索来寻找特定视频。
相比之下,只有20%的YouTube用户表示,他们主要观看的是在YouTube上发现的视频;63%的用户称,他们主要使用搜索来寻找YouTube上的特定视频。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章
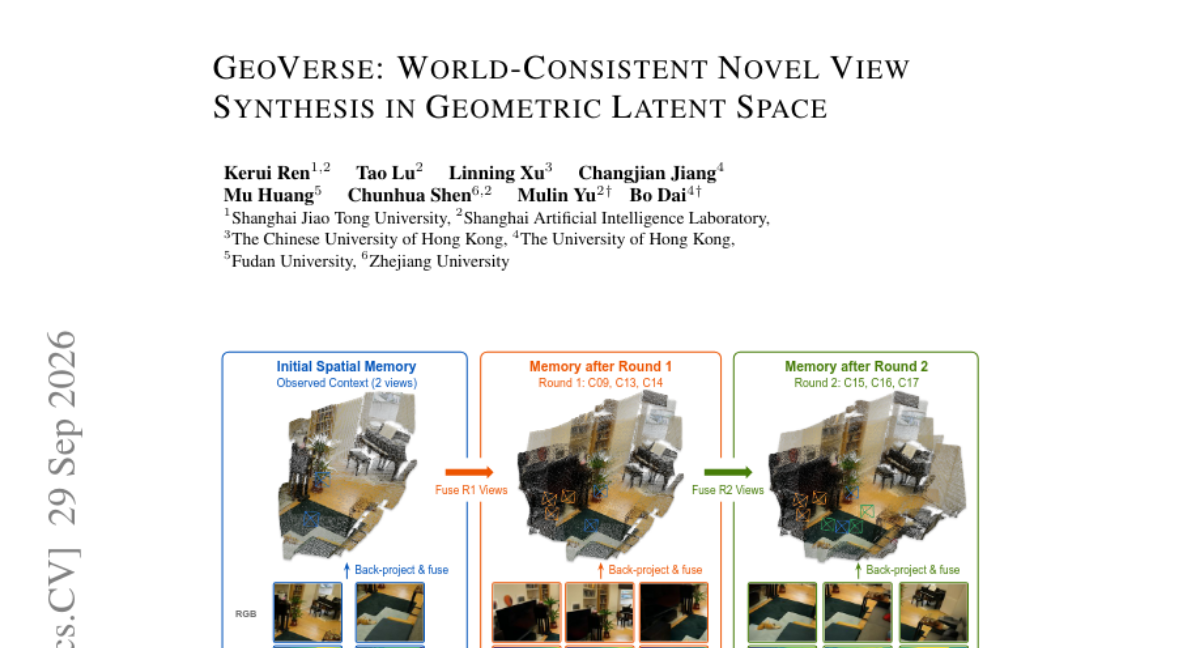
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





