

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

内存技术革命? AMD推高带宽内存HBM


近期,AMD在纽约举办的分析师大会(Financial Analyst Day)上展示了很多新产品与新技术,其中,HBM晶片堆栈式高带宽内存吸引了很多人的目光,AMD总裁兼首席执行官苏姿丰博士表示,HBM是真正能够以更高的带宽、更低的功耗来提供很好的效能。
HBM有何优势?它会何时推出呢?带着这些问题,我们采访了AMD事业群首席技术官(Business Unit CTO) Joe Macri,他表示,HBM在整个功耗降低方面做的非常好,它把所有节省的功耗用于补偿GPU核心的功耗;另外,数据传输的带宽大约是每秒100GB。
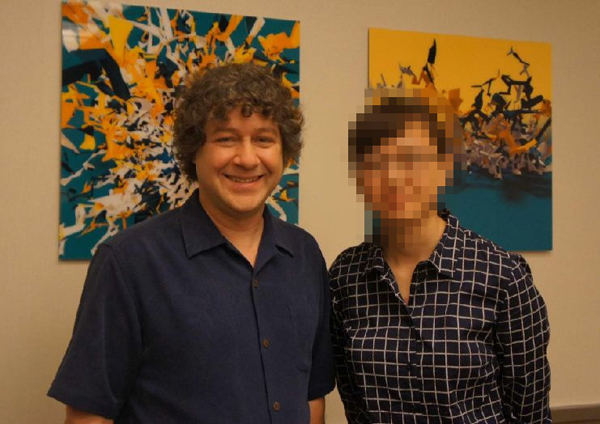
图为AMD事业群首席技术官(Business Unit CTO) Joe Macri
AMD开发HBM已经有7年的历史了,是什么原因使得AMD对HBM产生了这么大的兴趣?Joe Macri表示,如今很多系统的问题是功耗较大,很多高端显卡的功耗在250w-300w之间。有时会碰到一种极限,当GPU性能已经很高时,功耗也非常高,内存的功耗也变得非常高,那是一个非常可怕的事情,会造成整个系统热量非常大,功耗很高,但是性能提升却有限。很多时候为了保持系统功耗的平衡,内存功耗很高的话,GPU的功耗就不可以很高,这样会直接影响到GPU的性能。而AMD就想要生产出高带宽、低功耗的内存,这样就可以平衡整个系统的性能和功耗。
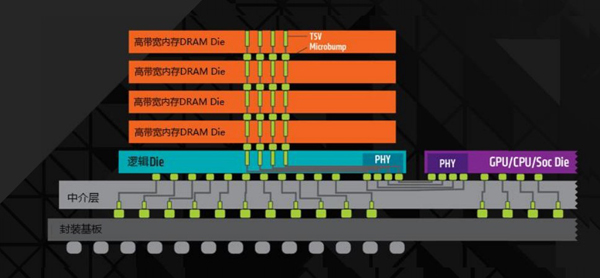
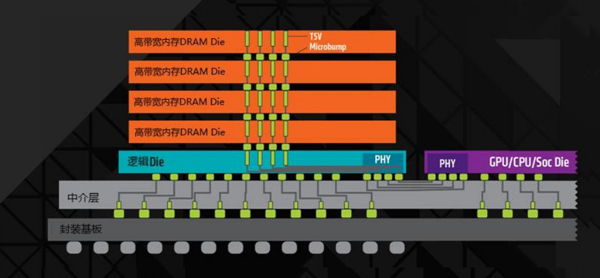
如上图所示,垂直的“四条线”是比较有功能性的DRAM的堆栈,这也是HBM整个内存的晶片构造,出自SK Hynix。左边蓝色的是整套SK Hynix内存的HBM晶片,右边是AMD GPU的晶片。Joe Macri表示,通过1024位连线进行联系,有非常高速的硅晶片的铜联线来进行数据交互,数据非常大且速度非常快,这是不能通过主板来解决的,必须通过这种联线来做到,另外,HBM能够与CPU/GPU封装在一起。
HBM真正实现了低功耗和高带宽,它的外形很小,并且可以把更多的功耗转移到GPU,而且很多用途可以并到HBM,除了独立显卡和游戏以外,像HPC超级计算机、高性能计算、电信、服务器、还有所有类型的PC都会从中受益。
我们所熟悉的DDR5与HBM相比有很大的区别,就是带宽上很不一样,DDR5是32位,HBM则是1024位。Joe Macri解释道,最重要的是它的时钟频率,DDR5是1750兆赫兹,每秒7GB的数据传输量;HBM的整个速度降低得非常快,最高才到500兆赫兹,1GB数据传输量,速率的降低大量地节省了功耗,这是最重要的一点。而整个数据传输的带宽,DDR5是28GB每秒每个芯片,HBM大约是每秒100GB,它的功耗也大大降低了,但是由于整个位宽比较高,所以整个数据传输的带宽是非常高的,大概是过去的5倍。
Joe Macri表示,AMD在建立一个HBM的完整的生态系统,主要包括DRAM、组装和封装、芯片测试。AMD是第一家开始做HBM的公司,不过随后一定也会有其他公司陆续加入。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
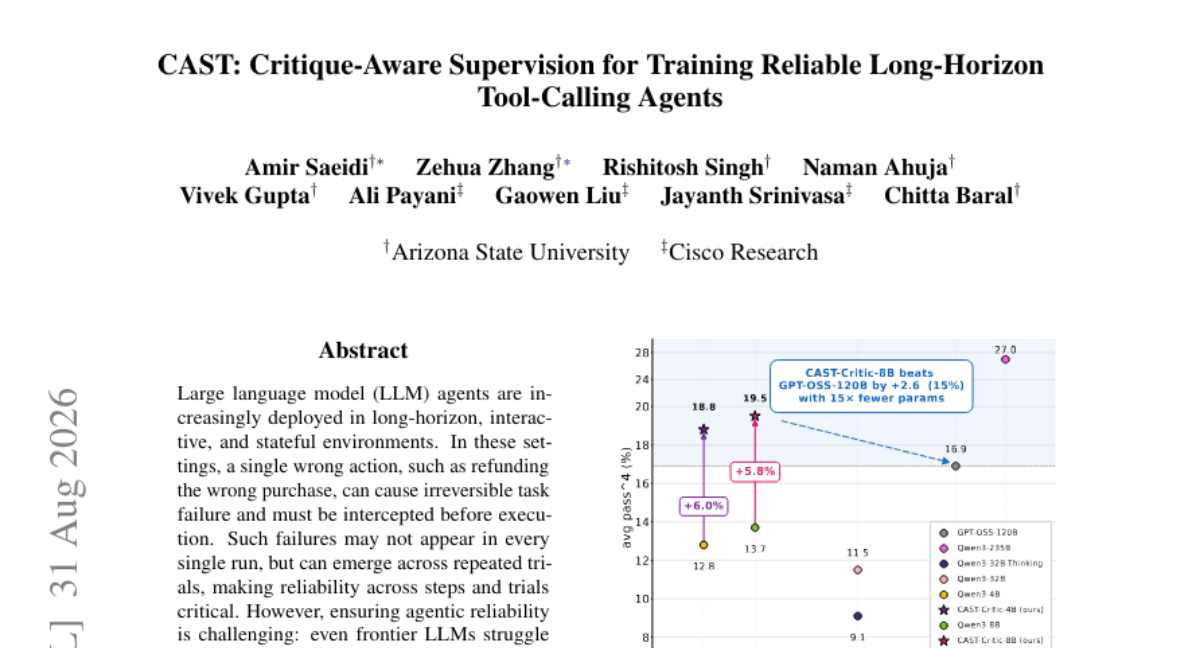
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
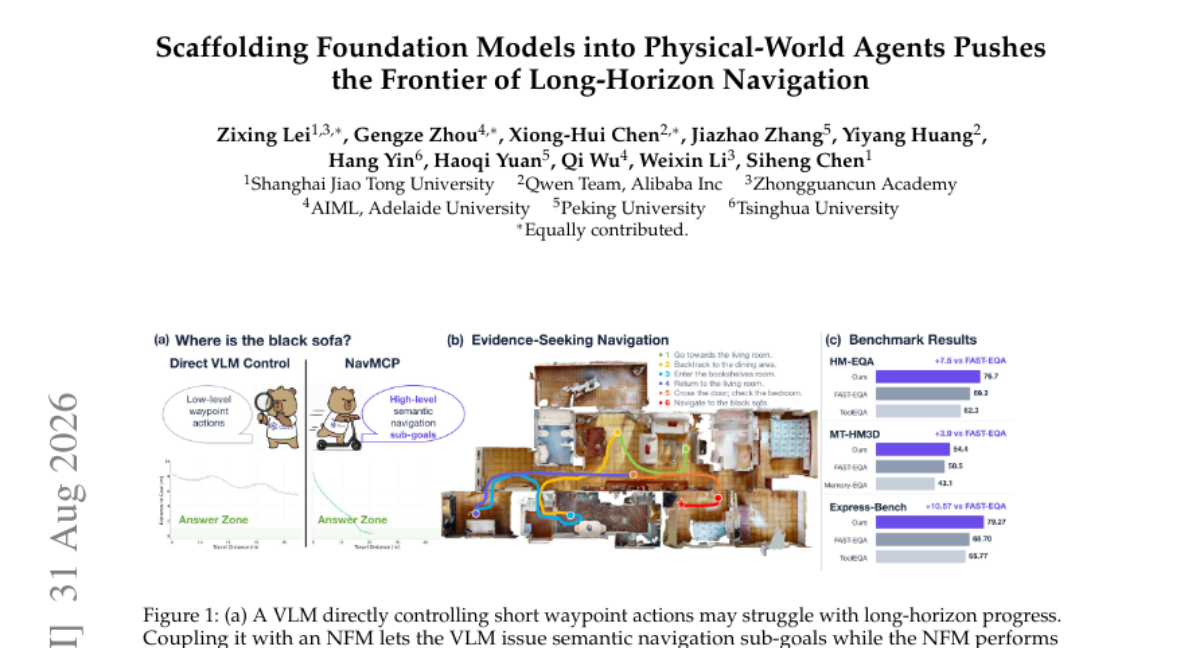
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
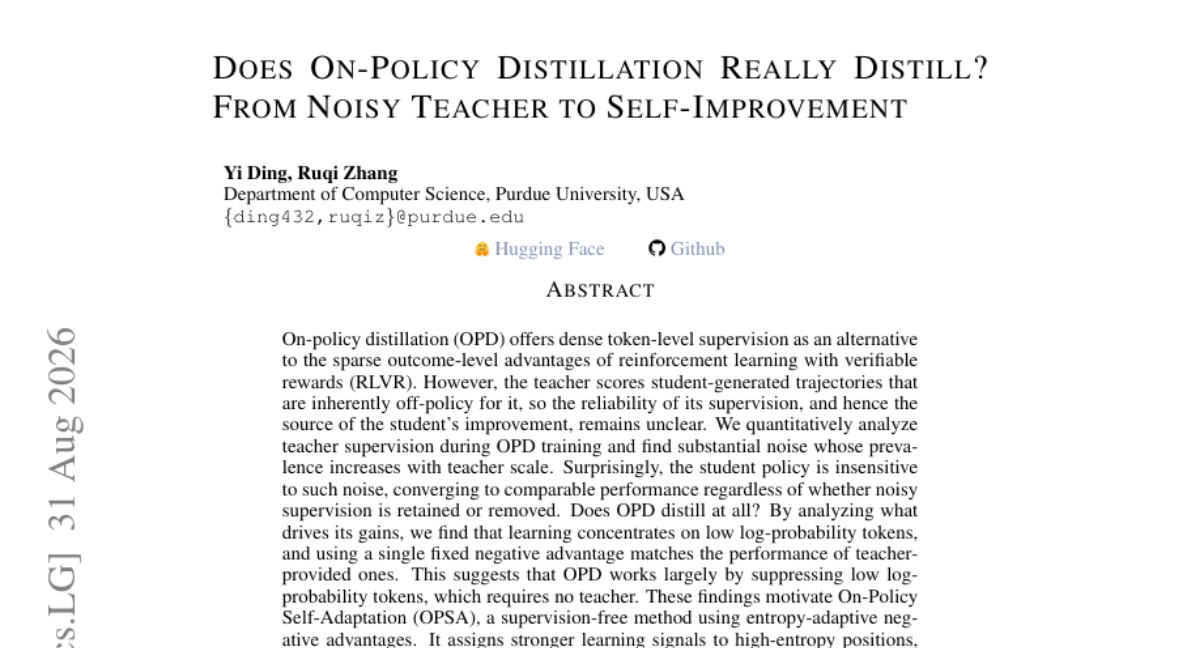
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
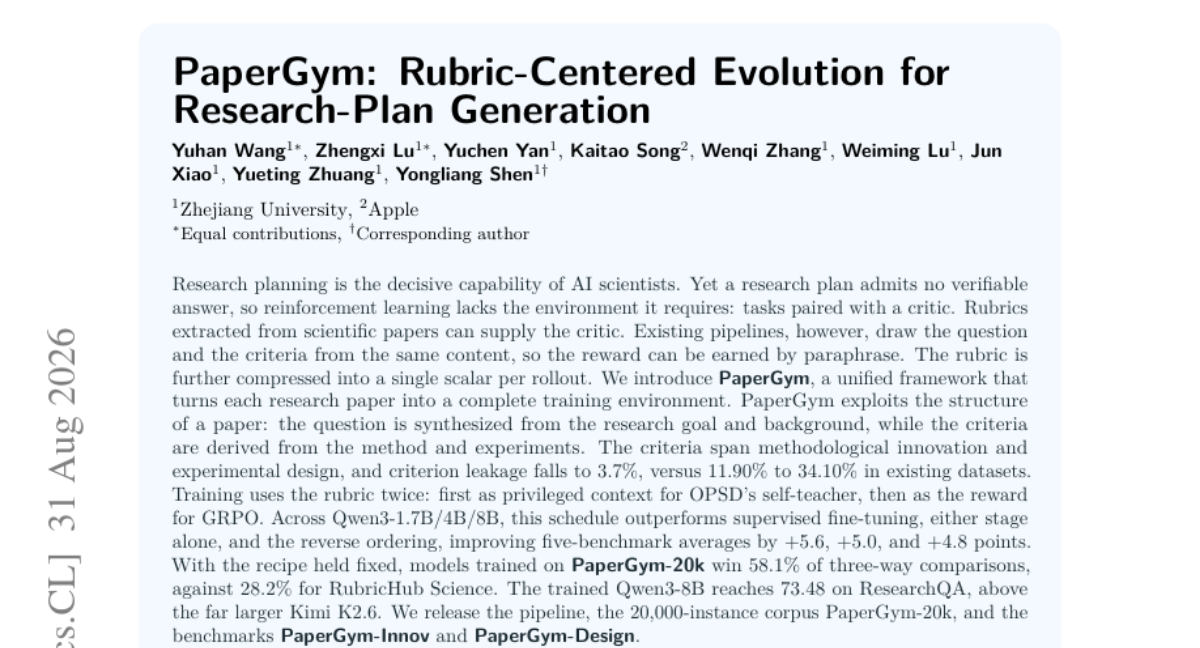
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
当机器人学会走路,却依然找不到答案
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
让AI给自己出考题:科研计划训练里那个作弊漏洞





