

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

T11 2019数据智能技术峰会举办 AI将成为行业颠覆者


科技行者 11月26日 北京消息:当前,数据的价值日益凸显,已成为重要的生产要素和社会财富。云计算、人工智能、5G等技术的蓬勃发展,带来了智能化时代算力的提升。以数据为“能源”、以技术为“引擎”,才能将数据转化为智能,产生突破局限、跨越发展的力量。
11月25日,T11 2019数据智能技术峰会在北京举办。TalkingData正式宣布了2019年的最新战略布局,以数据平台为支撑,借助大数据技术积累与人工智能技术创新,聚焦不同行业场景需求,并在选址、预测、个性化推荐等方面进行深入应用,以数据和科技的力量驱动发展。
新战略布局发布,以数据和AI之力引领升级
TalkingData CTO 王亭与合伙人兼首席架构师黄洋成首先分享了对大数据与人工智能技术发展现状与趋势的深刻认识,并详细解读了TalkingData近几年的相关探索实践。王亭表示,当前企业数据服务尚属早期市场,60%企业有超过一半的Dark Data没有利用,处理庞大数据和多样数据化关联和分析仍然是巨大挑战。而AI将成为企业市场的技术颠覆者,但在数据、模型及工程等方面的门槛阻碍其进一步发展。
在此背景下,TalkingData从战略层面对旗下数据平台和营销平台进一步升级。一方面,为伙伴企业提供数据接入、集成治理、增值开放的平台服务;另一方面,基于平台能力,面向市场营销和运营人员,提供数据分析、数字营销的智能应用,进行数据连接、客群细分、同步投放、效果监测的营销全场景覆盖。另外,通过数据分析和智能算法模型,服务不同行业场景需求,进一步打通从选址运营、到销售预测再到个性化推荐的应用流程。
行业大佬论道AI,场景落地是关键
大数据时代,数据体量越来越大,对于数据的综合处理和分析能力要求也越来越高。峰会上,英特尔(中国)数据中心集团渠道业务技术总经理李悦阐述了英特尔以数据为中心的发展战略和技术,并对其在人工智能发展历程中的价值进行了深入分析。此外,涛思数据联合创始人李广分享了自研物联网大数据处理平台TDengine及其应用场景案例。大数据释放出的价值为很多行业带来了颠覆性影响,ARK Federation联合创始人兼董事长张文新分享如何用数据驱动美学,提升视觉设计与千人千面的用户体验。
以“AI是否能带来真正的价值”主题的圆桌论坛由AI 媒体超神经 HyperAI 执行主编袁滚滚主持,邀请英特尔(中国)首席工程师和人工智能技术中国首席架构师夏磊、ARK Federation联合创始人兼董事长张文新、涛思数据联合创始人李广与TalkingData CTO王亭,共同针对AI技术适合在哪些场景落地、在企业端应用的挑战等话题展开了精彩对话。
大数据技术实战与AI的实用技术之旅
在下午的主题演讲中,TalkingData研发总监韩广利、资深架构师徐岷峰、资深架构师赵志刚以及架构师肖强分享了大数据从收集、处理到分析、应用及安全合规的全流程实践,以一线丰富经验为开发者和技术人提供有价值的参考。
开源项目在业内有广泛的应用基础,南京大学计算机系副研究员顾荣在演讲中深入介绍了开源AI和大数据存储编排平台Alluxio的基本原理、Alluxio 2.0的新特性,以及国内开发者社区对Alluxio缓存优化方面所做的贡献。
2018年,人工智能进入商业化元年。2019年,随着数据和算力的不断提升,AI技术正逐渐步入成熟期。TalkingData首席数据科学家张夏天在演讲中分享了对AI应用场景方法论的深入思考,并首次解读了TalkingData在需求预测场景下的AI技术实践与产品。
T11暨TalkingData数据智能峰会创办于2015年,是由TalkingData主办的业界盛会。本届峰会设置数据智能峰会与数据智能技术峰会两大会场。技术会场重点关注大数据与人工智能技术的创新发展,分享技术实战经验和各行业场景中的创新应用。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
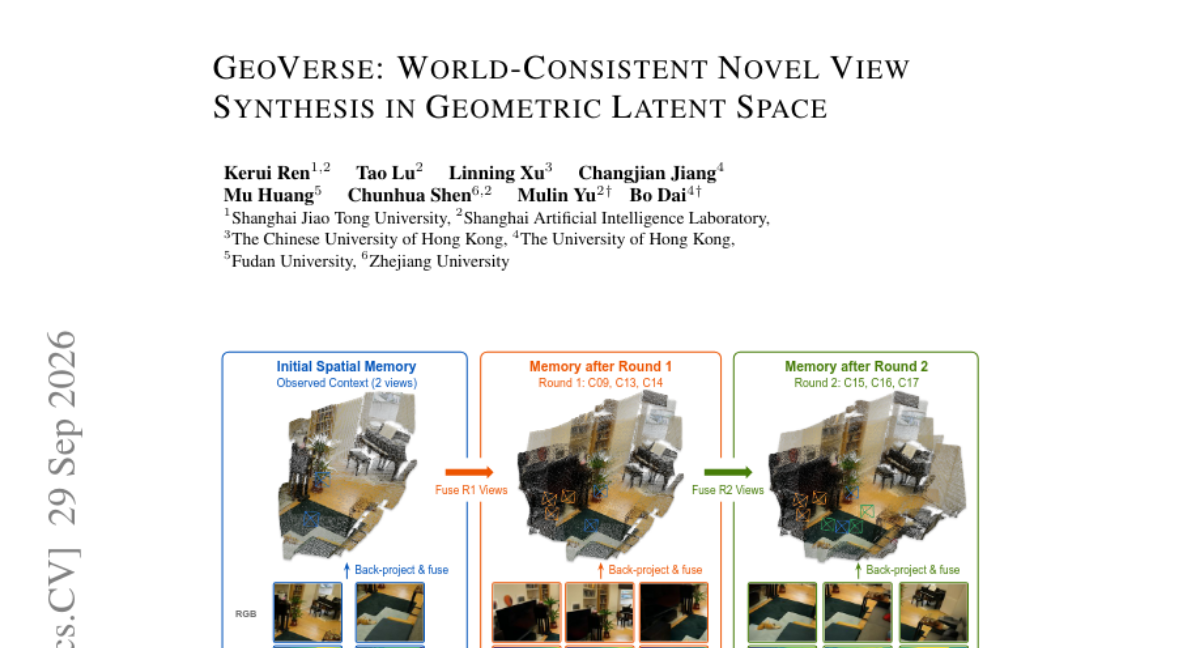
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





