

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

年中盘点|2020最炙手可热的10家大数据初创企业


当下,众多企业与组织都在努力紧跟大数据发展趋势,但其中的挑战也相当严峻。单单是管理规模庞大的数据集已经颇为艰难,更遑论从中提取出有意义洞见并借此建立竞争优势。
这种对大数据管理能力的实际需求,推动又一波初创企业投身其中,开发下一代数据库软件与数据管理工具。
1、Ahana

联合创始人兼CEO:Steven Mih
总部:美国加州圣马特奥
Presto最初由Faebook公司开发完成,用于查询该公司PB级数据仓库中的数据资产。2013年,Facebook决定将Presto转化为开源项目。
Ahana公司最近告别隐身模式,开始围绕PrestoDB(基于Presto技术的另一个开源项目)开发即席分析软件。今年6月初,该公司表示已经从GV(前Google Ventures)牵头的融资中筹集到225万美元种子资金,这笔款项将主要用于扩大技术团队规模并加快开发工作。
2、Aparavi

CEO:Adrian Knapp
总部:加利福尼亚州圣莫尼卡
文件备份与数据保护方案供应商Aparavi公司于今年3月推出了其首款数据智能与自动化平台,据称该系统将帮助企业高效应对分布式IT世界所带来的数据混乱、风险与识别发展机遇等难题。
该系统还包含适用于分布式数据的分析、机器学习及协作工具,可帮助用户将数据资产切实转化为竞争优势。
3、Cockroach Labs

联合创始人兼CEO:Spencer Kimball
总部:美国纽约
2019年10月,这家初创企业又发布了CockroachCloud,即该数据库的全托管分布式版本。
今年5月,该公司在新一轮融资中筹得8660万美元,历史融资总额则达到1.951亿美元。
4、Equalum

总部:美国加州桑尼维尔
Equalum公司表示其技术拥有“无限的速度与可扩展性空间”,用户无需任何编程经验即可开发出数据管道。
5、Okera

总部:美国旧金山
Okera公司开发出一套平台,供IT管理员自动发现并标记各类敏感数据、制定并执行数据治理策略,并对数据安全性与治理操作进行审计。
今年4月,Okera公司在B轮融资中筹得1500万美元,这也使其历史融资总额增长至2960万美元。这笔款项将主要用于扩大内部工程技术、销售与市场营销团队。该公司还任命了ZoomData前任总裁兼CEO Nick Halsey出任新的CEO。
6、PlanetScale

总部:美国加州山景城
该公司的这套PlanetScaleDB Cloud是一种全托管、多云架构且具备MySQL兼容性的数据库即服务。对于希望自主运行数据库即服务体系的客户,他们还准备了PlanetScaleDB Enterprise。
今年6月,该公司推出PlanetScaleDB for Kubernetes,用于将数据库直接部署至Kubernetes集群当中。
7、Promethium

CEO:Kaycee Lai
总部:加利福尼亚州门洛帕克
”Promethium公司在今年1月筹得600万美元风险资金。
8、Rivery

联合创始人兼CEO:Itamar Ben Hemo
总部:美国纽约
、并加载至云端分析系统(例如Amazon Redshift、Google BigQuery以及Snowflake)当中的整个流程。Rivery公司于2019年11月获得500万美元的种子轮投资。
9、Starburst

总部:美国波士顿
凭借着直接访问数据驻留位置以及无需移动即可直接查询等强大功能,Starburst软件已经成为传统数据仓库系统的一种良好替代方案。
今年6月,Starburst公司在B轮融资中筹得4200万美元。在2019年11月的A轮融资中,他们也筹得2200万美元。
10、Theia

总部:加拿大安大略省渥太华
。该系统还提供一份完善的分析功能目录,涵盖数据发现与治理、搜索、个性化、以及面向客户进行信息发布的外部门户等功能选项。
研究企业Gartner最近将Theia公司评为“Cool Vendor”。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
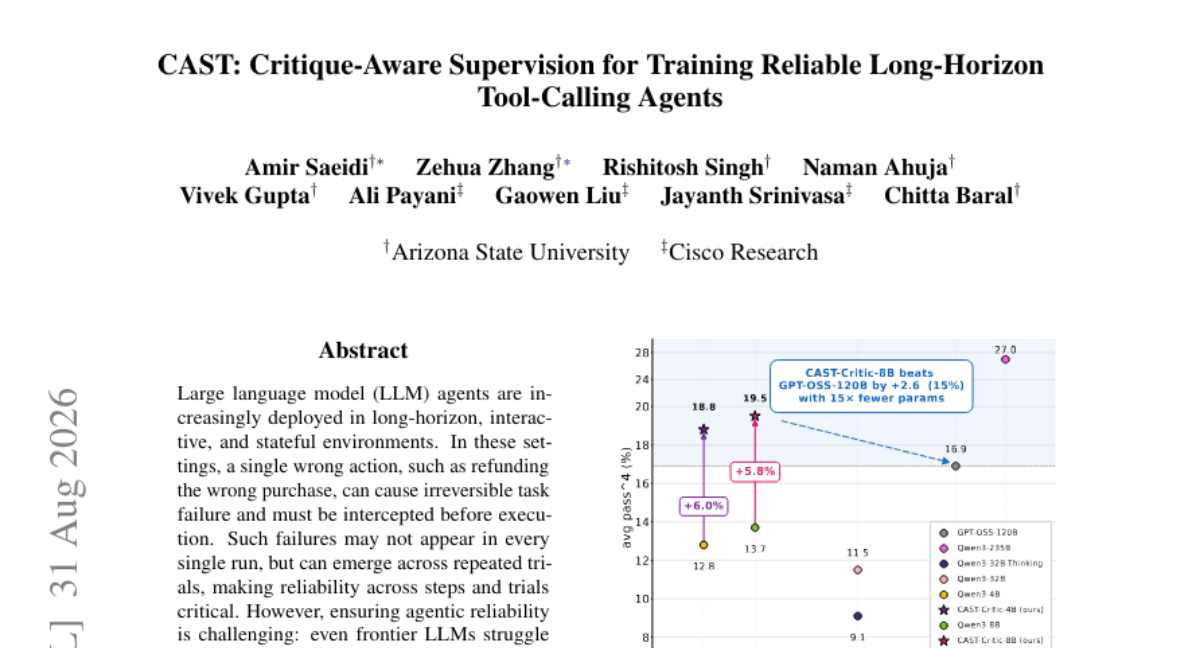
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
当机器人学会走路,却依然找不到答案
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
让AI给自己出考题:科研计划训练里那个作弊漏洞





