

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

京东Joy Future Academy等多机构联手揭秘:为何AI"游览"完一圈后,会忘记它刚才看见的东西?


这项由香港大学、京东Joy Future Academy、香港中文大学、北京大学、复旦大学、清华大学、香港科技大学及密歇根大学联合开展的研究,以arXiv预印本形式于2026年6月8日公开发布,论文编号为arXiv:2606.09803。
你有没有想过,如果一个AI摄影师正在拍一段漫游视频——它先拍了一只放在路边的彩色玩具熊,然后镜头转开去拍远处的风景,再转回来时……那只玩具熊还在吗?还是那个位置现在站着一只完全不同的动物?
这正是今天这个研究团队花了大量时间和精力去研究的问题。他们把这类AI系统叫做"动作世界模型"(action world model)——简单来说,就是那种能根据摄像机移动指令,一段接一段地生成连续视频的AI。这类AI不仅要画面漂亮,还必须能"记住"它之前生成的内容,确保摄像机转回来的时候,场景还是那个场景,玩具熊还是那只玩具熊。
然而,现有的AI在这方面做得并不好。摄像机一离开,场景就悄悄换了。这不是画面生成质量的问题,而是**记忆**的问题。研究团队将这个项目命名为"Echo-Memory",专门用来系统地研究:不同的记忆设计方案,到底哪种最能让AI"记住一个世界"?
---
一、为什么AI会在"回头看"的时候忘记它刚刚见过的东西?
先从最基本的问题说起。这类AI视频生成系统的工作方式,有点像一个画漫画的人——它不会一次性画出整部漫画,而是一格一格地画。每画完一格,它需要记住之前画了什么,才能保证下一格接得上。
麻烦在于,当这个"画漫画的AI"正在画第30格时,第1格的内容已经不在它的"眼前"了。如果它没有一套好的记忆机制,它就只能靠猜——第1格那只玩具熊大概长什么样?它可能猜对,也可能猜出一只完全不同的熊,甚至猜出一只猫。
研究团队把这类错误称为"记忆失败",而不是"画面生成失败"。这个区别很关键:AI完全可以在每一格都画出漂亮的图像,但如果它"忘记"了最初的场景,整段视频在逻辑上就已经崩塌了。
过去已经有不少研究者尝试给这类AI加上各种记忆模块,但这些研究很难互相比较——因为每个团队不光改了记忆方式,还同时换了AI骨干网络、换了训练方法、换了评估标准,导致你根本分不清楚到底是哪个改动起了作用。Echo-Memory的核心贡献就在于:把其他所有变量都锁定,只改记忆这一个东西,然后看结果有什么不同。
---
二、研究团队搭建了一个公平的"记忆擂台"
为了公平比较各种记忆方案,研究团队做了一件听起来有些反直觉的事:他们使用完全相同的AI视频生成骨架(一种叫做Video DiT的扩散变换器模型,基于阿里巴巴的Wan系列),使用完全相同的训练方式、学习率、优化器和评估流程,只在"记忆部分"做变化。
这就好比你要测试哪款保鲜盒保鲜效果最好,你放进去的食物、存放的温度、存放的时间都完全一样,唯一不同的就是保鲜盒的材质和设计。这样你才能说"是保鲜盒的差异导致了食物新鲜度的不同",而不是"可能是温度不同、可能是食物不同"。
研究团队把参赛的记忆方案分成了四大家族。第一类是"原始上下文记忆"——直接把过去拍摄的帧图像塞给AI,让它自己看。第二类是"压缩记忆"——把历史内容压缩、精简一下再给AI看,省点空间。第三类是"空间摘要记忆"——不直接给原图,而是提炼出一个场景地图,告诉AI场景的大致布局。第四类是"状态空间记忆"——最特别,不把任何明确的图像传给AI,而是在AI内部用一种循环的隐藏状态来"携带"过去的信息。
每种方案都在同一套基础设施上运行,接受同一套测试。擂台搭好了,比赛开始。
---
三、评判标准:不只是"画面好不好看",更要看"回头能不能认出来"
在说结果之前,必须先说清楚这个研究最聪明的地方——它设计了一套三重评判体系,而不是只用一个分数来评价所有东西。
第一重叫"回放质量测试"。给AI一段真实拍摄的摄像机运动轨迹,让它按照这条轨迹生成视频,然后用像素级的指标(PSNR、SSIM、LPIPS这些专业工具,可以理解为"量尺")来测量生成的视频和真实视频有多接近。这测的是:AI能不能流畅地跟着镜头走?
第二重叫"域内回环测试"。给AI一条先向左转180度、再原路返回的摄像机路径,问:回来以后的画面,和出发前的画面一不一样?这用的是真实的数据集场景,类似于在熟悉的环境里绕一圈。
第三重叫"开放域回访测试"。这是最严格的测试。研究团队专门制作了一批特殊的"第一帧图像"——在各种游戏风格的背景环境里,放一个颜色鲜艳、形状独特的玩具熊(或其他易于识别的物体)。AI从这张图出发,镜头先转开45度拍别处,再转回来。然后用一个独立的视觉语言模型(Qwen3-VL,相当于一个AI评判官)来打分:回来的画面里,那只玩具熊还在不在?还是不是原来那只?
为什么需要三重测试而不是一个?研究团队的发现给出了答案——这三个测试的结果经常互相矛盾,选不同指标就会得出完全不同的结论。这恰恰是这项研究最重要的发现之一,接下来会详细展开。
---
四、令人意外的擂台结果:最会"看轨迹"的,往往最不会"记住世界"
擂台结果出来了,第一眼看上去,会让很多人感到困惑。
如果只看"回放质量",赢家是"空间摘要记忆"——它在PSNR(像素精确度)这项指标上得分最高,13.60分,明显领先其他方案。照这个标准,空间摘要记忆是最好的记忆系统。
但当测试切换到"开放域回访"时,画风完全变了。空间摘要记忆的得分跌至6.00分(满分100分),直接垫底。而在回放测试里表现平平的"块状态空间记忆",开放域回访得分高达69.00分,一骑绝尘。
同一套系统,同一个骨干网络,只是记忆方案不同——结果在两项测试里的排名完全颠倒。
这意味着什么?回放质量测试量的是"AI能不能跟着摄像机走",而开放域回访测试量的是"AI能不能在离开之后还记得那只玩具熊"。这是两种完全不同的能力。一个AI可以画出非常精确的轨迹跟踪画面,但同时完全不记得场景里有什么重要的东西。研究团队把这个发现总结为:用回放质量来代替记忆质量,会导致你选错设计。
---
五、"原始上下文记忆"的反击:简单粗暴,但意外地有效
在四大记忆家族里,最朴素的方案其实表现相当亮眼。
所谓"原始上下文记忆",就是最直接的做法:从历史帧里挑出K张图,直接拼在一起塞给AI看。没有任何压缩,没有任何特殊处理,就是原图。
当只给1张历史帧(相当于只有起始帧,也叫I2V基线)时,开放域回访得分只有12.25分。当增加到5张历史帧(K=5)时,得分一下跳到50.75分——几乎涨了四倍。再增加到20张(K=20)时,得分进一步提升到58.63分。
与此同时,回放质量指标的提升幅度要小得多:从K=1到K=20,回放PSNR只从10.03提升到12.54,SSIM从0.398提升到0.449,提升幅度可以说相当有限。
这个对比说明了一件重要的事:更多的历史帧,主要帮助的是"回来还能认出玩具熊"这件事,而不是"能更精确地跟着镜头走"这件事。换句话说,历史信息的核心价值是语义上的记忆,而不是像素级的精度提升。
而且,这个增益是递减的——从K=1到K=5增加了38.50分,从K=5到K=20只再增加了7.88分。大部分记忆增益在很早的时候就已经实现了。
这带来一个重要的参考基准:任何声称"压缩记忆"或"空间摘要"更好的方案,都不能只跟K=1的基线比,而必须跟K=20的原始上下文记忆比。因为那才是真正的竞争对手。
---
六、压缩记忆:聪明反被聪明误
压缩记忆家族的结果,也给了研究者不少警示。
最基础的压缩方式叫"权重压缩"(token weighting):保留所有历史帧,但给不同帧分配不同的重要性权重,让AI更关注重要的帧。这种方式看起来很合理——毕竟不是所有历史帧都同样重要,对吗?
然而开放域回访得分只有22.38分,连K=5的原始上下文(50.75分)的一半都不到。
另一种方式是"时间长度压缩"(temporal length compression):每隔r帧才保留一帧,把历史帧数量缩减到1/r。当r=4时(保留四分之一的帧),开放域回访得分达到43.25分,比权重压缩好多了。
这个结果乍看起来反直觉——历史帧数量更少,反而更有用?但想清楚就明白了:把历史帧均匀地稀疏化,相当于在清晰的"关键时刻截图"里保留了场景的核心特征;而把所有帧全保留再加权重,AI的注意力被大量相似帧稀释,反而找不到重点。
更糟糕的是两种方式叠加的"混合压缩":先稀疏再加权,开放域得分只有8.75到9.00,几乎是所有方案里最差的。原因在于,先稀疏化破坏了帧与帧之间的精细信息,让后续的权重学习失去了可操作的高质量素材。两个看似合理的操作,叠在一起反而产生了破坏性的效果。
研究团队给出的诊断很直接:压缩不是一个能随意堆砌的工具箱,而是需要明确目标——你到底想保留什么?当前的压缩方案没有针对"回访时需要认出玩具熊"这个目标做优化,所以虽然省了空间,却恰好扔掉了最关键的证据。
---
七、空间摘要记忆:存得好,不代表用得好
空间摘要记忆在回放测试里表现出色,却在开放域回访里惨败,这背后有一个更细腻的原因值得深挖。研究团队专门针对这一类方案做了一组"读取方式消融实验"——也就是说,存储方式不变,只改变AI如何"读取"这些存储的信息,来看对结果有什么影响。
他们设计了四种读取方式。第一种是默认方式,正常读取存储的场景摘要,开放域得分6.00。第二种是"不注入"——把摘要存好但就是不给AI用,只在训练时存在,推理时拿走,开放域得分反而提高到15.50分。第三种是通过文字交叉注意力路径读取,得分10.25。第四种是专用的独立交叉注意力模块来读取,得分17.12,是四种里最高的。
"不注入"比"正常读取"效果更好——这个发现非常耐人寻味。研究团队的解释是:空间摘要在这个规模下,并非真正在发挥记忆功能,而更像是一种让AI训练更稳定的正则化工具。当推理时把摘要拿掉,AI反而因为"路径干净了"而生成出更精确的轨迹跟踪画面。
这说明了一件事:**存储了信息,不等于记忆了信息**。一个G×G的场景网格,能记录大致的空间布局,但它的信息密度太低,无法准确记录"那只彩色玩具熊长什么样子、放在哪个具体位置"。当摄像机离开再回来,AI需要从这个低密度摘要里重建出一个高密度的具体物体,信息缺口太大,只能靠猜——于是那只熊可能变成了别的东西。
结论是:空间摘要记忆需要在两端同时改进——写入时要更关注物体级别的细节,读出时要专门为"回访时重建物体"这个任务提供精准的访问路径。
---
八、状态空间记忆:结构决定了一切
最后轮到本次擂台的最大赢家——状态空间记忆。但这个家族内部也有一场"内战",揭示了一个重要的道理。
研究团队测试了两种状态空间方案。一种叫"传统混合状态空间",是在标准的视频生成模型上轻量级地加了一个循环门控,相当于在视频生成的流程外挂了一个辅助记忆单元。它的回放PSNR是12.69,在-域回访PSNR是12.23,都很不错。开放域回访得分34.75,处于中等水平。
另一种叫"块状态空间",是把循环状态深度整合到视频生成模型的内部,每隔n个计算块就强制读取、更新、写入一次循环状态,让历史信息无处可逃,无法被模型绕过。它的回放PSNR只有9.59,比传统方式低了不少,但开放域回访得分直接飙到了69.00——几乎是传统方式的两倍。
为什么会有这么大的差距?研究团队的解读是:传统的轻量级循环门控,AI在推理时可以"绕路走"——当摄像机在视野内时,直接从当前帧生成即可,循环状态用不上。但当摄像机离开后需要"记住那只熊"时,这个循环状态因为没有被充分训练成真正的记忆通道,所以帮不上忙。
而块状态空间的深度整合,让循环状态成为一条必经之路,模型无法绕过它。这迫使模型学会用循环状态真正携带场景信息,而不只是用来平滑时间过渡。这种深度绑定在回放时有一定代价——因为模型的一部分表达能力被用来维护历史状态,无法全力服务于当前帧的像素精度。但这正是记忆的本质代价:为了记住过去,你必须牺牲一点专注当下的能力。
研究团队把这个发现提炼成一句话:**"状态空间记忆"不是一个单一选项,循环结构整合得有多深、有多不可绕过,决定了它是真正的记忆机制还是只是个平滑器。**
---
九、为了防止评判官"独断专行":多方验证的公正裁判
有一个细节值得一提:开放域回访测试用的是一个AI语言视觉模型(Qwen3-VL-30B-A3B)来打分,研究团队担心这个评判官本身的偏好影响结论,于是专门做了一个跨评判官验证实验。
他们选了一部分样本,同时交给三个不同的评判官打分:Qwen3-VL自己、Claude Opus 4.6、GPT-5.5,以及一组真实人类评测者。
结果显示,四个评判官给出的平均分非常接近(分别是19.6、20.7、21.1、20.9,都在20分左右)。更重要的是,它们对不同记忆方案的相对排名高度一致,Pearson相关系数都在0.93到0.96之间(接近1.0表示完全一致)。这说明,换一个评判官,得出的结论不会改变。
---
十、把这一切放在一起:三条硬结论和一张清单
经过完整的擂台比拼,研究团队总结出五条核心发现,这里用通俗的方式一一呈现。
第一条:开放域回访是最真实的记忆压力测试。回放测试和域内回访都是必要的健康检查,但真正能分开"好记忆"和"坏记忆"的,是开放域回访测试。这里的分差最大,结论最清晰。
第二条:空间摘要"高效"但不可靠。空间摘要在回放测试里表现很好,但在语义记忆上不及格。症结在两处:存储的信息密度不够,读取方式也不够针对性。光把场景画成地图,不足以记住地图上的每一个具体角色。
第三条:压缩必须有目标,不能只求省空间。把两种压缩方法叠加使用可能适得其反。一个好的压缩方案需要明确保留什么——尤其是那些回访时会成为关键证据的信息。
第四条:块状循环结构是目前最强的语义记忆机制。它的代价是牺牲一些回放精度,但在开放域回访上的优势远超这个代价。
第五条:原始上下文记忆是难以打败的容量基线。任何压缩或隐式记忆方案,都应该用K=20的原始上下文来作对比标准,而不仅仅是只有1张历史帧的I2V基线。
基于这五条发现,研究团队还给出了一份面向未来研究的"检查清单":新的记忆方案必须与多个K值的原始上下文对比;必须分开测试信息写入和信息读取这两个环节;压缩方案需要以回访成功率为优化目标;循环方案需要测试循环状态整合的深度,而不是把所有循环方案都当作同一类型;最重要的是,必须报告完整的三重评估,而不是只报回放分数。
---
归根结底,这个研究讲的是一件很朴素的事:AI要真正理解一个世界,不只是要能流畅地跟着镜头走,更要能在镜头转开之后,依然记得那只放在路边的彩色玩具熊。
这项研究没有宣布哪一种记忆方案已经完美,也没有提出一个全新的AI模型。它做的是更基础也更重要的事:搭了一个公平的测试台,发现了之前大家都没意识到的问题——原来我们一直用来评价AI记忆能力的指标,根本测不到最关键的东西。
对于普通用户而言,这项研究的意义可能还要过一段时间才会显现出来,但它指向的方向已经清晰:未来那些能记住你上次家装风格、能在游戏里保留你建造的城堡、能在视频通话里记住你脸上那颗痣的AI系统,都需要从这类研究中汲取养分。
如果你对这个话题感兴趣,可以通过arXiv编号2606.09803查阅完整的研究论文。
---
Q&A
Q1:Echo-Memory研究的核心问题是什么?
A:Echo-Memory研究的核心问题是:当AI视频生成系统的摄像机离开某个场景再返回时,它能不能记住原来那个场景里的具体物体?研究发现,原来大家用来衡量AI视频质量的"回放指标"根本测不到这个能力,需要专门设计"开放域回访测试"才能真正评判AI的记忆能力。
Q2:块状态空间记忆为什么回放分数低但记忆能力强?
A:块状态空间记忆把循环状态深度整合到视频生成的计算流程里,模型无法绕过它,必须学会用它携带历史信息。这占用了一部分原本可以用来精确复现当前帧像素的计算能力,所以回放精度略低。但正是这种"强制记忆"机制,让模型在摄像机离开再回来后,还能准确重建原始场景中的关键物体,开放域回访得分高达69分。
Q3:混合压缩为什么比单独压缩效果更差?
A:混合压缩先做时间稀疏化(每隔几帧保留一帧),再对保留帧学习重要性权重。问题在于,稀疏化这一步已经把高价值帧和低价值帧混在一个"池子"里平均掉了,后续的权重学习面对的是已经损失了精细信息的粗糙序列,找不回来原本可以保留的关键证据。两个操作叠在一起,相当于先销毁证据再试图分析,开放域得分仅有8.75分,是所有方案里最低的。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
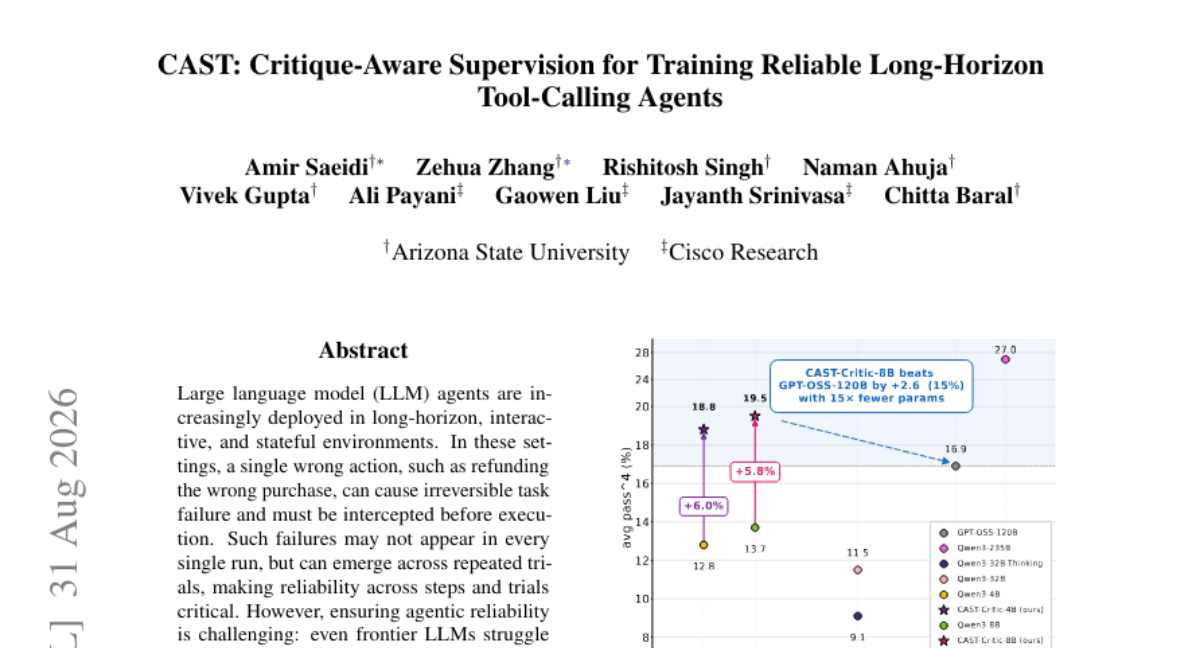
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
当机器人学会走路,却依然找不到答案
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
让AI给自己出考题:科研计划训练里那个作弊漏洞





