

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

GPU集群里的"无政府状态":NCA研究机构首次用博弈论揭开AI推理系统的效率秘密


这项由NCA研究机构完成的研究发表于2026年6月,论文编号为arXiv:2606.17081v1,分类在计算机架构(cs.AR)领域。有兴趣深入了解的读者可以通过该编号在arXiv平台查询完整论文。
一、当AI推理遇上"公地悲剧"
每次你向ChatGPT提问,背后的数据中心里都在发生一场激烈的资源抢夺。成千上万的请求同时涌入,争抢着GPU计算资源、内存空间和网络带宽。这场抢夺没有协调者,每个请求只管自己的利益,结果往往是整体效率远低于应有水平——就像早高峰的公路,每个司机都想走最快的路,最终大家全堵在一起,谁都跑不快。
经济学家把这种现象叫做"博弈论"中的经典问题:个体理性导致集体非理性。博弈论里有个专门的指标来衡量这种损失,叫做"无政府代价"(Price of Anarchy,PoA)——它衡量的是,当每个人只顾自己利益时,整体效率比大家协调合作时差了多少倍。PoA等于1意味着各自为政和统一协调一样好;PoA越大,说明"无政府状态"造成的损失越严重。
在AI推理这个领域,这个问题从未被认真研究过。直到这篇论文的出现。NCA的研究人员选取了英伟达(NVIDIA)最先进的AI推理框架Dynamo作为研究对象,第一次用博弈论的语言,把这套复杂系统里隐藏的三场"博弈"完整地解剖出来,并且在真实的硬件集群上做了验证。他们发现:系统在正常负载下运转良好,但一旦超过某个临界点,各种低效会像雪崩一样叠加,无政府代价急剧飙升。更重要的是,他们设计了一个简单的自适应控制器,通过在恰当时机切换路由策略,把最大测试场景下的无政府代价压低了3.1倍,同时让用户等待第一个字生成的时间缩短了近八倍。
二、把AI推理想象成一家大型快餐连锁店
要理解这篇研究,先要搞清楚"分解式推理"(Disaggregated Inference)是什么。
当你向AI提问时,它需要完成两件性质完全不同的事情。第一件事叫做"预填充"(Prefill):AI要一口气读完你整个问题,理解所有上下文,这个过程极度依赖GPU的计算能力,就像餐厅厨师在接到订单后,需要先把所有食材切好备齐。第二件事叫做"解码"(Decode):AI一个字一个字地生成回答,每生成一个字都需要反复读取之前的"记忆"(也就是KV缓存),这个过程极度依赖内存读写速度,就像服务员把菜一盘一盘端出来上桌。
传统的做法是让同一块GPU既切菜又端菜,但这两件事对资源的需求截然不同——切菜需要刀工(计算能力),端菜需要腿快(内存带宽)。分解式推理的核心思路就是把这两件事分开:专门的"切菜GPU池"负责预填充,专门的"端菜GPU池"负责解码,两者通过高速网络传递"菜肴"(KV缓存)。
英伟达的Dynamo框架是这种理念最完整的产业级实现。它有四个关键组件:负责动态调配"切菜"和"端菜"员工比例的"计划员"(Planner)、负责把每个订单分配给最合适员工的"智能路由器"(Smart Router)、负责管理"菜肴存储柜"层级结构的"KV块管理器"(KVBM),以及负责传递消息的"内部通信网络"(事件平面)。
正是这种分工创造了一个天然的多方博弈系统。切菜团队和端菜团队争夺GPU预算;每个订单争夺被分配到"存着自己相关菜谱"的那台GPU;每块内存空间争夺谁的"菜谱"能被保留在最快的存储区域。NCA的研究人员意识到,这三场争夺各有其博弈论结构,而且三者之间还会相互影响。
三、隐藏在系统里的三场博弈
研究团队将整个Dynamo系统分解为三个相互耦合的博弈,每一个都有精确的数学定义。
第一场博弈发生在预填充池和解码池之间,争夺的是有限的GPU总预算。预填充池希望拿到更多GPU来缩短用户等待第一个字生成的时间,解码池希望拿到更多GPU来保证生成每个字的速度。这两个目标之间存在内在张力,而且两者受制于同一个约束:总GPU数量固定。研究人员把这建模为"广义纳什均衡问题"(GNEP)——两个玩家共享同一个约束,各自最大化自己的目标。
理论分析表明,在预填充和解码效益都随GPU增加而递减的合理假设下,这个博弈存在唯一的"变分均衡":此时给预填充或解码再多加一块GPU所带来的SLO(服务质量目标)改善完全相等。直觉上这很合理——如果切菜这边增加一个厨师的收益远大于端菜那边,那就应该先给切菜加人。
但这个均衡点并不是整体最优,因为它忽略了预填充对解码的正外部效应:切菜速度更快,不仅直接缩短等待时间,还减少了端菜团队的空等时间。社会最优点会把更多GPU分配给预填充,偏移量恰好等于这个正外部效应的大小。在正常负载下这个偏差很小,但系统过载时会显著放大。
第二场博弈是KV缓存的存储位置博弈。每台GPU都有四个存储层级:速度最快但容量有限的显存(HBM)、速度较慢的CPU内存(DRAM)、更慢的本地固态硬盘(SSD),以及最慢的网络存储。当一块"菜谱"(KV缓存块)被放在哪里,决定了下次需要用到它时要付出多大的代价。每台GPU的管理程序都倾向于把自己最常用的菜谱放在最快的位置,这是一种"自私的缓存"行为。
这场博弈的有趣特性来自网络拓扑。在同一台机器内,各GPU通过NVLink高速互联,相当于一个"完全图"——任意两点之间的访问代价差不多,因此自私缓存和集中式最优缓存效果相当,无政府代价接近1。但跨越不同机器时,通信要走InfiniBand网络,拓扑更稀疏,自私行为的代价就会上升。更危险的是一个"布雷斯悖论"式的结论:往GPU集群里增加更多缓存节点,在某些情况下反而会让整体缓存效率下降,因为额外节点改变了自私博弈的均衡位置。
第三场博弈是请求路由博弈,也是实验验证的核心。每个进来的用户请求都要被分配给某台解码GPU,这个分配过程就是一场拥塞博弈。分配给某台GPU的请求越多,这台GPU越慢,后来的请求代价越高——这是拥塞负外部性。但同时,如果某台GPU的缓存里恰好存着和你的问题相关的"菜谱",分配给它能省去重新计算缓存的时间——这是缓存正外部性。
智能路由器的分配公式是:每台GPU的代价 = ω × 需要重新预填充的块数 + 当前活跃块数。其中ω是控制缓存亲和力与负载均衡之间权衡的参数。当ω大时,路由器更倾向于把请求发给"存着相关缓存"的GPU;当温度参数τ大时,路由器更倾向于随机分配,避免热点。
三场博弈通过共享状态相互耦合:计划员的GPU分配改变了路由博弈的参与者集合;路由决策决定了哪些缓存块被创建在哪台GPU上;缓存状态的变化又改变了路由器的代价计算。当预填充池过载时,解码GPU开始空转,计划员把GPU从解码池调往预填充池,解码容量降低,等预填充积压清空后,大量新请求涌入解码池,解码池又陷入过载——一场振荡式的雪崩就此展开。
四、过载临界点:一切改变的那一刻
系统在正常负载和过载状态下的表现差异,是这篇研究最核心的发现。
在正常负载下,GPU有剩余的计算和内存资源,增加请求的边际延迟几乎为零。这时候延迟随并发请求数的增加是接近线性的,路由博弈的无政府代价有明确的上界,参数调节也没有太大意义——怎么分配都差不多。
但当请求数量逼近GPU的处理极限时,情况发生了根本性的变化。显存被填满,缓存块开始溢出到更慢的DRAM和SSD;每块GPU上排队的请求超过最优批大小,吞吐量不再增加但延迟开始急剧攀升;所有GPU都饱和后,请求开始在前端排队,排队延迟以 1/(处理能力-请求速率) 的形式趋向无穷。
研究团队用一个带有"奇点"(pole)的数学函数来描述这种过载延迟:延迟 ≈ a×请求数 + b + d/(饱和点 - 请求数)^β。这个函数在请求数等于饱和点时趋向无穷大,比任何固定次数的多项式都增长得更快。这个奇点就是问题的根源:即使路由器做了非常接近最优的分配,在奇点附近,微小的负载不均衡也会被这个超线性函数放大成巨大的代价差异,无政府代价因此可以无限增长。
研究人员还发现了一个非常有趣的非对称性:预填充和解码在完全不同的资源上过载。预填充过载是因为GPU算力触及天花板(每秒浮点运算次数),解码过载是因为内存带宽耗尽(每秒读写的GB数)。在实验用的B200 GPU上,预填充算力天花板是约20拍次浮点运算,解码带宽天花板是约8TB/s。由于使用的工作负载以128个输入词元为主,预填充计算量相对较大,实验中预填充池总是先过载,而解码GPU的每词延迟始终保持平稳。
这在实验数据里表现得极为戏剧性:当并发请求数从96增加到128时,生成第一个字的等待时间(TTFT P99)从544毫秒跳到16.2秒,增加了约30倍;而每个字之间的时间间隔(ITL P99)全程保持在22毫秒左右,几乎纹丝不动。两个指标之间相差近四个数量级。预填充成了整个系统的咽喉要道,解码团队空等,计划员反复振荡,整个系统陷入混乱。
五、在真实硬件上验证:三节点B200集群的实验
研究团队在一个由三台配备NVIDIA B200 GPU服务器组成的集群上运行了全部实验,集群通过InfiniBand网络互联。他们测试了两个模型:一个是Llama-3.1-70B(700亿参数的密集型模型,采用FP8量化),另一个是Nemotron-4-340B(3400亿参数的超大模型,同样采用FP8量化)。
工作负载设计得相当简洁:5个提示词模板,每个输入128个词元,最多输出256个词元,生成温度设为0(确定性生成)。通过信号量控制同时在途的请求数量,测试了从1到512个并发请求的全范围。
无政府代价的测量本身就是个有趣的工程挑战。Dynamo的HTTP接口不会告诉你每个请求被分配给了哪台GPU,研究人员通过关联NATS事件总线上的事件流和HTTP响应中的请求ID,实现了100%的请求-GPU对应关系追踪。有了这个追踪数据,就可以把实际总延迟(所有请求的实际等待时间之和)与理论最优分配的总延迟进行比较。理论最优分配通过匈牙利算法在一个"冻结延迟"的代价矩阵上计算——把每台GPU当前的实际负载输入一个参数化的延迟模型,然后找出让总延迟最小的分配方案。
这个估算器(记作PoAd,区别于理论上严格定义的无政府代价)有一些值得明确的局限性:代价矩阵用的是未经校准的参数化模型,不是实测数据;匈牙利算法只考虑了"冻结"状态下的延迟,没有考虑重新分配后负载变化对延迟的影响,因此它是对真实最优解的过度乐观估计,导致PoAd是对真实无政府代价的偏高估计。此外,在极低并发(1到4个请求)时,由于在途请求太少,匈牙利算法会找到一个看起来极好的"最优分配",分母很小,PoAd因此虚高到几十甚至上百,这些数据点被研究人员明确标注并排除在主要结论之外。
尽管如此,PoAd作为"政权指示器"的功能是充分的:它是否上升比它的绝对值更重要,而这个趋势在实验中表现得无比清晰。
六、三段式政权结构:每个数字背后的故事
实验数据呈现出极为规律的三段式结构,在两个模型和三种拓扑配置上完全一致。
在低并发阶段(排除掉虚高的1-4并发之后),PoAd稳定在一个平台上:340B模型约为18.7,70B模型的一拖二拓扑(1个预填充GPU,2个解码GPU)约为7.47,70B模型的一拖五拓扑约为14.7。这个平台的值不随负载增加而变化,哪怕从8个并发增加到96个并发,PoAd的波动都在±0.1以内。这对应于理论预测:在线性延迟区间内,无政府代价受到上界约束,不随负载增长。340B的平台值约是70B一拖二的2.5倍,直觉上合理:更大的模型意味着每一次路由错误都浪费更多计算资源。而一拖五的平台值比一拖二高约2.4倍,这反映了更大的路由博弈(5个"玩家"比2个"玩家"有更多可能的分配方式,贪心算法偏离最优的空间也更大)。
在过渡区(70B约为96-128个并发,340B类似),系统开始出现预填充积压的早期迹象,延迟开始抬头,但尚未完全崩溃。
在饱和区(从128个并发开始),PoAd急剧攀升:340B在256个并发时达到176.9,在384个并发时达到283.6;70B一拖二在384个并发时达到199;70B一拖五在256个并发时达到309。这些庞大的数字并不意味着路由器真的在把效率浪费掉七八十倍——正如前面分析的,过载时PoAd的主要驱动力是预填充瓶颈(Game 1的资源分配失败),而不是路由本身的低效。一个PoAd为284的系统,更多地说明"系统处于过载、没有任何路由策略能弥补预填充不足",而非"路由算法在浪费284倍的效率"。
值得专门指出的是两个模型共同的"第一个过饱和网格点"都在并发数128处:340B的TTFT P99从544毫秒跳到16.2秒,70B从354毫秒跳到10.0秒,都在这同一个并发数处发生转折。研究人员提供了一个简单的机械解释:两种配置都只有一台预填充GPU,运行在相同的B200硬件上,处理相同的128词元输入,因此单台预填充机器的算力天花板自然会在相近的并发请求数处触碰到。由于测试网格的粒度是{64, 96, 128},真正的膝盖点可能在96到128之间的任何位置,只是无法在当前网格精度下分辨。
七、参数调节的真相:什么时候有用,什么时候没用
实验的第四组(参数扫描)专门回答一个实际运维中最常见的问题:调节路由器参数能改善性能吗?
研究人员在4×4的参数网格(温度τ取0.0、0.3、0.7、1.0,缓存权重ω取0.0、0.3、0.7、1.0)上做了全面扫描,分别在正常负载(64并发)和饱和负载(128并发)下各运行一次。
在正常负载下,结果令人印象深刻地单调:340B模型全部16个参数组合的PoAd偏差不超过±0.10,70B一拖二不超过±0.08,70B一拖五不超过±0.06。无论是把温度调到0(确定性分配)还是调到1(高度随机),无论是把缓存权重调到0(完全无视缓存亲和力)还是调到1(最大化缓存亲和力),PoAd都保持不变。这在实践中意味着:在系统没有过载的情况下,调节路由参数对整体效率没有帮助,工程师的精力应该放在别处。
在饱和负载下,情况开始有所不同,但差异的大小取决于路由博弈的规模。340B一拖二(2个解码GPU)的16个配置PoAd从26.6到42.5,跨度约1.6倍,变化存在但规律性较弱,更像噪声。70B一拖二的PoAd从14.6到28.2,跨度约1.9倍,结构更清晰——(τ=0.3, ω=0.7)取得最小值14.6。70B一拖五(5个解码GPU)的跨度达到2.0倍,参数敏感性最强,验证了"路由博弈越大,参数调节的潜在收益越高"这一预测。
缓存博弈的实证验证也隐藏在这次扫描里:沿ω维度切片可以看到,在正常负载下ω的变化完全不影响PoAd,印证了"缓存充足时自私缓存等同于最优缓存"的理论命题;在饱和负载下,对70B一拖二来说,ω从0增加到1会使TTFT P99从23.7秒降低到17.4秒,说明缓存亲和力在过载时确实有价值——但PoAd并不随ω单调下降,因为把请求堆积到缓存热点GPU会制造拥塞,这是缓存博弈与路由博弈耦合的直接体现。
八、自适应控制器:用最简单的方法赢得最大的收益
有了对三段式政权结构的深刻理解,研究团队设计了一个极为简洁的自适应控制器——大约270行Python代码,完全不需要修改Dynamo的Rust核心。
控制器的工作原理本质上就是两件事:监测系统处于哪个政权,然后切换到对应政权的最优参数。
监测方面,控制器每5秒从Prometheus指标系统拉取一次TTFT P99数值,用指数加权移动平均(EWMA,平滑系数α=0.3)过滤掉瞬时噪声,得到一个平滑的延迟趋势信号。当这个信号低于阈值θ1时,系统处于正常政权;高于θ1但低于θ2时,处于过渡政权;超过θ2时,处于饱和政权。对70B模型,θ1=300毫秒,θ2=2秒;对340B模型,θ1=1秒,θ2=10秒(340B的基础延迟本来就更高,相应阈值也要抬高)。
参数方面,正常政权使用τ=0、ω=1(确定性分配,最大化缓存亲和力);过渡政权使用τ=0.7、ω=1(随机化分配,保持缓存亲和力的同时引入负载均衡);饱和政权的参数τ=0.8、ω=0.1(更强的负载均衡,抑制缓存热点)在实验中未被触发,因为测试的负载尖峰持续时间不足以穿越θ2的EWMA滞后。
实现上有个聪明的细节:控制器同时运行两个前端,一个在8000端口用默认参数,另一个在8001端口用最优参数。当检测到政权转变时,工作负载生成器直接切换目标端口,完全不需要重启任何组件,避免了重启期间的服务中断。
实验通过三阶段负载尖峰来测试这个控制器:先在32并发下运行120秒(正常负载),然后突然提高到128并发运行180秒(过载阶段),最后降回32并发运行120秒(恢复阶段)。每种策略(静态路由 vs 自适应路由)各运行3次,取均值和标准差。
九、实验结果:数字背后的含义
对340B模型(一拖二拓扑),自适应控制器将饱和阶段的TTFT P99从28.26±5.9秒降至5.92±0.06秒,聚合指标改善了4.8倍。但这个数字混合了两个阶段:控制器在饱和阶段开始后约54.8秒检测到政权转变并切换参数,此前的约55秒仍在用默认参数,剩余的约125秒用优化参数。如果只看切换后的稳态,TTFT P99约为0.97秒,而静态策略的同期约为28.3秒,改善幅度约为29倍。代价是饱和阶段的吞吐量从18.2 rps降至11.6 rps,下降了36%——这是在选择"优先保证延迟而非最大化吞吐量"的操作点时必然付出的代价。
一个特别显著的副产品是方差的压缩:静态策略的TTFT P99标准差是5.9秒,自适应策略只有0.06秒,压缩了约100倍。饱和状态下的延迟之所以方差极大,是因为请求队列在随机波动中时而积累时而清空,导致每批请求的等待时间大幅波动。切换到优化参数后,这种随机性被有效抑制,延迟变得可预测。
对70B模型一拖五拓扑,自适应控制器的效果最为突出:PoAd从66.42±12.2降至21.53±0.17,降幅3.1倍。这是整篇论文中最稳健的核心结论——静态基线的变异系数高达18%,但3.1倍的改善幅度不论如何计算可信区间都保持显著正值。70B一拖二拓扑同样展现出可观的改善:PoAd从23.1±1.6降至10.7±0.5(降幅2.2倍),TTFT P99从25.9±2.1秒降至3.4±0.4秒(降幅7.6倍),是所有配置中TTFT改善最大的案例。
三种配置的改善幅度排序——70B一拖五(3.1倍PoAd)> 70B一拖二(2.2倍PoAd)> 340B一拖二(1.22倍PoAd)——与路由博弈规模的排序完全一致(m=5 > m=2 with 70B > m=2 with 340B)。这进一步验证了理论预测:路由博弈越大,参数调节的边际收益越高。
十、研究的边界与诚实的局限
这篇研究的作者在讨论部分展现了值得称道的诚实态度,详细列出了结论的适用范围和潜在局限。
工作负载的同质性是最重要的限制。所有实验都用相同的5个提示词模板、相同长度的输入,并且用确定性生成(温度0)。这导致缓存博弈在实验中实际上是退化的——5个前缀完全可以一一对应到解码GPU,缓存分配问题几乎是平凡的。此外,128词元的输入相对于192GB的B200显存来说太小了,缓存从未溢出到DRAM或SSD,四层存储架构的缓存博弈从未被真正激活。至于输出长度固定且确定性生成,也意味着路由博弈中缺少了现实中最重要的不确定性来源。这些因素加在一起,使得研究团队观察到的"过饱和时参数调节有效"结论,在多轮对话、长上下文、可变输出长度的真实场景下是否成立,仍是开放问题。
第一场博弈(GPU分配博弈)从未被实证验证。实验全程使用固定的预填充/解码比例,Planner的动态调配能力始终关闭。研究团队为P/D资源博弈提供的理论分析完整而严谨,但没有一个数据点来自真正改变过P/D比例的实验。
跨实验的测量漂移也值得关注。同样是340B一拖二在128并发、默认参数下,三次不同实验报告了三个不同的PoAd值:27.9(实验1),36.0(实验4b),33.15±1.14(实验3)。约29%的跨实验散差与用来论证参数敏感性的1.6倍跨配置差异处于同一量级。研究人员明确指出了这一点,提醒读者在解读340B参数敏感性的具体数字时需要考虑这个不确定性。
从系统设计角度看,研究还提出了三个对实践有指导意义的建议。首先,无政府代价应当成为推理系统的一级指标,和TTFT、ITL一起在监控面板上展示——上升中的PoAd是系统即将进入危险政权的预警信号,即便绝对延迟还在SLO范围内。其次,系统应该为政权转变而非稳态而设计,Planner和路由器应在转变速度、超调量和振荡行为上接受评估,而不只是稳态吞吐量。第三,在多租户场景下,租户本身就是真正的博弈参与者,有动机抢占预填充时间槽、发送虚假预热请求或刻意错开批处理时机,这些行为需要激励相容的机制设计来应对,而这超出了当前研究的范围。
说到底,这篇研究做的事情本质上是给一个已经运作良好的工程系统贴上正确的数学标签,然后利用这些标签的含义做了一件简单但有效的事。博弈论并没有告诉Dynamo怎么计算最优分配——那是PPAD难的问题,毫秒级的推理系统根本负担不起。博弈论做的是另一件事:告诉我们何时贪心策略足够好、何时它会崩溃、以及崩溃的先兆信号是什么。这种"分析性而非算法性"的应用方式,或许才是博弈论对工程系统最持久的价值所在。
对普通用户来说,这项研究意味着:你下次向AI提问时,后台系统可能已经在悄悄监测自己是否处于"混乱临界点",并在必要时主动切换到更保守的请求分配策略。这个切换你感知不到,但它可能正是让你的回答从等待十几秒变成不到一秒的那个关键决定。
如果你对这些技术细节感兴趣,可以通过arXiv编号2606.17081查阅完整论文,原文包含完整的实验数据、数学推导和代码实现细节。
Q&A
Q1:什么是分解式推理,它和普通AI推理有什么区别?
A:分解式推理是把AI生成回答的两个阶段——读懂问题的"预填充"和逐字生成回答的"解码"——分拆到不同的GPU上处理。普通AI推理让同一块GPU做这两件事,但这两件事对资源需求截然不同,分开处理可以让各自的GPU专注于最擅长的工作,显著提升整体效率。NVIDIA的Dynamo框架是这种方式目前最完整的产业级实现。
Q2:无政府代价在AI推理系统中具体意味着什么?
A:无政府代价(PoA)是衡量"系统里每个组件各自为政"比"协调合作"差了多少的指标。在AI推理里,它衡量的是贪心路由策略下的总延迟与理论最优分配相比差了多少倍。研究发现,在正常负载下PoA稳定在约7到19之间,调节路由参数几乎没有效果;但一旦系统过载,PoA会急剧攀升,这时候路由参数调节才开始有显著意义。
Q3:自适应控制器是如何做到减少等待时间的?
A:控制器每5秒监测一次生成第一个字的延迟趋势,当延迟超过预设阈值时,判断系统已进入过载状态,然后把请求流量切换到一个使用不同参数配置的备用前端——这个前端会更主动地进行负载均衡,而非一味追求缓存命中率。整个切换过程不需要重启任何组件,在340B模型上实测使稳态等待时间从约28秒降至约1秒。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
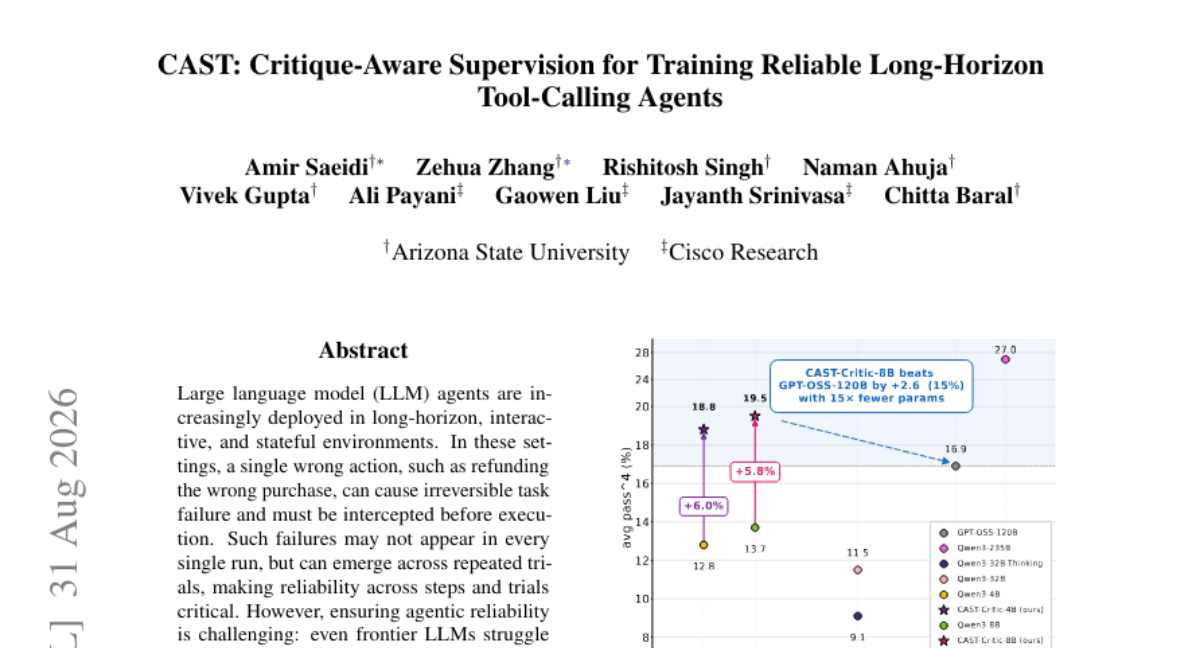
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
当机器人学会走路,却依然找不到答案
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
让AI给自己出考题:科研计划训练里那个作弊漏洞





