

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

西安交通大学团队突破:让AI"世界模型"的规划速度提升近4倍,还更准确


这项由西安交通大学研究团队完成的研究以预印本形式发布于2026年6月24日,论文编号为arXiv:2606.26217,有兴趣深入了解的读者可以通过该编号查询完整论文。
假设你是一位围棋高手,在落子之前,你需要在脑子里反复推演接下来几十步的走法。推演得越快、越准确,你赢棋的概率就越大。AI在控制机器人或游戏角色时,做的事情跟你差不多——它也需要在"脑子里"预演未来,然后再决定当下该怎么行动。这个"帮AI在脑子里预演未来"的系统,研究人员给了它一个听起来很酷的名字:**世界模型(World Model)**。
近年来,一种叫做"LeWorldModel"(简称LeWM)的世界模型系统引发了广泛关注,它无需重建画面像素,就能让AI直接在抽象的"概念空间"里推演未来,效果相当不错。然而,它有一个让工程师头疼的毛病:推演的速度太慢,而且推演步骤一多,错误就像滚雪球一样越积越大。西安交通大学的研究团队针对这个问题提出了一套名为**Fast LeWorldModel(Fast-LeWM)**的改进方案,核心思路简单而优雅——与其一步一步地走,不如直接预测"走了N步之后到哪里"。实验结果显示,这套方案将规划速度提升了近4倍,同时成功率也有所提升,可谓鱼和熊掌兼得。
---
一、AI的"脑内推演"到底是怎么运作的
要理解这项研究在做什么,先得明白AI是如何"想象未来"的。
当一个AI需要控制机器人把积木推到目标位置时,它不会直接随机尝试各种动作——那太低效了。更聪明的做法是,先在"脑子里"模拟各种可能的动作序列,挑出那个最终结果最接近目标的方案,然后再真正执行。这个"脑内模拟"的过程,依赖的正是世界模型。
具体来说,世界模型要做的事情是:给定当前的画面(比如机器人手臂和积木的位置),以及一系列计划要做的动作,预测执行完这些动作后,最终画面会变成什么样。当然,直接在像素层面预测画面太复杂——毕竟一张图片有几十万个像素点。所以研究人员先用一个"编码器"把画面压缩成一个简洁的抽象向量,就像把一部小说压缩成一段内容摘要一样。这个抽象向量叫做**潜在状态(latent state)**,可以理解为AI对当前世界的"理解概要"。
世界模型的任务,就是预测这份"理解概要"在执行一系列动作之后会变成什么样。如果预测出来的未来状态和目标状态很接近,说明这个动作序列很可能是个好方案。
LeWM在这个框架下做得相当出色,它能在不重建画面细节的情况下完成高质量的潜在状态预测,并支持基于目标图像的规划——即给AI看一张"你想要达到的最终状态"的图,让AI自己找出怎么走到那里。
---
二、老方法的致命弱点:一步一步走,错误层层叠
然而,LeWM的预测方式存在一个根本性的结构问题,用一个形象的比喻来说,就像是用接力棒传话。
假设你要在一排10个人中间传一句话,每个人只听到上一个人说的内容再转述给下一个人。就算每个人的转述误差只有一点点,传到第10个人那里,这句话很可能已经面目全非了。LeWM的预测方式正是如此:它的世界模型每次只预测"下一步"会发生什么,用公式来描述就是"下一时刻的状态 = 模型(当前状态, 当前动作)"。如果AI要规划未来5步,它就必须把这个过程重复5次,每次都把上一步预测出的"概要"当作输入,传入下一步。
这个链式结构带来两个大麻烦。第一个麻烦是速度。AI在规划时通常会同时评估数百甚至数千个候选动作序列(这个搜索过程叫做**CEM**,交叉熵方法,可以理解为AI同时在脑海中模拟成千上万种走法,然后逐步筛选最好的那些)。对于每一个候选序列,都要跑一遍完整的链式预测,这意味着大量的重复计算。在实测中,针对一个叫做"Two-Room"的任务,LeWM的动态预测模块就要花掉约31.4秒,整个规划过程耗时约54.4秒,在需要实时响应的场景里这明显太慢。
第二个麻烦更本质,就是误差积累。每一步的预测都不可能百分之百准确,总有微小偏差。关键在于,第二步的预测是以第一步"略有偏差的预测结果"为输入的,第三步又以第二步"更加偏差的预测结果"为输入……这样一路叠加下去,到了第5步、第10步,累积的误差可能已经大到让预测完全失去参考价值。用围棋来比喻,就好像你在脑子里推演第10步棋时,其实已经在推演一个根本不存在的、完全偏离实际的棋局了。
---
三、破局之道:不再"一步一步走",直接预测"走了N步后在哪"
西安交通大学团队提出的核心思路,从根本上绕开了这个链式传话的结构。
他们的做法是:**把"走了前N步的动作序列"作为一个整体单元,直接预测执行完这N步之后会到哪里,而不是中间还要经过N个预测节点。**
用更直观的比喻来说:老方法像是在走一段路时,每走一步都要重新评估自己在哪里,然后决定下一步往哪走;新方法则更像是一位有经验的导航员,他看一眼出发点和规划的完整路线图,直接告诉你"按这条路走,最终会到哪里",中间不需要每走一步都停下来重新定位。
在技术层面,这个"直接告诉你走完N步后在哪里"的能力,是通过一个关键设计实现的:**动作前缀(Action Prefix)**。给定一个包含5个动作的计划序列,研究人员不只关心这5个动作全部执行完后的结果,而是同时关心执行前1个动作后的结果、前2个动作后的结果……一直到前5个动作后的结果。这1步、2步、3步……直到5步的动作序列,就分别叫做长度为1、2、3……5的"动作前缀"。
Fast-LeWM为每个动作前缀学习一个"前缀令牌(prefix token)",这个令牌是一个紧凑的向量表示,它凝结了"执行完这段前缀动作序列会积累怎样的效果"这一信息。然后,用当前的状态摘要加上这个前缀令牌,直接预测对应的未来状态摘要,不需要再经过任何中间的预测节点。
更妙的是,得益于一种叫做"因果掩码(causal mask)"的技术——可以理解为在编码动作序列时,给每个动作戴上一个"只能看到我之前的动作,不能提前看后续动作"的眼罩——这些不同长度前缀的令牌可以在一次前向计算中同时生成。随后,并行预测器也在一次计算中同时输出所有对应的未来状态。整个过程只需要"一轮"计算,而不是LeWM的"N轮串行计算"。
---
四、具体的系统结构:三块积木搭成的新引擎
Fast-LeWM的整个工作流程由三个模块紧密协作完成,就像一条精心设计的流水线。
第一个模块是**共享视觉编码器**,这部分和LeWM基本相同,负责把当前帧以及未来各帧的图像压缩成对应的潜在状态向量。可以把它理解为一个"阅读理解机器",把一幅复杂的画面提炼成简洁的语义摘要。
第二个模块是**因果动作前缀编码器**。它接受一个由"当前状态令牌"和"各步动作令牌"拼接而成的序列作为输入。其中,当前状态令牌是把当前的状态摘要通过一个小型神经网络转换而来的,排在序列最前面作为第0个位置;后面依次跟着各步动作的嵌入向量。这个编码器内部使用了因果掩码,确保第k个位置的输出(即第k个动作前缀的令牌)只能"看到"前k步的动作和当前状态,而对第k+1步及之后的动作一无所知。这样,所有前缀令牌在一次计算中并行生成,同时保证了每个令牌只包含其对应前缀的信息,不存在"提前偷看"的情况。在实现细节上,这个编码器是一个3层、6个注意力头的Transformer,状态令牌和动作前缀令牌的维度都设为192。
第三个模块是**并行潜在预测器**。它以当前状态摘要和所有前缀令牌为输入,在一次前向传播中同时输出所有对应时间步的未来状态预测。每个前缀令牌通过一种叫做"自适应层归一化调制(AdaLN-zero modulation)"的机制来控制预测器的行为,可以理解为每个前缀令牌都是一把"钥匙",告诉预测器"用这种方式来变换当前状态,就能得到对应前缀执行完后的未来状态"。预测器本身是一个6层的残差MLP网络,隐藏层宽度为2048。整个Fast-LeWM模型共有约1790万个参数,与LeWM的约1800万个参数基本相当,说明新方法并非靠堆参数来取胜。
---
五、训练方式:用"密集监督"强迫模型真正理解动作积累效果
新架构固然重要,但训练方式同样关键。Fast-LeWM采用了一种叫做**密集前缀预测目标(Dense Prefix Prediction Objective)**的训练损失函数。
在训练时,对于一段包含当前帧和未来H帧的视频片段,以及对应的H步动作序列,模型会同时预测所有H个未来时刻的潜在状态。每一个前缀对应的预测结果,都会与真实的未来帧编码所得的潜在状态进行比较,计算差异(使用均方误差)。最终的损失是所有H个前缀预测误差的平均值。
这种"每步都要负责"的训练方式,和LeWM只监督当前一步的预测不同。在LeWM里,模型只需要对"下一步"负责;在Fast-LeWM里,模型要同时对"执行完1步后"、"执行完2步后"……"执行完H步后"的所有状态负责。这迫使模型真正学会理解动作效果是如何随着步骤的积累而演变的,而不只是学会"当前状态和一个动作能产生什么短期变化"。
此外,为了防止模型学出一种"所有状态都压缩到同一个点"的退化解(这是无监督/自监督表征学习中常见的"坍缩"问题),Fast-LeWM沿用了LeWM中的SIGReg正则化项。这个正则化项的作用,大致是强制模型让不同状态的潜在向量保持足够的多样性,不能"偷懒"地把所有东西都编码成同一个向量。
在训练配置上,除了方块推动(Cube)任务使用批次大小32外,其余环境均使用批次大小128,所有环境均训练10个轮次,与LeWM的训练协议保持一致,以确保比较的公平性。
---
六、规划时的额外技巧:自洽性检验
在规划阶段,Fast-LeWM还提供了一个可选的增强机制,叫做**自洽性检验(Self-Consistency)**。
具体来说,对于一个包含H步的候选动作序列,模型有两种方式来预测最终状态:一种是直接用长度H的前缀令牌,从当前状态一步预测到H步之后;另一种是先用一个中间长度的前缀(比如10步)预测出中间状态,再从中间状态出发,用剩余步数的前缀预测最终状态。如果这两种方式预测出来的最终状态非常接近,说明这个候选动作序列在模型眼中是"内在一致的"、"稳健的";如果两者差异很大,则说明这条路径的预测可信度较低。
在最终的候选序列评分中,除了"预测的最终状态与目标状态有多接近"这一主要评分维度之外,还可以加入这个自洽性差异作为额外的惩罚项(用一个权重系数β控制其影响程度,实验中设β=1)。当β=0时,退化回只看目标距离的纯净版本;较大的β值则让系统倾向于选择那些"无论从哪个角度预测,结论都稳定一致"的动作序列。
---
七、实验结果:速度与准确率的双重胜利
研究团队在LeWM原始论文中使用的全部四个测试环境上进行了评估,包括Two-Room(二维导航任务,智能体需要穿越房间到达目标位置)、PushT(机械臂推动T形积木到目标位置)、Reacher(机械臂末端到达目标点)和OGBench-Cube(三维场景中的方块操作任务)。
在成功率方面,单纯使用目标距离评分的Fast-LeWM在四个任务上的平均成功率从LeWM的85.8%提升至90.5%。具体来看,Two-Room从87%提升到98%,Reacher从86%提升到88%,PushT维持在96%,Cube从74%提升到80%。加入自洽性检验之后,平均成功率进一步提升至92.0%,其中PushT达到98%,Reacher达到90%,Cube达到82%,Two-Room保持98%。这些数字同时也超越了另外两个同类系统PLDM(平均79.5%)和DINO-WM(平均84.8%)。
在效率方面,以Two-Room任务为基准,LeWM的动态模块(包含动作编码和潜在状态预测两部分)在规划时需要重复调用5次,总耗时31.4秒;Fast-LeWM只需调用1次,耗时8.0秒,速度提升约3.92倍。完整的CEM规划过程(还包括目标图像编码、观测图像编码、评分计算等其他环节)从LeWM的54.4秒降至28.3秒,缩减约48%。换句话说,完成同样质量(乃至更高质量)的规划,Fast-LeWM只需要LeWM大约一半的时间。
---
八、开环预测误差:错误增长速度显著放缓
研究团队还专门测量了"开环预测误差",以评估两个模型在不依赖真实环境反馈、纯靠自身预测向前推演时的准确性。
测量方式是:给模型看第0帧的真实图像,以及未来一段时间内真实执行的动作序列,让模型预测之后各时间步的潜在状态,然后与真实图像编码得到的潜在状态进行比对,计算误差。由于规划视野H=5,动作跳帧为5(即每个计划动作实际执行5个环境步骤),t=25对应Fast-LeWM的一次最大视野预测,t=50则需要进行两次连续的最大视野预测。
结果显示,在四个任务上,Fast-LeWM在所有时间点上的预测误差都系统性地低于LeWM,并且随着时间步增加,误差的增长斜率也明显更小——研究团队用最小二乘法拟合误差曲线并计算斜率,Fast-LeWM的斜率在所有任务和预测起始点上都持续低于LeWM。这证实了动作前缀设计确实有效抑制了误差的滚雪球式积累。
研究团队还通过一个解码器,把预测的潜在状态重新还原成可视化的图像,直观展示了两个模型在长视野预测时的表现差异。从可视化结果来看,Fast-LeWM预测出的画面在较长时间跨度后仍与真实轨迹保持较好的一致性,而LeWM的预测在较长视野后出现了明显的漂移,画面内容逐渐偏离真实情况。
---
九、物理量探测实验:潜在空间里藏着更丰富的物理信息
为了进一步理解Fast-LeWM学到的潜在表征的质量,研究团队在PushT任务上进行了"物理量探测"实验,方法与LeWM原论文中的协议保持一致。
具体做法是冻结训练好的视觉编码器,然后用轻量级的探测器(分别测试线性探测器和MLP探测器两种,前者只能捕捉线性关系,后者能捕捉非线性关系)来从潜在状态向量中预测三个与任务密切相关的物理量:智能体位置、积木位置和积木角度。
结果显示,在线性探测方面,Fast-LeWM的表现与LeWM相近,两者都远优于PLDM,说明两个模型学到的潜在空间中,任务相关物理量的线性可读性相当。然而在MLP探测方面,Fast-LeWM在所有三个物理量上都取得了最低的均方误差和最高的相关系数——智能体位置探测MSE降至0.001(LeWM为0.004,PLDM为0.014),积木位置探测MSE降至0.000(LeWM为0.001,PLDM为0.011),积木角度探测MSE降至0.009(LeWM为0.021,PLDM为0.056)。这意味着Fast-LeWM的潜在空间以更加细粒度的方式保留了物理状态信息,尽管这些信息可能以较非线性的方式存储。研究团队认为,这得益于密集前缀监督:要预测不同前缀执行后的各种未来状态,模型必须在潜在表征中保留足够精细的物理状态信息来区分这些不同的未来,这比仅预测下一步变化的模型需要保留更多的状态细节。
---
十、消融实验:每一个设计选择都有其必要性
为了验证各个设计决策的必要性,研究团队进行了系统的消融实验,逐一去掉或替换Fast-LeWM的各个组件。
首先,研究团队测试了一种看起来很直观的"快速化"思路:把LeWM的每步动作跨度从原来的5个原始环境步骤直接扩大到25个,让一次预测就覆盖整个规划视野,称为"Long-Action LeWM"。这种方法同样只需要调用一次模型,应该也能减少计算量。然而结果显示,这个变体在四个任务上的成功率均大幅下滑——Two-Room从87%降至76%,Reacher从86%降至70%,PushT从96%降至80%,Cube从74%降至58%。说明仅仅把LeWM的步长拉大,并没有真正解决问题,因为这只是让单步预测的跨度更大,但没有给模型提供关于动作序列内部结构和效果积累的任何信息。
其次,研究团队测试了去掉密集前缀监督的"Terminal-only Fast-LeWM"变体,即只对最终时间步的预测施加监督,不对中间前缀的预测施加监督。这个变体的成功率(Two-Room 96%,Reacher 80%,PushT 90%,Cube 72%)明显高于Long-Action LeWM,但低于完整的Fast-LeWM(Two-Room 98%,Reacher 88%,PushT 96%,Cube 80%)。这说明动作前缀的结构化表示方式本身就比简单拼接动作更有效,但如果不对中间前缀施加显式的监督,前缀令牌就无法学到有意义的中间状态表征,最终预测质量也会打折扣。
最后,研究团队测试了去掉状态令牌的版本——即在因果动作前缀编码器中,不把当前状态信息作为第0个令牌输入,而让编码器纯粹依赖动作序列本身来生成前缀令牌。结果显示,在Three-Room和Reacher任务上,去掉状态令牌后成功率分别下降至94%和82%(完整版为98%和88%)。这验证了状态令牌的必要性:同样的动作序列在不同的起始状态下可能产生截然不同的结果(比如"向前推"这个动作,如果积木在机械臂正前方就会产生移动效果,如果不在正前方可能就没有效果),状态令牌为动作前缀的效果预测提供了不可或缺的上下文信息。
---
归根结底,Fast-LeWM做的事情看起来思路清晰:与其让AI像接力传话一样一步一步地推演未来、让误差随着步骤层层叠加,不如教会AI直接根据"从现在到未来N步的完整行动计划"来预测"执行完这个计划后会在哪里"。这个转变在数学上是优雅的,在工程上是有效的,在实验数据上也是令人信服的。
对于关注机器人智能和自主AI系统的读者来说,这项工作指向一个实用的方向:更快、更准确的规划不一定要靠更大的模型或更多的算力,有时候问题出在"向模型提问的方式"上。用"走了N步之后在哪"来代替"下一步在哪"这样一个基本问题的重新表述,就能带来接近4倍的速度提升和可观的准确率改善。
当然,这项研究目前还局限在相对简单的目标导向规划任务上,未来能否在更复杂、更开放的现实场景中保持同样的优势,以及动作前缀的思路能否推广到更长的规划视野或更高维的动作空间,都是值得期待的后续问题。对这些问题感兴趣的读者,可以通过论文编号arXiv:2606.26217查阅完整的原始研究。
---
Q&A
Q1:Fast-LeWM和LeWM的主要区别是什么?
A:LeWM的世界模型每次只预测"下一步"会发生什么,预测5步就要串行调用5次,误差层层叠加、速度慢。Fast-LeWM改为直接预测"执行完N步动作后会到哪里",所有步骤在一次计算中并行完成,动态模块速度提升约3.92倍,平均规划成功率也从85.8%提升至90.5%。
Q2:Fast-LeWM的自洽性检验是什么意思,有没有用?
A:自洽性检验是指对同一个候选动作序列,分别用"直接一步预测到最终状态"和"先预测中间状态再预测最终状态"两种路径,比较两个终态预测的差异。差异小说明这条路径的预测更稳健可信。加入这个机制后,四个任务的平均成功率从90.5%进一步提升到92.0%,效果是实实在在的。
Q3:消融实验中,为什么只把LeWM的动作步长拉大不管用?
A:把LeWM每步的时间跨度从5个环境步骤扩大到25个(Long-Action LeWM),看似也能一次预测覆盖整个规划视野,但实验中四个任务成功率全部大幅下滑。原因在于这只是让单步跨度变大,模型对动作序列的内部结构和效果如何随步骤积累一无所知;而Fast-LeWM通过前缀结构和密集监督,让模型显式学到了不同阶段的动作积累效果,本质上是不同的。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
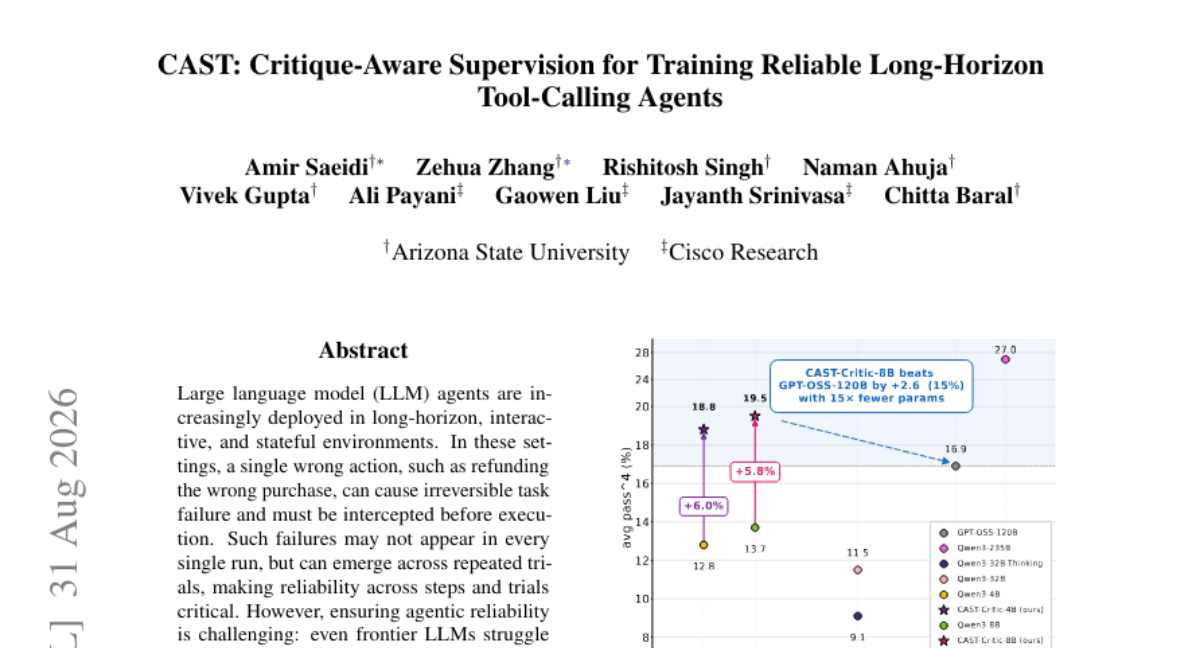
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
当机器人学会走路,却依然找不到答案
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
让AI给自己出考题:科研计划训练里那个作弊漏洞





