

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

一群机器人,如何在谁也看不到全局的情况下,对未来达成共识


想象一下这个场景。
十几台无人机在空中组成编队,风一吹,队形就会晃动。每一台无人机只能看到自己周围几个邻居在干什么,谁都看不到整个编队此刻是紧密聚集、还是正在散开、还是已经乱成一团。可是,如果每台无人机对"我们这个团队接下来会变成什么样子"的判断都不一样,接下来的动作就会互相拖后腿:有的以为大家要收拢,猛地往中心挤;有的以为大家要散开,拼命往外飞。
这不是一个"感知不准"的问题,而是一个更麻烦的问题:每个人手里的信息都不完整,而且没有一个"中央大脑"能把所有信息汇总起来告诉大家标准答案。这篇来自ITMO大学的论文,标题叫《One Future, Every Robot》,《一个未来,每个机器人》,研究的正是这件事:能不能让一群互相看不到全局、也不互相对答案的机器人,各自独立地对"团队的未来会是什么样"形成一致的判断?
这个问题看起来简单,做起来却像一个悖论:既要大家想法一致,又不能让大家互相抄答案。
问题到底难在哪
先说清楚这不是什么问题。
这不是普通的"预测每个机器人自己下一步去哪"的轨迹预测问题,那种问题里每个机器人只需要关心自己。这也不是"训练一个中央控制器去看整个战场"的中心化问题,因为现实中的机器人群体往往没有这样一个上帝视角的中枢,通信带宽有限,网络还可能随时断开。
真正的困境在于:每个机器人只能看到自己的16帧历史观测和邻居传来的一点点压缩信息,却被要求对整个团队未来的"聚集程度"、"连通性"、"任务完成度"这些只有站在上帝视角才看得清楚的指标,做出准确且彼此吻合的判断。
打个比方,这就像让十个人在完全不能交谈、只能通过传纸条给最近的邻座人的情况下,各自独立猜测"这个班级期末的平均分会是多少"。如果不能形成某种共同的理解方式,十个人猜出十个天差地别的数字,一点都不奇怪。
以往的研究其实分头解决了这个问题的两半。一半是"如何从局部信息拼凑出全局结构",像Deep Sets、图神经网络这类工作证明了局部交换的信息确实能反映出群体的隐藏状态。另一半是"如何用预测来提升多智能体的协作能力",比如MASIA用自监督的方式压缩通信内容,还有各种"世界模型"尝试把局部动态和全局聚合结合起来。
但这两条线一直没有真正交汇。
有没有一种潜在的"目标状态",能让每个机器人独立预测出来的东西,既代表整个群体作为一个集合的未来样子,又不需要靠一致性损失函数强行拉齐,而且在通信拓扑变了、群体规模变大之后依然管用?这正是这篇论文要回答的问题。
JEPA:预测意义,而不是预测像素
要理解这篇论文的解法,得先说说JEPA这个概念。
> JEPA*:全称Joint-Embedding Predictive Architecture,联合嵌入预测架构。它的核心思想是让模型去预测未来状态在一个抽象特征空间里的表示,而不是去逐像素、逐数值地重建原始数据。这个想法最早由Yann LeCun在2022年提出,后来被应用到图像、视频等多种自监督学习场景。
为什么要用JEPA而不是老老实实地重建原始数据?
设想你要向朋友描述明天的天气。你可以说"明天下午三点,气温23.6度,风速每秒2.3米,云层覆盖率47%",这是一种极度精确但极其啰嗦的描述方式,任何一点误差都会显得"预测错了"。你也可以说"明天下午多云转晴,微风",这种描述抓住了对生活真正有用的信息,忽略了那些没必要精确到小数点的细节。JEPA做的就是后一种事:它让网络学会去预测"重要的东西",而放过那些琐碎的、局部视角本来就没法达成一致的细枝末节。
这篇论文给这个架构起了个新名字,叫CS-JEPA。
> CS-JEPA*:Collective-State JEPA,集体状态联合嵌入预测架构。它训练每个机器人从自己的历史观测和邻居传来的消息里,预测出同一个固定宽度的"未来集体状态",但完全不使用任何强迫大家答案一致的损失函数。
这里有个关键设计,论文里反复强调:整个训练过程里,从来没有一个"让大家答案趋同"的损失项。研究者故意把这个"一致性损失"的权重设为零。这是一次故意冒险的实验:如果这个假设成立,如果让不同的局部视角都去够同一个目标,这些视角本身的含义就会自然对齐,那么在零一致性权重下依然能看到答案趋同,就是最有说服力的证据。但如果这个假设是错的,那么各个机器人就应该各说各话,谁也说服不了谁。
一个不会随群体变大而膨胀的目标
这里有个很实际的工程问题:如果群体里有10个机器人,目标应该是10份信息;如果群体扩大到100个,难道目标也要变成100份?这样模型的参数规模就会随群体大小失控增长。
论文的解法是设计一种"固定宽度"的目标表示,无论群体有多大,输出的维度永远不变。
具体做法是:先用一个已经训练好、之后会被冻结的"目标编码器",把未来时刻每个活跃机器人的状态都编码成一个64维向量。然后用一种叫做"锚点"的机制,把这些向量汇总成固定数量的令牌:一个代表整体的全局令牌,加上一个4乘4的空间网格,每个网格点根据距离远近加权汇总周围机器人的信息。这样无论群体是10个还是108个机器人,最终输出的都是17个65维的令牌,拼起来正好是1105维,宽度雷打不动。
这就像给一个班级拍集体照。不管班里是30人还是300人,你都可以把照片固定裁剪成一张16宫格的构图,每个格子记录这个区域大概站了多少人、他们朝哪个方向看。哪怕后来班级扩招到三倍,这张构图描述的"格式"依然不变,变的只是每个格子里承载的实际内容。如果不这样固定输出宽度,模型每次换一个班级规模就要重新设计一遍,那所谓的"可扩展性"就无从谈起。
每个机器人接收到的输入信息也有严格限制,只能看到自己过去16帧的自身状态,包括位置、速度、任务方向,以及邻居在过去16步里传来的、上一时刻的循环记忆,一个64维的浮点向量,相当于每条边每步传输256字节。这个数字被反复强调,因为它划定了一条硬边界:机器人之间传的不是"我认为未来是什么"这样的答案,而是"我现在脑子里在想什么"这样的中间过程状态。
论文里还专门设计了一个"接收方锚点",一个训练时才存在的小模块,用来预测该机器人自己未来的局部状态,防止模型为了迎合那个宏大的集体目标,把每个机器人自身的动态特征给忽略掉。这个模块在真正部署的时候会被整个丢弃,只在训练阶段发挥"稳定训练"的作用。
> GRU*:门控循环单元,一种擅长处理序列信息、能够把历史状态压缩传递下去的神经网络结构。在这篇论文里,每个机器人用GRU把自己过去的观测和邻居传来的记忆融合成一个当前的隐藏状态。
关键的对照组:如果不用JEPA会怎样
光讲CS-JEPA自己表现多好是不够有说服力的,因为你没法排除"任何靠谱的循环神经网络架构都会有这个效果"的可能性。
于是论文设计了一个几乎和CS-JEPA一模一样的对照组,叫Future-Recon,意思是"未来重建"。这个对照组用了完全相同的冻结编码器、完全相同的通信机制、完全相同的预测器结构、完全相同的1105维输出宽度,甚至连"接收方锚点"这个训练技巧都原封不动地保留。唯一的区别是:CS-JEPA预测的是抽象的潜在特征,而Future-Recon预测的是原始的位置、速度这些具体数值。
两者的参数量也几乎相同,CS-JEPA有139137个训练参数,Future-Recon因为多了一个原始数据解码器,多出9607个参数,达到148744个。部署时两者用的参数量完全一致,都是123713个。
这个设计的用意很清楚:把所有可能造成差异的因素都控制住,只留下"预测目标是抽象特征还是原始数值"这一个变量。如果不做这样严格的对照,即使CS-JEPA表现更好,你也说不清这是"预测目标选对了"带来的好处,还是"恰好这套架构更适合"的巧合。
结果:一致性和准确率同时提升
论文最核心的实验结果,用一句话概括就是:CS-JEPA训练出来的各个机器人,独立做出的预测,彼此之间变得更加一致了,同时这些预测本身也变得更准了。
这个"同时"非常重要。
因为如果只看到一致性提升,你完全可以怀疑:会不会是所有机器人都学会了输出同一个恒定的、没有信息量的答案?毕竟如果十个人永远都回答"不知道",他们之间当然是完全一致的,但这种一致毫无意义。真正有说服力的证据必须是:一致性提高的同时,预测这个未来状态的准确度也在提高。这就排除了"集体摆烂"这种可能。
论文做了一次全新的、独立的复现实验,训练了12个全新的随机种子,相当于把整个训练过程重新做了12遍,每次用不同的随机初始化,结果显示在ID测试集、拓扑结构变化的测试集、群体规模扩大的测试集上,全部12个种子都毫无例外地显示CS-JEPA比Future-Recon更一致也更准确。用统计学的语言说,这个结果的p值是0.000488,几乎不可能是偶然。
具体数字上,相对于Future-Recon,CS-JEPA的集体状态预测误差在分布内测试集上降低了28.4%,而在拓扑结构或群体规模发生变化的场景下,降低幅度达到64.4%到75.6%。
这里"拓扑结构变化"和"群体规模变化"是两种不同的挑战。前者指的是训练时用的通信网络长得像小世界网络,这是一种既有局部聚簇又有少量远距离连接的网络结构,而测试时换成了环形网络或互相k近邻网络,形状完全不同。后者指的是训练时群体规模只有10到18个机器人,测试时却要应付36、72甚至108个机器人,是训练规模的六倍。
这就好比你训练一个团队协作直觉的时候,团队一直是十来个人的小组,等真正上场比赛的时候,团队突然膨胀成六十人的大部队,而且原本熟悉的沟通结构也全变了,从小圈子互通消息变成了随机连线。如果这套预测方式只是死记硬背了训练时的场景,遇到这种巨变肯定会崩溃。但结果显示,CS-JEPA不仅没崩溃,反而在这种剧变场景下优势更明显了。这说明它学到的不是某个具体拓扑或规模下的表面规律,而是某种更本质的、可以迁移的东西。
下面这张表格是论文里的核心证据,展示的是"重建方法误差减去JEPA方法误差",正数越大代表CS-JEPA优势越明显:
| 测试场景 | 准确率提升幅度 | 一致性提升幅度 |
|---|---|---|
| 分布内测试 | 0.001568 | 0.000981 |
| 环形拓扑(分布外) | **0.048385** | **0.076685** |
| 互相k近邻拓扑(分布外) | 0.034180 | 0.045911 |
| 群体规模扩大(分布外) | 0.037714 | 0.061672 |
而且所有这些数字,在12个独立训练的种子里全部是正数,没有一个例外。
论文还专门画了一条"标签效率曲线"来展示另一个维度的证据。因为要让机器人预测出的抽象特征真正对应到"聚集程度""连通性""任务完成分数"这些人能理解的物理量,需要用一小部分带标签的数据训练一个轻量级的探针,一个简单的岭回归模型。
> 岭回归探针*:一种带正则化项的简单线性模型,这里用来把冻结的抽象特征"翻译"成人类能理解的十个具体指标,比如群体的对齐程度、连通性、碰撞比例等。用"探针"这个词是因为它只是用来检验特征里是否含有某种信息,本身不参与主体模型的训练。
在只给6、12、24个带标签的完整回合数据的情况下,注意,这个数字非常小,相当于用极少量标注数据去校准,CS-JEPA的等权重四场景平均误差分别是0.0175、0.0121、0.0103,而Future-Recon则是0.0626、0.0413、0.0287。差距在标签最稀缺的时候反而最大,这正是"标签效率"这个词想表达的意思:好的表示应该能用很少的标注数据就把有用的信息提取出来。
排除简单答案:不是靠坐标抄近道
这里有个值得警惕的陷阱。如果所有机器人共享同一套绝对坐标系,比如大家都知道"东边是正方向",那么"预测一致"很可能只是因为大家用了相同的参照系作弊,而不是真的学到了什么深层规律。
论文专门设计了一个"平移不变性"的对照实验,把绝对位置换成"相对于自己"的相对位置,把目标场也改成以群体中心为原点的坐标,同时把任务方向这个通道直接清零。这样一来,唯一还共享的只有朝向和度量尺度,绝对位置这个"作弊工具"被拿掉了。
结果显示,即便去掉了这个坐标抄近道的可能,CS-JEPA的优势依然存在:准确率误差从0.008852降到0.007248,下降18.1%;一致性误差从0.005735降到0.002729,下降52.4%。而且依然是12个种子全部支持这个结论。
这就好比原本怀疑两支球队默契十足是因为他们提前对过暗号,于是把暗号拿掉重新比一次,结果发现默契程度基本没变。这说明默契的来源不是暗号,而是某种更本质的东西,可能是对场上局势的共同理解方式。
论文还做了一个更狠的交叉验证实验:把CS-JEPA依赖的那个"目标编码器",也就是提前训练好用来生成潜在特征的模块,换成一个用原始数据重建方式训练出来的编码器。目的是排除"CS-JEPA表现好只是因为它站在了一个JEPA风格编码器的肩膀上"这种可能性。
结果是:即使把底层编码器换成"重建风格"训练出来的,CS-JEPA式的预测目标依然比Future-Recon式的预测目标表现更好,而且优势不减反增。8个独立训练的种子全部支持这一点,p值是0.0078125。这个结果相当有力地说明,真正起作用的不是编码器本身的训练方式,而是"预测抽象特征而不是原始数值"这个选择本身。
光预测得准还不够,得对决策有用
一个预测哪怕再准确,如果不能帮机器人做出更好的决定,那它的价值也要打个问号。
论文接下来测试了这个抽象特征表示能不能帮机器人评估"如果我做这个动作,会有什么后果"。他们训练了一个"动作条件"版本的模型,让每个机器人给自己设想的四步行动方案打分,衡量的指标包括任务完成度、连通性维持情况、碰撞风险。
结果显示,CS-JEPA在预测这些行动方案的实际价值上,误差比Future-Recon低了45.46%,而且在没见过的、规模是32个机器人的场景下依然保持50.62%的误差降低。这说明这个抽象特征不只是"看起来像是对的",它里面真的编码了对决策有用的信息。
最后一步测试是真正意义上的"闭环"实验:让机器人真正拿着这套预测系统去控制真实的四旋翼无人机物理模拟,用的是Crazyflie这款真实存在的微型无人机的刚体动力学模型,包含空气阻力等因素,在240赫兹的物理仿真频率下运行。每个机器人独立地在一个5乘5的"聚合程度-巡航速度"网格上打分,选出未来0.8秒的最佳方案,执行四步之后重新规划,整个过程中依然没有任何预测、打分或方案被汇总到一起。
在通信完全正常、20%丢包、单步延迟带抖动、以及丢包延迟抖动叠加异步更新这几种严苛条件下测试,CS-JEPA相对Future-Recon把综合效用提升了5.3%,在16个种子里有12个种子支持这个结论;相对完全不用学习预测、只靠固定规则飞行的基准方法,则是16个种子全部、毫无例外地支持CS-JEPA更优,p值小到0.000031。而且整个测试过程中,没有一次碰撞或者近距离碰撞事故发生。
这项研究留下的边界
论文自己也很坦诚地列出了目前的局限。
所有实验都在仿真环境里完成,还没有真正搬到硬件上跑过。共享朝向和度量尺度这个假设依然保留着,还没有测试过完全独立局部坐标系的情况。用来训练动作价值评估的"穷举分支监督",也就是让模型看遍所有可能的行动方案组合,这种做法只在训练阶段用得起,实际部署时不可能穷举所有可能性。改善了价值评估的准确度,并不直接等同于降低了"选错方案"的遗憾程度,这两者是有区别的。
这些限制意味着,这篇论文证明的是"这个思路在受控条件下是成立的",而不是"这个思路已经可以直接装到真实机器人上使用"。
写在后面
读这篇论文时最让我意外的一点,是研究者对"一致性损失权重为零"这件事的执着。很多做多智能体系统的工作,第一反应都是设计一个显式的惩罚项去逼迫智能体的输出趋同,毕竟直接优化目标最省事。但这篇论文反其道而行之,故意不这么做,把"一致性会不会自然出现"当成检验假设的核心手段。这种"故意不给捷径,看看结果会不会自己长出来"的实验设计思路,其实挺值得在别的领域借鉴的:与其强行拉齐结果,不如去问问,如果给对了共同的目标,一致性是不是本来就该自然涌现。
论文里那个"直接监督对比"的诊断实验也挺有意思。用带标注数据直接监督训练出来的模型,一致性反而比CS-JEPA更好,但准确率明显更差。这说明"更一致"和"更准确"其实是可以拆开来分别优化的两件事,CS-JEPA选择了在两者之间找一个更有实际价值的平衡点,而不是单纯追求某一个指标好看。这提醒人一件事:评价一个系统好不好,不能只看一个数字,得看这个数字背后牺牲了什么。
如果一个抽象的、谁也没见过的"共同未来"真的能让分散各处、互不通气的个体在行动上更协调,那这件事的应用边界恐怕远不止无人机编队。
Q&A
Q1:CS-JEPA是什么?
A:CS-JEPA全称Collective-State JEPA,集体状态联合嵌入预测架构,是一种让分布式机器人群体在没有中心节点、也不互相核对答案的情况下,各自独立预测同一个"集体未来状态"的训练方法,训练过程中完全不使用强迫结果一致的损失函数。
Q2:CS-JEPA和普通的重建式预测方法相比,优势体现在哪里?
A:相对于同等参数规模、只是把预测目标换成原始数值重建的Future-Recon方法,CS-JEPA在分布内测试集上误差降低28.4%,在通信拓扑或群体规模发生较大变化的场景下误差降低64.4%到75.6%,同时预测结果之间的一致性也显著提升,12个独立训练种子全部支持这一结论。
Q3:CS-JEPA的效果会不会只是因为大家共享了绝对坐标系这种简单技巧?
A:不会。论文专门做了去掉绝对坐标信息、只保留相对位置的对照实验,结果显示CS-JEPA的优势依然存在,准确率误差降低18.1%,一致性误差降低52.4%,说明优势来源不是坐标系抄近道,而是预测抽象潜在特征这个设计本身。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
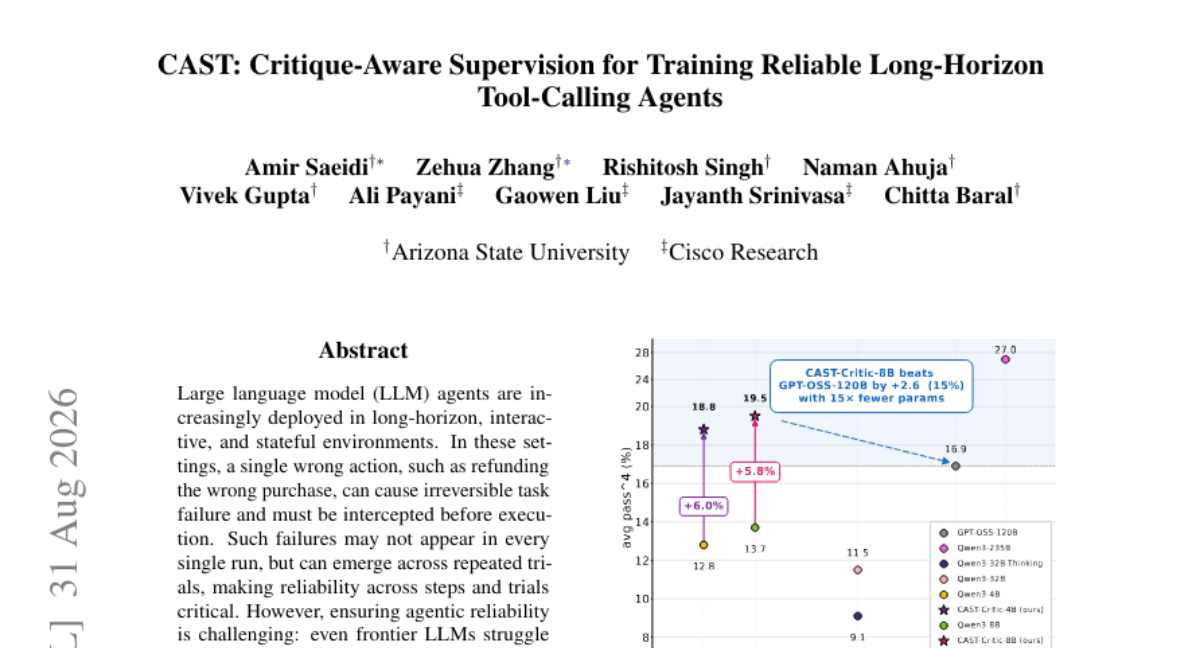
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。
AI客服退错货,AI客服帮你订错机票,这种事听起来像段子,但在真实的智能体系统里,这是每天都在发生的事故
当机器人学会走路,却依然找不到答案
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
让AI给自己出考题:科研计划训练里那个作弊漏洞





