

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

视频生成模型到底会不会“思考”?我们测了27个任务给出答案


2024年底,OpenAI发了一篇很有意思的文章,说视频生成模型可能是"世界模拟器"。这个说法一开始听起来像是营销话术,毕竟模型只是在预测下一帧像素长什么样。但接下来的一年里,好几个研究团队认真测了一下这个说法,发现事情没那么简单:这些模型在生成视频的过程中,似乎真的在"解决问题",不是死记硬背,是真的在推理。
这就有点反常识了。
你可能觉得视频生成模型的工作原理很简单,给一张图,让它接着往下"画",画出运动、画出变化,这跟"推理"有什么关系?但2025年一篇叫《Video models are zero-shot learners and reasoners》的研究发现,你给视频模型一张迷宫图片,写个提示词"让这个球走出迷宫",模型生成的视频里,球真的会绕开墙壁,找到出口。没人专门训练它做迷宫,它就是自己"想"出来的。
问题是,怎么严格地测这件事?
现有的测试方法,槃里全是坑
如果你想设计一个基准测试来验证"视频模型会推理",你会遇到三个绕不开的麻烦。
第一个麻烦是输入图片长什么样。很多现有的测试为了方便控制变量,用的是线稿图、示意图这种抽象画面,一个迷宫可能就是黑白线条画的方框,一个齿轮可能就是几个圆圈套着。这样做的好处是好生成、好控制,但坏处也很明显:视频生成模型是在海量真实照片和视频上训练出来的,它对真实世界的直觉,比如光影、材质、物理规律,是从真实图片里学来的。你给它一张抽象线稿,等于让一个只会开真车的司机去开赛车游戏里的简笔画小车,它可能连"这是个方向盘"都认不出来。
这就是VGI-Bench这篇论文提出的第一个问题:如果用抽象输入测试出来模型表现很差,你根本分不清这是因为模型不会推理,还是因为模型没见过这种画风。论文里做了个对照实验,把同一个任务换成真实照片风格和线稿风格分别测试,结果显示线稿风格下模型经常直接崩溃、忽略任务规则,尤其是开源模型对这种画风差异特别敏感。这说明视觉风格不是无关变量,它会直接污染你的测试结果。
第二个麻烦更微妙,叫做"过程敏感性不足"。
很多所谓的"视觉推理"任务,其实光看最后一帧就能判断对不对,压根不需要模型真的把中间过程走一遍。比如给模型看一张打乱的九宫格图片,问"最终应该长什么样",这种任务哪怕模型是靠瞎猜蒙出正确答案,你也没法从最终结果里看出破绽。
真正能测出"模型是不是在推理"的任务,必须是那种中间步骤本身就有对错的。VGI-Bench管这个叫过程敏感,一个任务的成功与否,取决于中间状态是否合理演变,以及是否遵守了过程中的规则,而不只是最终画面看起来对不对。
举个具体例子。汉诺塔问题的规则是每次只能移动一个圆盘。如果你只看最终的塔摆放对不对,那模型完全可能在中间偷偷移动了两个圆盘,反正最后结果一样,你根本发现不了。但如果你把整个视频过程拆开逐帧检查,就会发现这个"作弊"行为。VGI-Bench要求所有任务都得是这种类型:过程本身有意义,不能只看结局。
第三个麻烦是难度没有校准。有些基准测试里的任务,长度远远超过视频模型能生成的时长(现在主流模型也就5到10秒),或者需要专业医学知识之类的非视觉背景知识。这种任务模型做不出来,你压根不知道是因为它不会推理,还是任务本身就超纲了。
VGI-Bench的解法是设置一个"预生成筛选"阶段:每个任务先挑两个最简单难度的样例,拿几个顶尖模型(Sora2、Veo3.1、Kling3.0等)去试跑。如果所有模型都能解决,这题太简单,删;如果所有模型都解决不了,这题太难,也删。只有"至少一个模型能解决,至少一个模型解决不了"的任务才会被保留。
这就像是给学生出考卷,如果全班都能满分或者全班都零分,这份卷子就测不出任何有效信息,出题老师肯定要重新调整难度。VGI-Bench干的就是这个"调题"的工作,只不过考生换成了AI模型。
27个任务,四大领域,七种能力标签
VGI-Bench最终定下来27个任务,810个具体的测试样例,用一套两层的分类体系去组织它们。
第一层是任务领域,分四大类:
物理操作类任务考察的是移动、堆叠、使用工具这类涉及真实物理交互的场景,比如拆解绳结、组装积木;视觉组织类任务要求模型根据视觉属性对物体分类或排序,比如按颜色深浅排序拼图块;结构化谜题类任务是那种规则非常明确的解谜过程,比如走迷宫、汉诺塔、欧拉路径;时空动态类任务考察的是状态随时间变化的推理,比如时钟指针该怎么转、齿轮联动关系。
第二层是七个技能标签,一个任务可能同时挂多个标签:空间感、时间感、规划能力、属性归纳、物理直觉、拓扑理解、功能可用性判断(比如判断一个工具能不能用来干某件事)。
这套双层分类的意义在于,你不光能看到模型在"哪类任务"上表现差,还能定位到具体是"哪种能力"缺失。论文的实验结果显示,拓扑理解和时间感是所有模型的通病,普遍表现最差。这个发现挺关键的,因为拓扑理解涉及的是连通性、包含关系这类需要在多帧之间持续追踪的抽象结构,模型很难在生成过程中稳定维持这种关系。
评分怎么打:两把尺子一起量
光靠人眼扫一遍视频判断"对不对"是不够严谨的。VGI-Bench设计了两个互补的评分指标。
完整度指标衡量的是任务整体完成了多少,分三档:完成、部分完成、失败。评委模型(这里用的是Gemini-3-Flash这个视觉语言模型)会均匀抽取视频里的几帧,对照任务的标准描述,判断属于哪一档。
细则得分则是更精细的过程检查,针对每个任务设计了详细的检查清单,逐条核对视频有没有违反规则。因为有些违规可能只是一闪而过(比如小车瞬间穿墙又出来),细则检查用了一种"由粗到细"的自适应采样策略:先用较低帧率扫一遍全片,标记出可疑区间,再对这些区间用更高帧率精细复查。
这里有个设计细节值得展开说说:违规次数越多,每次新增违规带来的扣分越少。具体公式是1除以(违规次数+1)。这么设计的原因是,如果一个模型在视频里反复穿墙十次,你把它跟只穿墙一次的模型完全一视同仁地打零分,那就丢失了"程度"信息,而如果线性扣分,一次严重违规和轻微违规又区分不开。用这种递减惯性的打分方式,第一次违规扣分最重,后面重复违规的边际影响逐渐变小,这样能同时兼顾"有没有违规"和"违规到什么程度"两个维度。
最终的综合得分是把完整度和细则得分相乘。这个乘法设计很有讲究:一个视频几乎不动,会保住大部分规则(细则分很高),但完全没往目标前进(完整度很低);另一个视频看起来快要到达终点了,但过程中疯狂违反规则(完整度高,细则分低)。这两种情况都不该给高分,乘法能确保只有两方面都及格,最终得分才会高。这就像是评价一个厨师做菜,菜看起来摆盘精美但没煮熟,或者煮熟了但摆得乱七八糟,都不算合格出品,必须两个维度都过关才行。
顶尖模型只能拿51分,这个数字说明了什么
论文测试了一大批当下最先进的视频生成模型,包括Seedance2.0、Sora2、Veo3.1、Kling3.0等商业模型,以及Wan2.2、HunyuanVideo-1.5等开源模型。
结果是,表现最好的Seedance2.0综合得分只有51.0(满分100)。这是个什么概念?
这意味着,即便是当前最强的视频生成模型,在这套贴近能力边界设计的测试里,也只能勉强及格,一半对一半错。而如果用更严格的"严格成功率"(要求完整度和细则分都近乎满分才算成功),Seedance2.0的成功率只有14%,其他模型普遍在10%以下,个别开源模型甚至不到3%。
对比一下,论文还做了人类基准测试:找志愿者用真人视角去解这些任务(有的通过在图片上画路径,有的通过口头描述方案),设定合理的时间限制。人类的整体成功率是97.1%。
差距一目了然:人类基本能全对,最强AI模型只能对一半,还经常在过程中犯规。
四类典型翻车现场
论文归纳出三种反复出现的失败模式,很有意思,值得展开讲讲。
第一种叫物理坍塌。一个典型案例是,视频里一台笔记本电脑被倾斜抬起,物理常识告诉我们,放在电脑盖子上的杯子应该顺着倾斜滚下来,但生成的视频里,杯子像被强力胶粘住一样,纹丝不动。这暴露出一个问题:模型似乎学到了"倾斜的电脑"和"滚落的杯子"这两个孤立的视觉片段,但没有真正掌握它们之间的因果关系。当任务目标(比如"完成某个动作")和物理规律产生冲突时,模型倾向于牺牲物理真实性去凑一个"看起来完成了任务"的画面。
第二种叫规则违反。有个任务要求几辆小车分别在自己颜色对应的赛道上行驶,且不能越过赛道边界。生成的视频画面本身流畅自然、物理表现也合理,但小车直接跨越了不该跨的边界,画面很"真实",但违反了明确写在提示词里的规则。这跟第一种失败不一样,不是物理不合理,是压根没听懂或没遵守指令里的约束条件。
第三种叫物体状态不一致。比如小车正在穿越迷宫,画面里突然多出了第二辆一模一样的车;或者眼镜刚被移到画面右侧,下一秒又出现在了中间的书本上。这说明模型在长时间生成过程中,很难稳定"记住"物体的身份和位置,这跟人类脱口而出的物体恒常性直觉完全不同,对人来说,一个东西存在过就应该持续存在,除非有明确的原因让它消失,但对生成模型来说,每一帧似乎都有点"选择性遗忘"前面几帧发生了什么。
提示词写得再详细,也救不回来
论文做了一个很直接的实验:既然模型可能是因为"没理解清楚该怎么做"才失败,那如果直接把解题步骤写进提示词里,会不会好很多?
研究者构造了所谓的"oracle提示词",把任务的具体解法一步步写清楚,比如迷宫任务直接写"向下、向下、向右、向右、向右、向下"这样精确的移动序列,而不是笼统地说"走出迷宫"。这相当于把推理这一步骤直接抽走,只留下"照着执行"的任务。
结果是,即便给了这么详细的指引,模型表现的提升依然有限。对某些商业模型有一定帮助,但对基础能力较弱的开源模型(比如HunyuanVideo-1.5)几乎没有作用。
这个结果挺让人意外的。它说明视频生成模型的瓶颈不完全在"想不出解法",还有一部分卡在"即便告诉它解法,它也没法精确地把这个解法转化成连续、准确的视觉动作序列"。这就好比给一个不太会用筷子的人写了一份详细的用筷子说明书,理论知识全都有了,但手指的实际协调能力没跟上,光看说明书解决不了这个问题。
合成数据能救命吗?答案是:看情况
VGI-Bench还做了一个特别有价值的分析,研究已经有的一个叫VBVR的微调模型,它是在100万条抽象风格的合成数据上训练出来的,基础模型是Wan2.2。研究者想知道:这种在人造抽象数据上训练出来的能力,能不能迁移到VGI-Bench这种真实场景的任务上?
结果分成三档来看。跟训练数据结构高度重合的任务(比如迷宫、时钟这类VBVR训练集里本来就有的类似任务),微调后提升非常明显,迷宫任务从29分直接飙到87.8分,涨了将近60分。跟训练数据部分重合的任务(比如滑块拼图,训练集里有类似但不完全一样的任务),提升幅度中等。跟训练数据完全不搭边的任务(比如需要三维空间想象的展开图折叠、需要理解工具功能的任务),提升就很有限,有的甚至反而下降了。
这个规律其实符合直觉:练习和考试的内容越接近,成绩提升越明显;练习内容和考试完全不沾边,那再多练习也帮不上忙。但这里有个反直觉的细节:有个叫"解绳结"的任务,属于完全不重合的类别,微调后的整体成功率几乎没变,但细则得分从0.02涨到了0.34。研究者的解释是,微调后模型的动作变得更"收敛"、更谨慎,减少了大量违反规则的操作,虽然还是没能真正解开绳结,但至少不再乱来了。这说明合成数据训练带来的收益,有时候不是"学会了具体这个任务",而是"学会了更规矩地行动",这是一种更基础、更通用的能力迁移。
去噪过程里,模型到底在"想"什么
这是论文里我觉得最有意思的一部分分析。
视频生成模型的底层原理是扩散模型,从一堆随机噪声出发,通过很多步"去噪"逐渐还原出清晰画面。这个过程跟近期一些研究里提到的"扩散式大语言模型"(简称dLLM)的推理机制有点像:dLLM在生成文字答案时,也是从模糊到清晰逐步细化,理论上后面的步骤可以"修正"前面步骤犯下的错误,这种能力叫自我修正。
研究者好奇:视频生成模型在去噪过程中,是不是也存在类似的自我修正现象?也就是说,如果模型在去噪的早期阶段"想错了",后面的步骤有没有机会把它纠正回来?
为了验证这个问题,研究者对四个开源模型,在生成过程的不同去噪步骤上,都把当前状态解码成能看的画面,然后一步步比对:从上一个检查点到下一个检查点,画面里体现的"解法状态"发生了什么变化。总共分成六种情况标记:画面还看不清(早期步骤太模糊)、状态稳定不变、正确变错误、错误变正确(这才是真正的自我修正)、以及错误变成另一种错误。
结果相当扎心。在整个去噪过程里,"错误变正确"这种真正意义上的自我修正,占比始终低于1%,而且到了去噪进程的第四步之后(总共40步的话,也就是前10%左右)就完全不再发生了。相比之下,"一种错误换成另一种错误"这种情况反而很常见,在去噪中段能达到20%以上。
翻译过来就是:模型确实会在去噪过程中不断"改主意",但这种改动几乎从不朝着正确答案的方向走,它更像是在几个错误答案之间来回打转,而且这个"打转"的窗口非常早就关闭了,一旦过了最初那几步,答案基本就锁定了,后面的步骤只是在给这个已经定型(哪怕是错的)的答案做细节打磨。
这就好比一个人在做数学题的时候,前几分钟脑子里冒出了一个思路,虽然可能是错的,但他没有推翻重来,而是接下来所有时间都在给这个错误思路"描边上色",让它看起来更完整、更精致,却从没停下来问一句"我这个思路本身对不对"。如果模型真的具备类似人类那种"发现不对就推翻重想"的反思能力,我们应该能看到错误状态被纠正的比例随着去噪深入而上升,但实际数据显示的恰恰相反:早期几步基本决定了最终答案,后面绝大多数计算量都花在了"精修一个可能本来就错的答案"上。
这个发现对理解当前视频生成模型的局限性很关键。它意味着,如果你想让模型在复杂推理任务上表现更好,简单地增加去噪步数、让模型"多想会儿",可能收效甚微,因为它压根没有在"多想",它只是在"多描"。真正需要解决的,可能是怎么让模型在生成的最早期阶段就具备更准确的整体规划能力,或者设计出某种机制,让模型有机会真正推翻并重新生成一个方案,而不是在死胡同里反复打磨。
图像模型:一个更"干净"的对照组
除了视频模型,论文还专门测试了一批图像生成模型(比如Nano Banana Pro、GPT-Image-2等),把部分任务改造成"只生成最终结果图"的版本,这样就去掉了"过程是否合规"这个维度,纯粹考察模型能不能推理出正确的最终状态。
结果显示,Nano Banana Pro表现最好,平均成功率55.0%,也随着难度提升明显下滑(简单档62.5%,困难档52.5%)。这个结果说明VGI-Bench的任务难度梯度设计是有效的,不是所有任务一刀切地难或者一刀切地容易。但这个图像版本的测试,只能验证模型能不能"想出正确答案长什么样",回答不了"模型是否理解如何一步步达成这个答案",这也正是VGI-Bench坚持把视频作为主要评测载体的原因,视频天然携带了"过程"这个维度,而这恰恰是检验推理能力最关键的地方。
Q&A
Q1:VGI-Bench是什么?
A:VGI-Bench是一个专门用来测试视频生成模型是否具备视觉推理能力的基准测试,包含27个任务和810个测试样例,覆盖物理操作、视觉组织、结构化谜题、时空动态四大领域,要求模型通过生成的视频过程本身展现出合理的推理轨迹,而不仅仅是最终画面看起来正确。
Q2:为什么最强的视频生成模型Seedance2.0只拿了51分?
A:因为VGI-Bench的评分要求完整度和过程合规性同时达标,两者相乘得出最终分数。当前模型普遍存在物理坍塌、规则违反、物体状态不一致等问题,即便最终画面看起来接近目标,过程中也常常出现违规操作,导致综合得分被拉低。
Q3:视频生成模型在去噪过程中会自我修正错误吗?
A:几乎不会。研究发现模型在去噪早期阶段就基本锁定了答案,即便这个答案是错的,后续步骤也很少能把错误状态纠正为正确状态,真正的自我修正比例始终低于1%,且在生成进程的前10%之后就不再出现,后期步骤主要是在细化早期已经确定的(可能错误的)方案。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
AI 帮你退货却改错订单:为什么能力强的智能体,依然会搞砸不可逆业务?
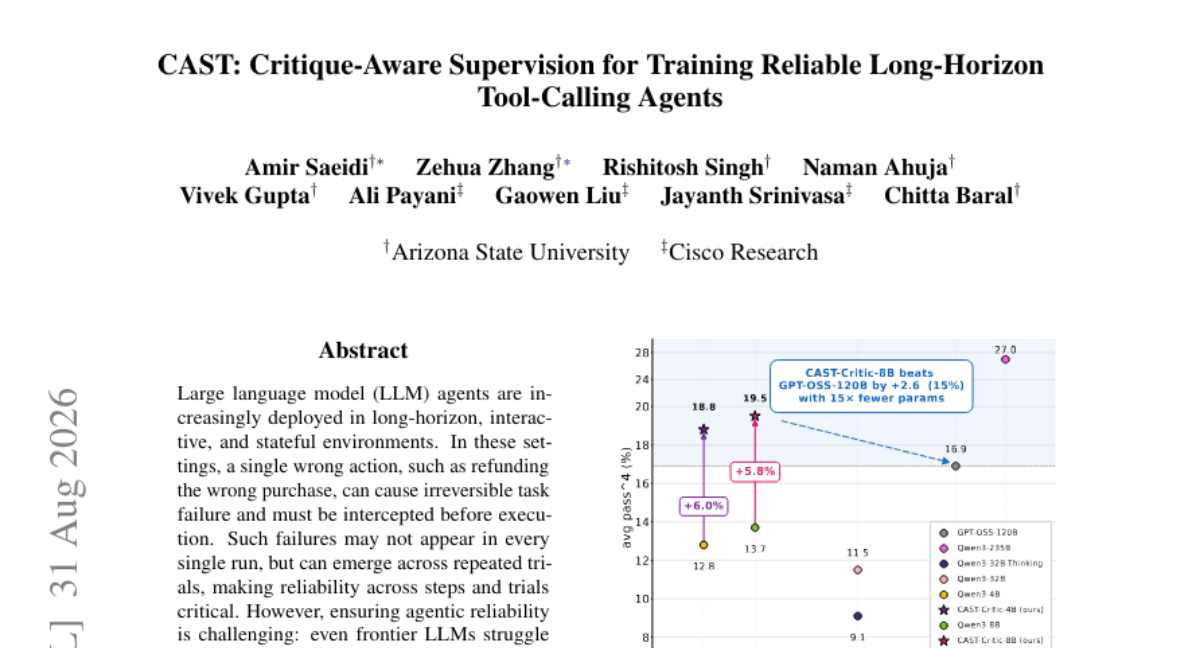
论文提出CAST框架,通过多智能体系统把任务成败的粗略反馈转化为逐步动作的详细批评理由,训练出更懂节制的批评模型,再用它优化执行策略,让8B小模型在可靠性指标上反超120B大模型,提升智能体在真实动态环境中的稳定表现。
当机器人学会走路,却依然找不到答案
论文提出NavMCP框架,用意图、观察、记忆三条通道把VLM推理与导航基础模型NFM结合,解决具身问答中长距离探索问题,在多个基准和真实机器狗测试中均取得最优效果。
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
研究发现教师模型批改学生生成内容时噪声率高达50%,但学生依然能进步。作者发现真正起作用的是压制学生自己低概率词,据此提出无需外部监督的OPSA方法,在AIME24等数学测试上带来最高307%的提升。
让AI给自己出考题:科研计划训练里那个作弊漏洞
PaperGym提出一套把科研论文转化为AI训练环境的方法,解决科研计划生成缺乏可验证奖励的难题,通过问题答案分离降低评分标准泄露,结合自蒸馏与强化学习两阶段训练,让小模型在多个基准上超越更大规模的商业模型。
AI 帮你退货却改错订单:为什么能力强的智能体,依然会搞砸不可逆业务?
当机器人学会走路,却依然找不到答案
老师没教,学生却学会了:一场关于AI蒸馏的乌龙实录
让AI给自己出考题:科研计划训练里那个作弊漏洞





