

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

雷达和光学,两张脸拍同一片地


你有没有想过,卫星拍地球,为什么有时候拍出来的图像灰扑扑、颗粒感十足,像老式电视没信号时的雪花屏,有时候又是我们熟悉的谷歌地图那种清晰彩色照片?
这两种图像其实来自完全不同的成像原理。雷达卫星靠发射微波信号再接收反射回波成像,不管白天黑夜、阴晴雨雪都能拍,缺点是图像里全是颗粒状的噪点,专业上叫斑点噪声,普通人几乎看不懂。光学卫星拍的是我们肉眼能理解的彩色画面,但云层一遮就什么都看不见了。
于是就有了一个很自然的想法:能不能让机器学会把雷达图翻译成光学图?下雨天没法拍照片,但雷达数据是现成的,如果AI能把雷达数据"翻译"成大家看得懂的光学影像,那救灾监测、农业普查这些场景就能全天候工作了。这个任务专业上叫做SAR-to-EO图像翻译,SAR指的是合成孔径雷达,EO指的是电光学,也就是我们平时看到的彩色卫星图。
这事听着简单,做起来却卡在了一个大家都没太在意的地方。
**核心问题出在哪**
这几年做这个翻译任务,主流思路是用扩散模型。不了解扩散模型也没关系,你可以把它想象成一个从雪花噪声里一点点"雕刻"出清晰图像的过程,模型学的就是怎么一步步去掉噪声、还原出目标图片。
问题是,现在流行的做法几乎都是直接套用Stable Diffusion(一款广为人知的开源图像生成模型)自带的编码解码器,也就是常说的VAE。VAE的全称是变分自编码器,它的作用是把一张大图压缩成一份更小的"压缩包"(这份压缩包在专业上叫潜空间表示),生成模型在这个压缩空间里工作会快很多,等生成完了再解压还原成图片。
这里就有个隐患。Stable Diffusion的VAE是拿海量自然图片(风景、人脸、猫狗)训练出来的,它对"怎么压缩一张自然照片再几乎无损地还原回来"这件事很擅长,但雷达图像和光学卫星图跟自然照片长得完全不一样,一个满是斑点噪声,一个是俯视视角的大片地表纹理。用一个从没见过这两种图的压缩器去处理它们,效果会打多少折扣,其实没人仔细算过。
这就好比你请了一位专门给婚纱照修图的师傅,去处理CT扫描片和卫星云图。他修图技术再好,也没在这两类图像上练过手,你直接甩给他任务,出来的效果大概率是不理想的。如果换一个真正在医学影像和遥感图像上训练过的处理流程,效果自然会好很多。这不是师傅不努力,而是压根没对上路子。
这篇来自KAIST(韩国科学技术院)团队的论文ReFlowSET,就是从这个被忽略的环节切入的。
**先把压缩器这一关考出来**
论文团队做的第一件事,特别朴素但也特别扎实:既然VAE这么关键,那就把市面上能找到的几款主流VAE都拿来考一次试。
考试方法很简单。拿一张真实的雷达图或光学图,让VAE先压缩再解压,看还原出来的图跟原图差多少,用PSNR(峰值信噪比,数值越高说明还原越接近原图,单位是分贝)来打分。这个分数其实就是给这个VAE划了一条天花板线,因为后续的生成模型再厉害,也很难超过这个"完美还原"的上限。如果VAE压缩这一步就把图糊了,后面模型学得再准也没用,就像用一台像素本来就不够的相机去拍照,就算你构图再精准,照片清晰度也提不上去。
团队测试了六款VAE,包括Stable Diffusion 2.1、SDXL、SD3.0、SD3.5,还有FLUX.1和FLUX.2,覆盖了四个不同的雷达光学配对数据集。结果很直接:FLUX.2这款编码器在八个"数据集乘以图像类型"的组合里,六个都拿了第一,而且在光学图像的还原表现上,比目前被广泛使用的SD2.1平均高出7.49分贝,这个差距相当明显。
这个结果说明一件事:过去大家默认沿用的SD2.1其实不是最优选择,只是因为它出名、大家用得多,就被后来的研究者们习惯性地继续沿用了。ReFlowSET没有继续将就,它直接把FLUX.2的编码解码器拿来用,作为整个框架的地基。
不过这里有个取舍。FLUX.2本身自带一个体积巨大、参数量以十亿计的生成模型,如果把这个庞然大物也一起搬过来,训练和推理成本会飞涨。所以团队做了个聪明的切割:只留下FLUX.2的压缩解压部分(编码器和解码器),把生成部分扔掉,自己重新训练一个小得多的生成模型。这就好比你去买一台顶级相机,机身镜头素质是真的好,但配套的自动修图软件太重太贵,你干脆只用它的镜头和感光元件,自己写一套轻量的处理程序。
**从零训练,靠什么补齐经验**
选好了压缩器,接下来要解决第二个问题:怎么设计翻译模型本身。
这里ReFlowSET用的是条件流匹配(Conditional Flow Matching)这套训练方法,配合一个叫DiT(Diffusion Transformer)的生成网络架构。
简单说说流匹配是怎么工作的。给定一堆随机噪声和一张目标光学图片的压缩表示,模型要学一条"轨迹",从纯噪声一步步走到目标图片。训练时是把噪声和目标图按比例线性混合,让模型去预测这条轨迹此刻应该往哪个方向走,这个方向专业上叫速度场。走的过程是从t=0(纯噪声)到t=1(目标图),中间用一个叫ODE求解器(常微分方程求解器)的工具沿着学到的方向一步步积分,最终走到目标点,再解压成看得懂的光学图像。
这套方法本身在图像生成领域已经比较成熟,ReFlowSET的关键改动在于:怎么把雷达图这个"条件"塞进这个从噪声到目标的过程里,让模型翻译的时候能参考雷达图里的空间结构信息。
这里论文指出了此前做法的一个隐患。之前的方法比如C-DiffSET,是把雷达图的压缩表示和当前噪声状态直接在通道维度上拼在一起,一股脑塞进模型里处理。这就好比让两个刚认识、语言不通的人立刻挤在一张桌子上共事,还没来得及互相熟悉彼此的表达习惯,就要求他们马上配合默契地完成任务。雷达图和光学图本身统计特性差得很远,一个是斑点噪声主导,一个是清晰的色彩纹理,而且现实中配对的雷达光学图像还经常存在轻微的空间错位,直接强行拼接容易让两种模态"打架",互相干扰。
ReFlowSET的解决办法是双流条件设计。具体来说,在DiT模型最开始的若干个模块(论文里设为8个),雷达信息流和光学信息流是分开走的,各自有独立的处理路径,各自先把自己的特征梳理清楚。走完这几层之后,两条流才在通道维度上拼接融合,进入后面共用的模块联合处理,最终预测出速度场。这就像两位专家先各自准备好自己领域的报告,把最关键的信息提炼出来,再坐到一起开会讨论,而不是一上来就把两堆原始素材混在一起让人现场消化。
论文里做了个对比实验来验证这个设计到底值不值。用12层模块的小模型测试,把雷达图直接拼接输入的做法FID(衡量生成图像与真实图像分布相似度的指标,越低越好)是72.865,换成双流设计加上后面会讲的语义对齐技巧后,降到70.436。同时还试过另一种融合方式,就是把两条流的每个位置的特征逐个拼接(token级融合)而不是整体通道拼接,结果发现效果几乎没差别(70.450对70.436),但训练时占用的显存从10.63GB涨到13.57GB,推理一张图的时间从1.34秒涨到2.06秒。这说明更复杂的融合方式并没有换来更好的效果,反而白白增加了成本,于是团队最终选择了性价比更高的通道拼接方案。
**没有老师带,怎么让新模型学得快**
从零训练一个生成模型有个天然的短板:它没有继承任何"见多识广"的先验知识。
打个比方,如果是在已经训练好的SD2.1基础上做微调,相当于让一个已经跑遍全国、见过成千上万种地貌的老司机去学开一辆新车型,他对"路该怎么开"这件事早就心里有数,只需要适应新车的手感。而从零训练,相当于直接把一个刚拿到驾照的新手扔上路,他要同时学开车和认路,难度自然更大。
ReFlowSET没有走"继承老司机经验"这条路(因为FLUX.2自带的生成模型太重,用不起),那怎么办呢?团队的解法是引入一个训练时才用的"陪练":拿一个叫DINOv3的视觉基础模型(Vision Foundation Model,简称VFM,指在海量图像上预训练、具备通用视觉理解能力的大模型)作为老师,让它去看清晰的、没被加噪声的真实光学图,提取出一份语义表征。
然后,DiT模型内部第8层(也就是双流刚融合完的位置)的中间特征,会被一个额外加的投影头(Projection Head,一个小型转换网络,作用是把特征映射到跟老师模型同一个语义空间里方便比较)转换后,去跟老师提取的那份干净表征做对比,用余弦相似度损失(一种衡量两组向量方向是否一致的数学指标)把两者拉近。
这里有个很重要的细节:这个"陪练老师"只在训练阶段出场,一旦训练结束,它连同那个投影头都会被直接扔掉,推理阶段完全不产生额外开销。这就像考生备考时请了一位家教辅导思路、纠正解题方法,等真正上考场的时候,家教不会跟着进考场,考生凭自己已经内化的能力独立作答,但内化的这份能力恰恰是家教辅导出来的。
如果去掉这个语义对齐环节会怎样?论文的消融实验给出了答案:在同样双流加通道融合的设置下,不加这个对齐损失时FID是71.851,加上之后降到70.436。差距虽然看起来不算特别悬殊,但考虑到这个改动完全不增加推理成本,纯粹是"免费的午餐",这笔账是划算的。而且更重要的是,这从侧面证明了从零训练的模型确实缺乏语义理解上的先验,这个语义对齐机制某种程度上补上了这个缺口。
**实际效果如何**
团队在两个公开数据集上做了系统评测:QXS-SAROPT(两万对256像素的雷达光学配对图)和SAR2Opt(两千多对600像素的高分辨率配对图)。
评价指标覆盖了几个维度:FID衡量生成图整体分布是否逼真,DISTS和LPIPS衡量感知层面的相似度(更贴近人眼直觉),SSIM和PSNR衡量像素层面的精确对齐程度。
QXS-SAROPT数据集
FID指标上,ReFlowSET拿到19.1分,和此前的SOTA方法(State of the Art,指当前公开发表中表现最好的方法)C-DiffSET的19.9打平略胜,DISTS指标上ReFlowSET是0.231,全场最优。
SAR2Opt数据集
FID从此前最好的71.8(C-DiffSET)降到66.3,相对提升7.7%;DISTS从0.211降到0.185,相对提升12.3%;LPIPS指标也是全场最低(最好)的0.522。
有意思的是像素级指标PSNR和SSIM,ReFlowSET并没有拿到最高分。论文对此的解释是,雷达图和光学图配对本身存在天然的模糊性和局部错位(同一片地表,雷达波和光学反射记录的细节本就不完全对应),过分追求像素级严丝合缝地对齐,反而可能牺牲掉图像整体的自然度和真实感。团队更看重的是感知质量和分布真实性这类指标,这也符合这个任务本身"翻译成人能看懂、看着真实"的目标,而不是逐像素复刻。
还有一个特别值得拎出来说的对比。SD2.1微调方案和C-DiffSET都是在预训练好的SD2.1权重基础上继续调整的,相当于站在巨人肩膀上。而ReFlowSET的DiT生成器是完全从零开始训练的,没有借助任何预训练的生成先验,仅仅是换了个更合适的压缩器加上更精细的架构设计,就能追平甚至超过这些站在巨人肩膀上的方案。这说明压缩器的选择本身,可能比大家以为的更重要。
论文里还专门做了个纯粹换压缩器的对照实验:同样是ReFlowSET这套框架,只把FLUX.2换回SD2.1,QXS-SAROPT上FID从19.1掉到25.5,SAR2Opt上从66.3掉到84.5,五项指标全线下滑。这个实验干净利落地证明了,效果的提升相当一部分确确实实来自于选对了压缩器,而不是模型架构魔法。
**写在后面**
读完这篇论文,最让我意外的一点其实不是模型架构上的创新,而是团队愿意花大力气去做一件听起来很"笨"的事:把六款VAE挨个拿来重新考一遍试。
这种做法在深度学习论文里其实不算常见。大部分工作默认沿用前人选定的组件,把创新点全部押注在模型结构或者损失函数设计上。但ReFlowSET提醒我们一件容易被忽视的事:一个系统里最基础的那个环节,如果从一开始就选错了,后面无论怎么调整上层设计,能达到的天花板都是被锁死的。这跟很多工程领域的教训是相通的,地基没打好,楼层设计得再精巧也没用。
另一个值得琢磨的地方是,这篇论文选择FLUX.2而不是继续等一个专门为遥感图像训练的压缩器出现,这本身也是一种务实的取舍。团队没有去从头训练一个雷达光学专用VAE(那需要更大的数据和算力投入),而是先在已有的几个选项里做减法,找到相对最优解。这提示我们,很多时候技术突破未必来自全新发明,而是来自更认真地检验已有选项。
论文最后提到未来会关注跨传感器泛化问题,也就是这套方法在没见过的新型雷达传感器数据上是否依然管用,这个问题目前还没有答案。毕竟不同雷达卫星的成像参数、噪声特性都不完全一样,一个在特定数据集上调得很好的系统,换个传感器还能不能扛住,这才是真正检验它是不是"学到了本质规律"而不是"记住了这批数据的脾气"的时刻。
Q&A
Q1:ReFlowSET是什么?
A:ReFlowSET是KAIST团队提出的一种雷达图像转光学图像的AI翻译框架,核心创新是先系统评测多款图像压缩解码器选出最适合雷达和光学图像的一款,再从零训练一个轻量的生成模型完成翻译,训练时还借助视觉基础模型做语义指导且不增加推理成本。
Q2:为什么要把雷达图翻译成光学图?
A:因为雷达卫星不受天气和昼夜限制能全天候拍摄,但图像布满噪点难以直接理解,而光学卫星图像清晰直观却容易被云层遮挡。把雷达数据翻译成光学图像风格,可以让救灾监测、农业普查等场景实现全天候可用的直观影像。
Q3:ReFlowSET相比之前的方法效果好在哪?
A:在SAR2Opt数据集上,ReFlowSET把FID指标从此前最好的71.8降到66.3,DISTS从0.211降到0.185,而且是在没有借助任何预训练生成模型的情况下,仅凭选对压缩器和架构优化就实现了这个效果。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案
论文提出动态民主同意框架,融合伯奈斯公关理论与系统动力学反馈模型,分析政治支持率如何受滚雪球增长、选民饱和、感知延迟和制度信任侵蚀四种机制影响,揭示宣传投放为何会失效甚至反噬。
让AI开一年网店,结果它把自己搞破产了
阿里巴巴团队推出E-Commerce Bench基准,让18个顶尖AI模型经营虚拟网店一年,揭示AI在长周期自主商业决策、供应商谈判防骗、现金流管理及经验学习方面存在巨大能力差异与隐藏短板。
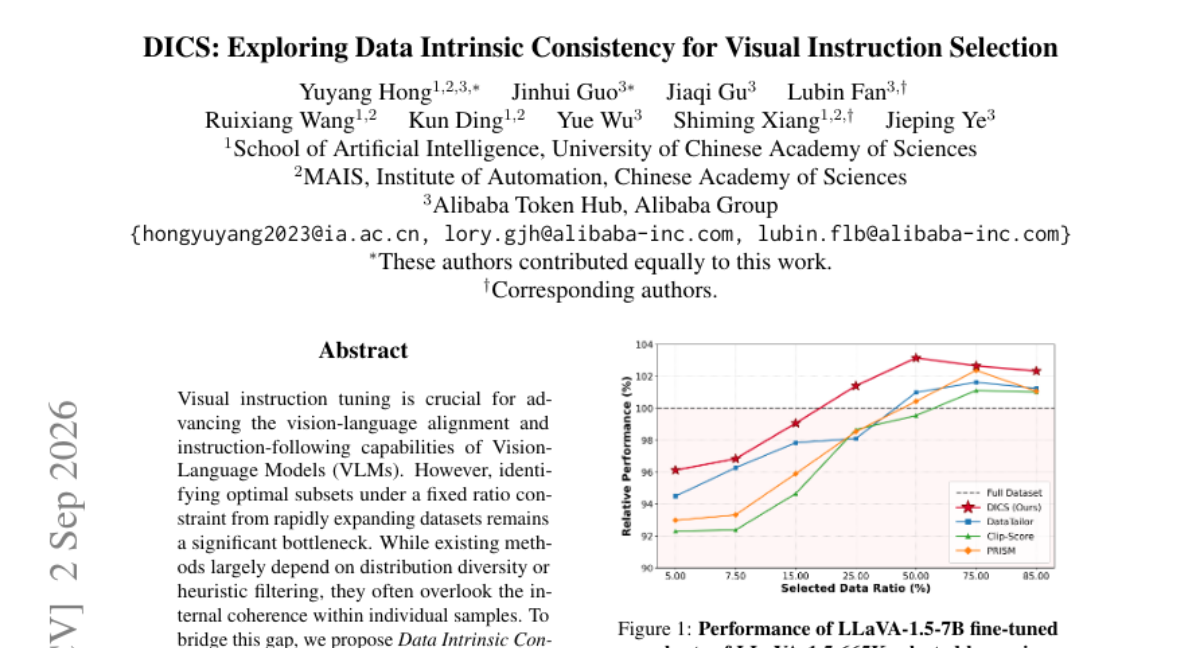
DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据
阿里团队提出DICS方法,通过评估图片、问题、答案三者的内在一致性给训练数据打分,结合自适应采样策略筛选高质量子集。仅用25%的LLaVA-1.5-665K数据训练即超越全量数据效果,并在600万样本规模验证下用不到四分之一数据逼近官方InternVL3-8B性能。
7B模型如何同时生成视频和声音,还能做到2K分辨率一步刷新
DreamX团队发布70亿参数的DreamX-Creator 1.0,首次以小体量实现原生音视频联合生成,配备门控跨模态注意力、强化学习后训练与2K一步刷新模块,权重开放,性能媲美更大规模开源系统。
政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案
让AI开一年网店,结果它把自己搞破产了
DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据
7B模型如何同时生成视频和声音,还能做到2K分辨率一步刷新





