

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

两条视频流的秘密:当深度学习第一次学会了看动作


2014年之前,如果你问计算机视觉领域的研究者一个问题:视频里的动作识别,深度学习能打过手工设计的特征吗?大概率会得到一个苦笑。
那时候深度学习已经在图像识别上闹出了大动静,AlexNet横空出世,卷积神经网络把ImageNet的错误率打得措手不及。可是一旦把静态图片换成动态视频,事情就变了。
最强的方法叫密集轨迹
密集轨迹*:一种手工设计的视频特征提取方法,通过追踪视频里密集分布的点的运动轨迹,再统计轨迹周围的图像和运动信息来判断动作类别
这种方法在UCF-101这样的动作识别数据集上能做到85%以上的准确率,而当时最好的深度学习方法只能徘徊在65%到70%之间。差了将近20个百分点。
这是什么概念。意味着每5个动作里,深度学习就要比手工方法多认错1个。这在当时几乎被当作一个既定事实:视频这种时序数据,太复杂了,卷积网络学不来。
直到牛津大学的Karen Simonyan和Andrew Zisserman发表了一篇论文,题目叫《Two-Stream Convolutional Networks for Action Recognition in Videos》,中文可以翻译成"双流卷积网络"。这篇论文第一次让深度学习在视频动作识别上打赢了手工特征。
有意思的是,Simonyan和Zisserman几个月后又发表了VGGNet,那篇后来几乎人尽皆知的图像分类网络。两篇论文几乎是同期完成的工作,出自同一个牛津实验室。这个细节本身就很说明问题:这批人当时同时在攻克静态图像和动态视频两条战线。
问题出在哪:视频比图片难在哪
要理解双流网络的巧妙之处,得先搞清楚为什么直接把图像分类的思路搬到视频上会失败。
图像分类网络处理的是一张静止的画面,网络学的是纹理、边缘、形状这些空间上的模式。一只猫和一只狗,光看一张照片就能分辨。
但动作是什么?动作是随时间变化的过程。一个人在挥手还是在拍球,单看某一帧画面,很多时候根本分不出来。你需要知道"接下来发生了什么",需要看到运动本身。
早期的研究者试过很直接的办法:把视频的连续几帧堆叠起来,直接扔进一个3D卷积网络里,让网络自己去学习哪些时序变化对应哪些动作。
这个想法听起来合理,可实验结果很打脸。网络学出来的效果远远不如手工的密集轨迹特征。为什么会这样?
一个重要原因是数据量。当时可用的视频动作识别数据集,样本量比ImageNet小了几个量级,UCF-101总共只有一万多个视频片段。而卷积网络要学会从原始像素里提炼出"运动"这种抽象概念,需要海量数据去喂。数据不够,网络学不动,只能学到一些浅层的、容易过拟合的模式。
这就像让一个从没见过足球比赛的人,只给他看几十张比赛照片,指望他总结出"传球"和"射门"的区别。他能记住的可能只是球场是绿色的、球衣的颜色,而不是动作本身的规律。如果换成给他一万张标注好的照片再加上足球比赛的规则手册,他反而能一下子抓住重点。这正是双流网络的思路,规则手册就是提前算好的光流信息。
核心思路:把运动信息直接喂给网络,而不是让网络自己去发现
Simonyan和Zisserman的关键决定是:既然网络自己从原始帧里学运动这么难,那就不要逼它自己学,直接把运动信息计算好,喂给一个专门的网络。
于是网络被拆成了两条独立的流。
第一条叫空间流
空间流*:处理单帧RGB图像的卷积网络分支,负责识别视频画面里的静态场景、物体和外观信息
它输入的就是视频里的某一帧彩色图像,负责回答"画面里有什么"这个问题,比如场景是游泳池还是篮球场,画面里有没有出现某种特定的道具。这条流本质上和普通的图像分类网络没什么区别。
第二条叫时间流
时间流*:处理光流场的卷积网络分支,负责捕捉视频里物体和人体的运动模式
它输入的不是原始画面,而是提前用传统算法算好的光流场。
光流*:描述视频中相邻两帧之间,画面上每个像素点的运动方向和速度的一种表示方法,可以理解为一张"运动地图"
光流场大概长什么样:如果你看论文里给出的示例图,会发现光流图不是彩色照片,而是一堆密密麻麻的箭头,或者用颜色编码方向和幅度的伪彩色图。一个人挥手,手臂周围的箭头会朝着挥动的方向排列,背景是静止的,箭头几乎为零。这张图直接把"什么在动、往哪动"这个信息可视化了,画面本身的颜色、纹理反而被完全剥离掉了。
这两条流各自训练一个卷积网络,各自输出对动作类别的预测概率,最后把两边的结果做加权融合,得到最终判断。
为什么要做这样的拆分,而不是让一个网络同时处理外观和运动?
这背后有个很朴素的直觉:外观信息和运动信息其实是两种性质不同的东西,一个是"是什么",一个是"怎么动"。如果强行揉在一起交给一个网络处理,网络很容易被外观信息带偏,因为外观的模式更容易学,而运动的模式更抽象、更依赖时序上下文。
这就像让一个人同时判断"这道菜是什么菜"和"厨师炒菜的手法是快炒还是慢炖"。如果只给他一张成品照片,他大概能猜出是什么菜,但很难判断烹饪手法。如果只给他厨师炒菜的手部动作录像,不给他看成品,他能感觉出节奏和力道,但不知道具体炒的是什么食材。两种信息各自擅长回答不同的问题,硬凑在一起反而互相干扰。分开判断,再把两个判断结果加权合并,往往比强行融合输入信息更靠谱。如果不这样拆分,直接把光流和RGB图像堆叠成一个多通道输入丢给单一网络,论文里的对比实验显示效果明显更差,网络很难同时兼顾两种性质迥异的信号。
![双流网络结构图]
论文里给出的结构图非常直观:左边空间流网络吃进单帧RGB图,右边时间流网络吃进堆叠起来的多帧光流场,两条线各走各的卷积层,最后在顶端汇合做分类融合。整张图看上去就是两条平行的流水线,只在最后一步交汇,这也是"双流"这个名字的来源。
时间流怎么处理时序:堆叠连续多帧光流
单看一帧光流其实信息量有限,一个瞬间的运动方向不足以判断这是挥手还是抬手。于是研究者选择把连续多帧(论文里用的是10帧)的光流场在通道维度上堆叠起来,一起输入给时间流网络。
这样网络看到的不是一个瞬间的运动快照,而是一个短时间窗口内运动的演变过程,相当于给了网络一小段"动作片段"而不是"动作截图"。
这里还有个细节,光流本身分为水平方向和垂直方向两个分量,所以10帧光流堆叠起来,实际上是20个通道的输入(每帧2个方向)。这个设计保证了网络能同时感知到运动在两个维度上的变化趋势。
为什么不直接用更长的时间窗口,比如50帧或100帧?论文里做了对比实验,发现帧数从5增加到10,性能有明显提升,但再往上增加收益就变得很小,而计算成本却直线上升。这是一个典型的性价比权衡:更长的窗口理论上信息更丰富,但计算光流本身就有成本,而且过长的窗口可能引入和当前判断无关的信息噪声。10帧左右正好踩在效果和效率的平衡点上。
数据不够怎么办:多任务训练和预训练迁移
前面提到过,视频数据集比图像数据集小得多,这对深度网络的训练是个硬伤。双流网络在这方面做了两件事来缓解数据不足的问题。
第一件事是空间流直接借用在ImageNet上预训练好的网络权重做初始化,再在动作识别数据集上微调。这是一种迁移学习的思路,相当于让网络先在海量图片上学会识别通用的视觉特征,再针对动作识别任务做小范围调整。
预训练*:先在大规模数据集上训练一个模型学习通用特征,再迁移到目标任务上进行微调的训练策略
第二件事更巧妙,针对数据量太小导致过拟合的问题,研究者引入了多任务学习。
多任务学习*:让同一个网络同时在多个相关数据集或多个任务上训练,共享底层特征表示,以缓解单一数据集数据量不足的问题
具体做法是,网络最后接了两个不同的softmax分类层,分别对应两个不同的动作识别数据集(比如UCF-101和HMDB-51),网络的卷积层部分是共享的,只有最后的分类头是各自独立的。训练时两个数据集的数据交替进来,网络被迫学出一套对两个任务都通用的特征表达,这样单个数据集数据量不够的问题就被另一个数据集的数据补上了一部分。
这个做法背后的逻辑是,两个动作识别数据集虽然类别定义不完全一样,但底层需要抓取的运动模式和外观模式是相通的。让网络在两边的数据上共同学习底层特征,等于变相扩充了训练数据的多样性。如果不做多任务训练,只在单一小数据集上训练,论文的实验显示准确率会明显下降,尤其是时间流网络,因为运动模式的学习本身就比外观模式更依赖数据量。
实验结果:到底打没打过手工特征
最关键的问题来了,这套设计到底效果怎么样。论文在UCF-101和HMDB-51两个标准数据集上做了系统的对比实验。
| 方法 | UCF-101准确率 |
|---|---|
| 仅空间流 | 72.6% |
| 仅时间流 | 81.0% |
| 空间流+时间流融合 | **88.0%** |
| 同期最好的手工特征方法 | 85.9% |
这组数字值得细看。如果只用空间流,也就是只看画面外观不看运动,准确率是72.6%。如果只用时间流,也就是只看运动不看外观,反而达到了81.0%,比空间流高了将近8个百分点。这说明对动作识别这个任务来说,运动信息本身比外观信息更关键,这也验证了研究者一开始的判断:视频动作识别的核心难点确实在于捕捉时序运动模式。
而当两条流融合之后,准确率跳到88.0%,比手工特征方法的85.9%高出了2个百分点。这是深度学习第一次在这个任务上超过手工设计的特征方法。放在2014年的背景下,这个意义不亚于AlexNet当年在ImageNet上的突破,只不过战场换成了视频。
单独看时间流比空间流效果好这件事,也印证了前面拆分两条流的设计是对的:如果两种信息真的可以互相替代,那单独一条流的效果不会有这么大差距,现在差了8个百分点,说明运动信息确实提供了外观信息给不了的东西,而两者融合之后又能进一步提升,说明两种信息也不是完全冗余,分开处理再融合,比强行揉在一起处理,是更合理的选择。
后续影响:这条路后来被怎么走下去的
双流网络提出之后,双流的思路成了视频动作识别领域接下来几年的主流范式,很多团队在这个基础上继续往前推。
2016年,Feichtenhofer等人发表了《Convolutional Two-Stream Network Fusion for Video Action Recognition》,他们发现原始双流网络只在最后的分类结果层面做简单加权融合,信息交流太晚太浅,于是提出在网络中间层就让两条流互相传递信息,进行更早期的特征级融合,这让准确率进一步提升。
2017年,Carreira和Zisserman(还是同一个Zisserman)发表了《Quo Vadis, Action Recognition》,提出了I3D网络,把双流网络里的2D卷积换成了3D卷积,同时借助更大规模的Kinetics数据集做预训练,这基本上解决了当年数据量不足的老问题,把准确率又往上推了一大截,成为后续几年视频理解领域最常用的基线模型之一。
这两篇后续工作分别从"融合方式"和"网络结构加数据规模"两个不同的方向,延续和改进了双流网络当年打开的这条路。
写在后面
读这篇论文的时候,最触动我的其实不是88%这个数字,而是研究者面对"网络学不动运动信息"这个困境时选择的解法。他们没有硬着头皮继续加大网络、加大数据去逼网络自己学出运动的概念,而是退一步,承认光流算法这种传统方法在提取运动信息上已经足够好用,直接把它当作输入喂给网络。
这种"不要什么都指望端到端自动学出来,能省的力气就先省下来"的态度,在后来的深度学习发展史里其实反复出现,包括之后很多把传统信号处理结果作为深度网络输入的做法,都能看到类似的影子。深度学习不是万能钥匙,有时候和已有的成熟方法配合,反而能更快找到突破口。
论文里还有个细节我印象很深,就是单独的时间流比单独的空间流效果更好这件事。这多少推翻了一种直觉,很多人会觉得"看清楚画面里是什么"应该比"看清楚东西怎么动"更重要,但至少在动作识别这个任务上,数据给出的答案恰恰相反。这提醒人,有时候我们对一个任务"应该关注什么"的直觉判断,未必和数据反映的真实情况一致。
Q&A
Q1:双流卷积网络是什么?
A:双流卷积网络是2014年由牛津大学Simonyan和Zisserman提出的视频动作识别方法,它用两条独立的卷积网络分支分别处理单帧图像和光流场,再融合两者的判断结果,第一次让深度学习在动作识别任务上超过了手工设计的特征方法。
Q2:双流网络为什么要分成空间流和时间流两条网络?
A:因为外观信息(画面里有什么)和运动信息(东西怎么动)是两种性质不同的信号,硬塞进一个网络容易互相干扰。分开处理再加权融合,实验证明比强行合并输入效果更好,融合后准确率达到88%,比单独任何一条流都高。
Q3:双流网络的准确率比之前的手工特征方法高多少?
A:双流网络融合后在UCF-101数据集上达到88.0%的准确率,而同期最好的手工特征方法密集轨迹是85.9%,高出约2个百分点,这是深度学习第一次在视频动作识别任务上打赢手工特征方法。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
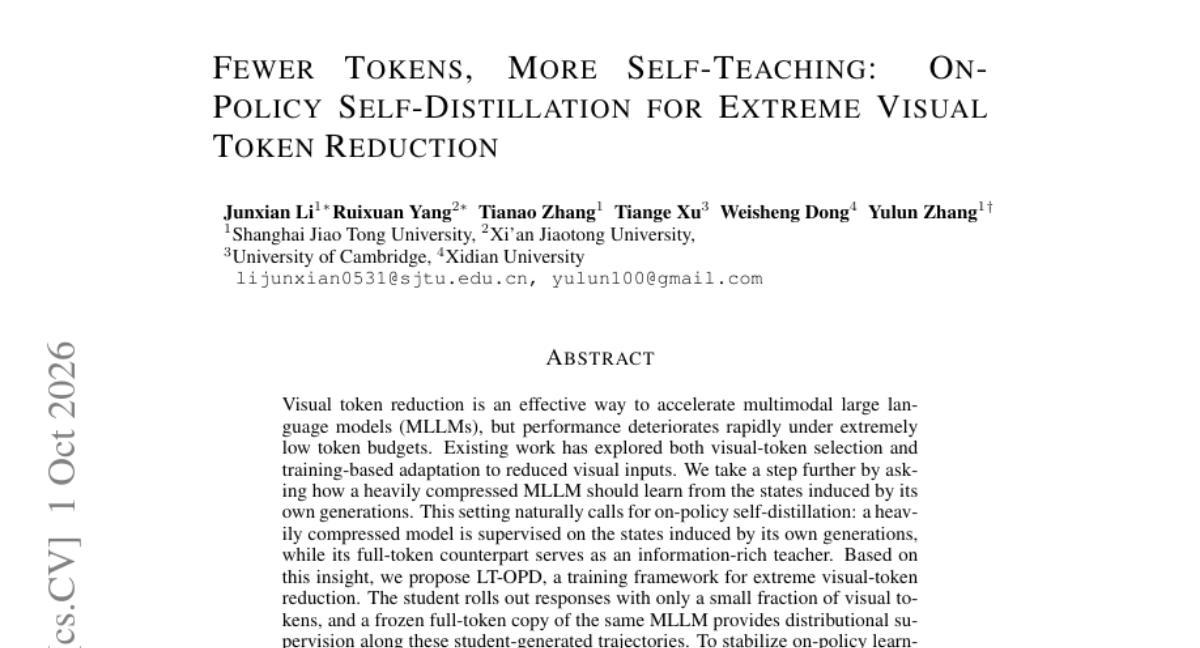
给多模态大模型做"极限瘦身"后,怎么教它重新学会看图说话
本文介绍LT-OPD训练框架,通过让极限压缩的多模态大模型在自己生成的内容上接受满血版模型指导,并配合渐进式课程学习,在仅保留5%视觉token时把性能保留率从68.6%提升到82.3%,且不增加推理成本。
AI训练的时间戳陷阱:为什么给智能体喂"标准答案"也会喂错
本文解读ALIGNOPSD方法,该方法针对AI智能体训练中"决策与时间戳错配"问题,通过先对齐功能相同的决策场景再打分,并按可变长度决策段分配信用,在ALFWorld、WebShop、Search-QA三大任务上相比GRPO提升5.5%至8.7%。
AI智能体做长任务时为什么会"失忆"?这篇论文给出了一种新解法
本文介绍自适应一致性图(ACG)方法,通过持久化执行记忆图与预算感知的上下文构建,帮助AI智能体在长任务中减少信息失联,在多项基准测试中相比ReAct等基线方法提升了任务成功率。
多智能体系统里的KV缓存困境:PReCache如何让AI团队协作提速3倍
多智能体AI协作时重复计算KV缓存浪费严重。PReCache提出预计算低秩缓存和中性基础缓存重构两项设计,免训练实现最高3.1倍加速、2.3倍吞吐提升,且准确率仅比不共享方案低1.1个百分点。
给多模态大模型做"极限瘦身"后,怎么教它重新学会看图说话
AI训练的时间戳陷阱:为什么给智能体喂"标准答案"也会喂错
AI智能体做长任务时为什么会"失忆"?这篇论文给出了一种新解法
多智能体系统里的KV缓存困境:PReCache如何让AI团队协作提速3倍





