

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

两个数据流一起看视频,比一个数据流准了将近16个百分点


2014年秋天,如果你在计算机视觉的会议上问一个搞视频识别的研究者,深度学习能不能打过手工特征,大概率会得到一个苦笑的表情。
这听起来有点奇怪。毕竟就在两年前的2012年,AlexNet已经用深度学习把图像识别的错误率砍掉了将近一半,整个学界都在往神经网络这条路上冲。可是到了视频识别这个领域,情况完全不一样。
当时最强的视频动作识别方法叫密集轨迹
密集轨迹*:一种手工设计的视频特征提取方法,通过追踪视频中密集分布的点的运动轨迹来描述动作。
这套方法在权威的UCF-101数据集上能做到88%的准确率,而同期最好的深度学习方法只能做到大约65%到70%。这中间差了将近20个百分点。
20个百分点的差距意味着什么?意味着每5个动作里,深度学习方法就要比手工方法多认错1个。放在图像识别里,这种差距是不可想象的。当时圈内不少人已经开始觉得,视频这种时序数据太复杂了,神经网络那种端到端硬学的方式根本行不通,还是老老实实设计手工特征更靠谱。
这个僵局是被牛津大学的两位研究者Karen Simonyan和Andrew Zisserman打破的。有意思的是,他们俩当时同属于牛津的VGG研究组,几个月后这个组又发表了另一篇改变整个计算机视觉领域的论文,也就是后来大名鼎鼎的VGGNet。这两篇论文几乎是同期完成的工作,这个背景本身就说明了当时那个组的研究强度。
**这篇论文第一次让深度学习在视频动作识别上超过了手工特征方法,准确率做到了88%,和密集轨迹打平甚至略有超出。**
这在2014年的分量,不亚于两年前AlexNet在图像识别上的横空出世。
问题出在哪:视频比图片多了一个维度,也多了一堆麻烦
要理解这篇论文的巧妙之处,得先搞明白视频识别到底难在哪。
图像识别只需要处理空间信息,一张照片里猫在哪、狗在哪、边缘和纹理长什么样。但视频多了一个时间维度,一个动作是"挥拍"还是"接球",光看一帧画面往往看不出来,你得看这个动作是怎么随时间展开的。
早期的深度学习方法处理视频,基本思路是把视频当成一堆图片,然后简单粗暴地在时间维度上做一些堆叠或者池化。但这样做有个致命问题,网络学到的时间信息非常弱,几乎等于没学到。原始的像素值随着时间变化,包含的运动信息其实很稀薄,大部分信息都被外观(颜色、纹理、背景)占掉了。
这就好比你想学会分辨一个人是在原地踏步还是在正常走路,如果给你的只是几张随机抽取的照片,你很难判断,因为两种动作里人的姿势可能长得差不多。但如果给你一段连续的运动轨迹,一看就明白了。
问题是,怎么才能让神经网络也"看懂"这种运动轨迹,而不是被表面的像素颜色带偏。
核心思路:把一个网络拆成两个,一个看长相,一个看动作
Simonyan和Zisserman给出的答案相当直接,他们没有硬逼着一个网络同时学会外观和运动,而是设计了两条独立的卷积神经网络通道,一条专门看"这是什么",一条专门看"它在怎么动"。
这个架构被称为双流网络
双流网络*:由两个独立的卷积神经网络组成的架构,一条处理静态画面(空间流),一条处理运动信息(时间流),最后融合两条网络的判断结果。
空间流处理的是普通的单帧RGB图像,负责识别画面里的物体、场景、人物外观这些静态信息。这条流本质上就是一个图像分类网络,可以直接用在ImageNet这种大规模图片数据集上预训练,这点非常关键,因为视频数据集当时规模都不大,单靠视频数据训练很容易过拟合,借用图像数据集的预训练权重相当于蹭了个大便宜。
时间流处理的不是原始像素,而是光流场
光流场*:描述视频相邻两帧之间每个像素点运动方向和速度的一种表示方法,可以看作是把"谁往哪个方向动了多快"这件事画成一张图。
具体来说,研究者会预先计算出视频里每两帧之间的光流,得到水平方向和垂直方向的运动矢量图,然后把连续多帧的光流图堆叠在一起,作为时间流网络的输入。这样一来,时间流网络看到的完全是运动信息,画面的颜色、纹理、背景这些干扰因素全都被过滤掉了,它只需要专心学习"这个动作的运动模式长什么样"。
两条流分别训练出各自的分类结果,最后简单地把两边的预测分数做加权平均,得到最终判断。
如果只用空间流会发生什么?论文里的实验给出了答案,单独用空间流,准确率是72.6%。单独用时间流,准确率能到81.2%。把两者融合起来,准确率跳到88%,比单独任何一条流都高出至少7个百分点,比空间流更是高出超过15个百分点。
这个结果很说明问题。**光流场里包含的运动信息,比原始像素里包含的运动信息,对分类动作的帮助大得多。**
这里可以做一个类比,想象你要判断一个人是在打网球还是打羽毛球,只给你看一张静止的照片,你可能会被球场颜色、球拍形状这些细节误导,判断错误的概率不低。但如果给你看这个人挥拍的运动轨迹曲线,哪怕背景全部抹掉,你光看动作弧度和速度变化,也能猜出个七八分。如果不把运动信息单独拎出来处理,而是让网络自己从原始像素里去悟,网络大概率会被表面的颜色纹理带偏,就像你只看照片会被球场颜色骗到一样,这正是空间流单独使用时准确率只有72.6%的原因。
时间流网络里还藏着一个细节:光流怎么塞进卷积网络
时间流网络的输入设计其实有讲究。研究者没有只用两帧之间的光流,而是把连续L帧(论文中L取10)的光流场堆叠在一起,形成一个多通道的输入。这样网络看到的不是某一瞬间的运动,而是一小段时间窗口内的运动演变过程,这对捕捉一些持续性的动作模式(比如挥拍的完整弧线)更有帮助。
另外论文还测试了两种光流表示方式,一种是直接用光流的原始向量场,另一种是先用轨迹追踪的方式把光流"拉直",消除相机运动带来的干扰。实验发现后者效果稍好一点,这也提示了一个问题,视频数据里经常混杂着摄像机本身的运动(比如镜头平移或者晃动),如果不做处理,网络可能会把镜头运动误判成动作本身的运动。
这就像你戴着一个会自己晃动的头盔去观察别人跑步,如果不修正头盔晃动带来的视野偏移,你很难准确判断对方跑步的真实速度和姿态,因为你自己视角的抖动会和对方的动作运动混在一起,分不清哪个是对方在动,哪个是你自己在晃。研究者选择先做相机运动补偿,正是为了避免网络把这两种运动混为一谈。
融合方式的选择:简单加权平均,而不是更复杂的联合训练
论文里两条流的融合方式相当朴素,就是把两条网络各自输出的softmax分数做加权平均,权重通过验证集调出来。这种做法现在看起来有点"原始",后来的很多工作都尝试了更复杂的融合方式,比如在网络中间层就做特征融合,而不是等到最后输出层才合并。
但在当时这个简单方案已经足够验证核心假设,双流分解本身是有效的,融合方式的精细化可以留给后续研究。这也是这篇论文的一个特点,它没有试图把所有能想到的技巧都堆上去,而是把最核心的一个想法(空间和时间分开处理)验证清楚,把复杂的优化留给后面的人去做。
后续的故事:这个思路被怎么继续往前推
这篇论文发表之后,双流网络成了视频动作识别领域接下来好几年的标准范式,大量后续工作都是在这个框架上做改进。
2016年,Feichtenhofer等人发表的论文进一步研究了两条流之间应该在哪个层级、用什么方式融合特征,而不是简单地在最后一层加权平均,这让融合方式变得更精细,准确率也有进一步提升。
2016年另一个重要的后续工作是Temporal Segment Networks(TSN),由Wang等人提出。这篇论文指出双流网络原始版本只是从视频里稀疏采样几个片段,没有很好地建模长时间跨度的动作,TSN通过在整段视频里稀疏采样多个片段并联合建模,把长视频的时序信息利用得更充分,进一步把准确率往上推。
再往后,3D卷积网络路线(比如I3D)开始尝试让一个网络直接同时学习空间和时间特征,而不是像双流网络这样人为拆成两条独立的路径。这条路线某种程度上是对双流网络思路的一种反思,双流网络证明了运动信息值得单独建模,但需要预先计算光流这件事本身计算量很大也很繁琐,I3D这类工作试图证明,如果网络设计得足够好,或许不需要人为拆分,网络自己就能同时学会两种信息。
这个演化过程挺有意思,双流网络先证明了"运动信息很重要,需要被认真对待",后来的工作再去想办法,怎么把这个认真对待的过程做得更自动、更高效。
表格:关键实验结果对比
| 方法 | UCF-101准确率 |
|---|---|
| 密集轨迹(手工特征,此前最强方法) | 88% |
| 仅空间流网络 | 72.6% |
| 仅时间流网络 | 81.2% |
| **双流网络融合** | **88%** |
写在后面
读这篇论文的时候,一个让我意外的地方是,研究者并没有想着让深度学习"包揽一切",反而主动借用了手工设计的光流算法来预处理数据,再把处理好的结果喂给神经网络。这在当时那种"深度学习要终结手工特征"的氛围里,其实是个挺不寻常的选择。
某种程度上说,这篇论文的成功不完全是纯粹端到端学习的胜利,而是手工先验知识(光流场是运动的良好表示)和神经网络的学习能力结合起来的胜利。这提示一个更普遍的道理,新技术不一定要完全推翻旧方法才算进步,有时候把旧方法的洞见嵌入新框架里,反而能更快突破瓶颈。
论文里还有一个细节值得单独说一说,时间流网络的预训练问题。因为当时没有大规模的视频数据集,时间流很容易过拟合,研究者用了一些数据增强和多任务训练的技巧来缓解这个问题。这说明双流网络的成功不只是架构设计的胜利,背后也有大量工程上的精细调试在撑着,论文读起来简洁,但真正让它跑起来的细节要复杂得多。
如果光流场里的运动信息这么重要,那是不是可以反过来问,人类大脑在识别动作的时候,是不是也存在类似的"分流"机制,一部分专门处理形状外观,另一部分专门处理运动轨迹?这个问题留给感兴趣的人继续想吧。
Q&A
Q1:双流网络是什么?
A:双流网络是2014年由Simonyan和Zisserman提出的视频动作识别模型,由空间流和时间流两个独立卷积网络组成,分别处理静态画面和运动信息,最后融合结果做出判断。
Q2:双流网络的准确率比手工特征方法高多少?
A:在UCF-101数据集上,双流网络融合后达到88%的准确率,和当时最强的手工特征方法密集轨迹打平,而此前的深度学习方法只有65%到70%左右,差距明显缩小。
Q3:为什么时间流网络要用光流而不是直接用原始视频帧?
A:因为原始像素里运动信息很稀薄,容易被颜色纹理等外观信息干扰,而光流场专门描述像素的运动方向和速度,能让网络专注学习动作模式,实验显示仅用光流的时间流准确率达到81.2%,远高于仅用原始帧的空间流的72.6%。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
给多模态大模型做"极限瘦身"后,怎么教它重新学会看图说话
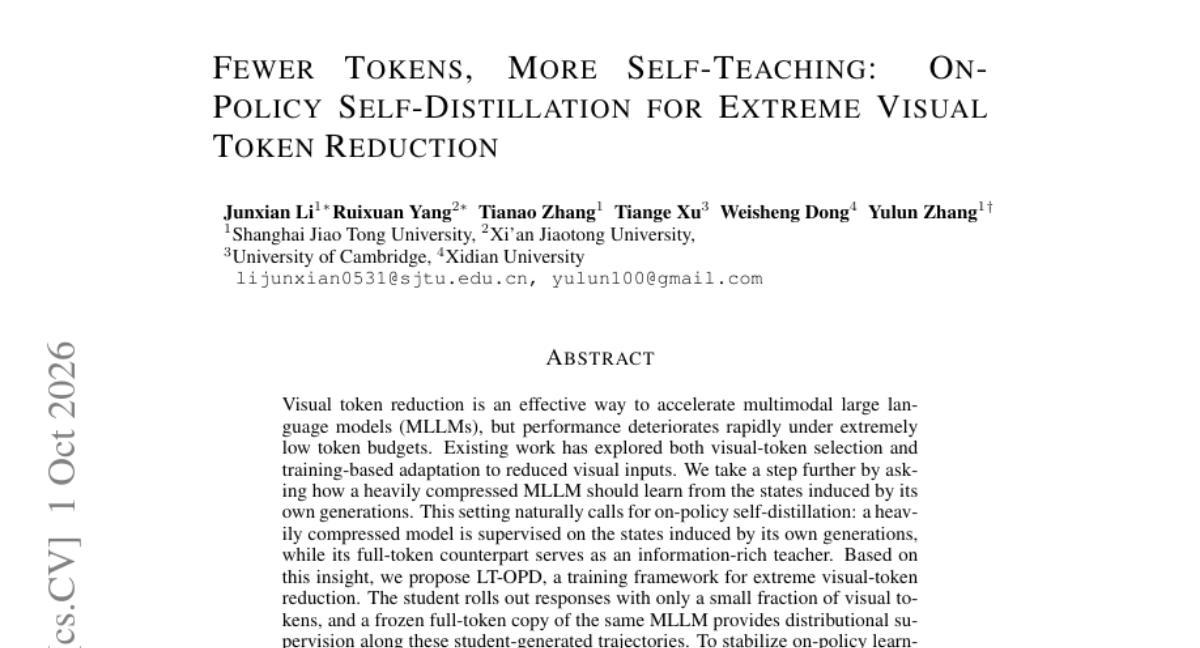
本文介绍LT-OPD训练框架,通过让极限压缩的多模态大模型在自己生成的内容上接受满血版模型指导,并配合渐进式课程学习,在仅保留5%视觉token时把性能保留率从68.6%提升到82.3%,且不增加推理成本。
AI训练的时间戳陷阱:为什么给智能体喂"标准答案"也会喂错
本文解读ALIGNOPSD方法,该方法针对AI智能体训练中"决策与时间戳错配"问题,通过先对齐功能相同的决策场景再打分,并按可变长度决策段分配信用,在ALFWorld、WebShop、Search-QA三大任务上相比GRPO提升5.5%至8.7%。
AI智能体做长任务时为什么会"失忆"?这篇论文给出了一种新解法
本文介绍自适应一致性图(ACG)方法,通过持久化执行记忆图与预算感知的上下文构建,帮助AI智能体在长任务中减少信息失联,在多项基准测试中相比ReAct等基线方法提升了任务成功率。
多智能体系统里的KV缓存困境:PReCache如何让AI团队协作提速3倍
多智能体AI协作时重复计算KV缓存浪费严重。PReCache提出预计算低秩缓存和中性基础缓存重构两项设计,免训练实现最高3.1倍加速、2.3倍吞吐提升,且准确率仅比不共享方案低1.1个百分点。
给多模态大模型做"极限瘦身"后,怎么教它重新学会看图说话
AI训练的时间戳陷阱:为什么给智能体喂"标准答案"也会喂错
AI智能体做长任务时为什么会"失忆"?这篇论文给出了一种新解法
多智能体系统里的KV缓存困境:PReCache如何让AI团队协作提速3倍





