

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

一个4B的地铁售票机,考上了GPT的分数线
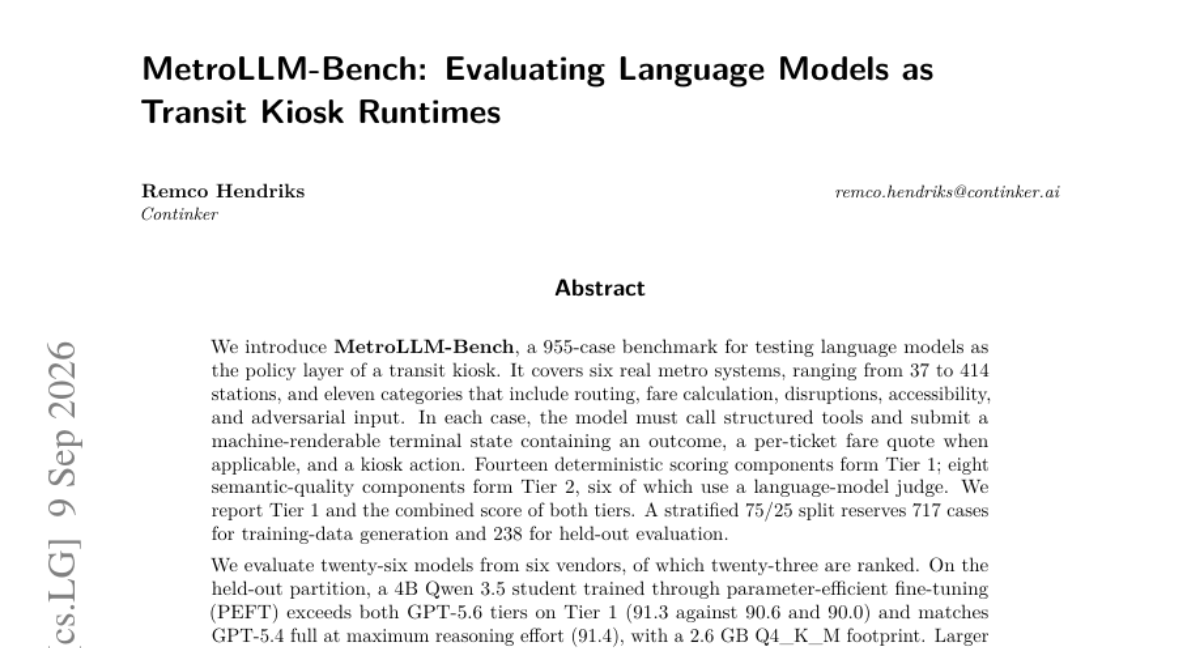


2026年9月,一份研究报告悄悄挂上了arXiv,标题听起来有点冷门:《MetroLLM-Bench:把语言模型当作地铁售票机的运行系统来评估》。
但这份报告里藏着一个挺让人意外的结果。
一个只有4B参数、压缩后只有2.6GB的开源小模型,经过一种叫做PEFT的轻量化训练方式微调之后,在某项核心指标上打平甚至反超了GPT-5.6和GPT-5.4这些顶级闭源模型。你没看错,一个能塞进普通笔记本电脑硬盘角落的小模型,在特定任务上跟动辄需要巨额算力支撑的商业API打成平手。
这事儿值得掰开揉碎讲一讲。
地铁站的售票机,为什么要用大模型
先说说这个研究到底在测什么。
你有没有在国外坐过地铁,面对一台陌生的自助售票机,试图搞清楚从A站到B站要买什么票、多少钱、遇到线路维修该怎么办?
这台机器背后,通常是一套写死的程序逻辑。
票价规则、线路拓扑、突发状况的应对方式,全部被翻译成一行行代码,焊死在系统里。
如果某天地铁公司想要调整一条票价,或者因为地震临时关闭某个站点,这个改动不是马上生效的。它得走一遍完整的软件开发流程:程序员写工单、系统集成商打补丁、测试团队跑回归测试、最后等一个发布窗口才能上线。
这个研究团队的想法是:能不能把这套"售票机大脑"换成一个语言模型?让它直接阅读一份用大白话写的规则说明书(论文里管这个叫framebook,可以理解成"系统说明书"
framebook:每个地铁系统的规则手册,用自然语言写明了术语定义、货币单位、运营时间和文化惯例,在运行时直接塞进模型的系统提示词里,不需要改代码
),然后自己决定该调用哪些工具查数据、该给乘客报什么价格、该输出什么样的提示信息。
这个思路的吸引力在于响应速度。规则变了,不用等发布窗口,改一改说明书文字就行。
但风险也很明显。地铁票价算错是要出大事的,这不是聊天机器人说错一句话那么简单,这是实打实的账单错误。所以这个任务必须同时满足四个硬指标:结果要正确,输出要能被机器直接渲染到屏幕上,面对规则变化要能灵活适应,还要留痕可追溯,方便运营方事后核查。
这就是为什么研究者选中"地铁售票机"这个场景来做测试台。它足够具体,又足够苛刻。
六座城市,955个刁钻的场景
研究团队没有随便找几个问答题糊弄事,而是真刀真枪搭建了一整套评测系统,覆盖了六个真实的地铁系统:亚特兰大MARTA(38站)、多哈地铁(37站)、旧金山BART(50站)、台北捷运(107站)、芝加哥CTA(142站)、北京地铁(414站)。
这个选择本身就有讲究。站点数从37到414不等,票价模式有三种(单一票价、按里程计费、单一票价加例外规则),货币用了四种,还特意混入了拉丁字母和非拉丁字母的站名。这样设计的目的很明确:测试模型是不是真的在"看说明书办事",而不是靠预训练时记住的常识蒙对答案。
在这六个系统里,研究团队手工设计了955个测试案例,分成十一个类别:路线规划、票价计算、突发中断、无障碍需求、文化礼节、政策问答、多轮对话、对抗性输入、时间推理、工具幻觉检测,还有复合压力场景。
举个例子会更直观。案例BART-C-006模拟的是这样一个场景:一位乘客想从奥克兰12街站坐到大使馆站,但正赶上海湾隧道因为抗震维修而关闭。模型需要先从disruption_feed(可以理解成"实时中断信息接口"
disruption_feed:六个工具之一,负责返回当前系统的服务中断、维修、延误等实时信息,模型必须主动查询才能知道
)里读到这条关闭消息,然后重新规划一条到西奥克兰站的路线,用fare_calculator算出票价,最后提交一个"仅提供建议"的状态,告诉乘客可以搭乘免费的AC Transit接驳巴士过河。
整个交互过程被设计成一个ReAct循环,模型最多有20轮机会调用工具
ReAct循环:一种让语言模型交替进行"推理"和"行动"的框架,模型先思考该做什么,再调用工具执行,然后根据结果继续思考,如此循环直到给出最终答案
,包括路线规划器、票价计算器、站点信息、线路信息、中断信息流、知识库这六个工具,最后必须调用一个叫submit_assistant_state的终止工具,提交一份结构化的"终端状态"。
这份终端状态有严格的格式要求,必须是五种结果之一:路线和票价都准备好了、仅给建议、服务不可用、请求被拒绝、或者只回答政策问题。如果格式不对,系统会返回一个HTTP 422错误,把问题打回给模型,让它在剩余轮次里自己纠正。
这个设计其实挺像真实世界的考试规则。如果一个学生答题格式错了,监考老师不会直接判零分,而是会提醒他重新检查一遍。这种"给反馈重试"的机制,让评测更贴近实际部署场景,而不是一次性的猜谜游戏。
打分不是拍脑袋,而是分成两层
评测系统里最讲究的部分,是打分机制的设计。
研究团队把评分拆成了两层。第一层叫Tier 1,包含十四个完全靠程序判断的指标,比如路线对不对、票价算得准不准、有没有调用了不存在的工具、返回的状态格式是否合法、维修中断有没有被正确识别等等。这一层的特点是不需要人或者另一个AI来主观打分,全靠代码逻辑硬碰硬地核对。
这种"能被代码直接核对"的特性非常关键,因为它同时还被用作训练小模型时的奖励信号。
第二层叫Tier 2,包含八个偏向语义质量的指标,比如说明书遵守得好不好、给乘客的建议内容够不够贴切、面对安全场景反应是否得当。其中六个指标用了一个叫Claude Haiku 4.5的小型语言模型来当裁判。
这里有个细节特别值得说一说。研究者担心这个AI裁判打分不靠谱,于是专门做了一次校准实验:找了两位独立的人类评审员,盲测打分100组案例,然后拿AI裁判的打分去跟人类比对。
结果是什么呢?AI裁判和论文作者本人打分的一致性(用一种叫加权卡帕系数的统计指标衡量,数值是0.53),竟然比两位人类评审员彼此之间的一致性(0.25)还要高。
这个结果乍一看有点反常识,好像在说AI裁判比人还靠谱。但研究团队没有止步于此,而是深挖了原因:那位独立评审员在100组打分里有89组都给了满分,打分太宽松,导致统计学上"去除偶然一致"之后的卡帕系数被严重拉低,这是一种叫"患病率悖论"的统计陷阱(评分越是一边倒,卡帕系数越容易失真,哪怕实际打分内容看起来差不多)。换用另一种不受这个陷阱影响的Gwet's AC2指标重新计算,三组评审的一致性其实都落在0.81到0.89之间,相当接近。
这说明什么?说明这个AI裁判系统,至少在这个任务上,靠谱程度确实达到了可以拿来当评测工具的水准,但研究者没有回避统计陷阱,反而主动把这个坑挖出来给读者看。这种诚实的态度,在一堆吹嘘自家评测系统多完美的论文里,算是难得。
值得一提的是,论文最终的核心结论,全部建立在Tier 1这一层完全客观的指标上,而不是掺杂了AI主观判断的综合分数。这算是一种谨慎的自我约束:哪怕AI裁判校准得再好,也不能拿它来支撑最关键的结论。
26个模型battle,谁才是地铁站的最强大脑
研究团队一口气测试了来自六家厂商的26个模型,其中23个进入了最终排名。阵容相当豪华:Qwen 3.5系列从0.8B到35B、四个经过PEFT微调的Qwen学生模型、新出的Qwen3.6和Qwen3.8、Muse Glimmer 30B、GLM-4.7-Flash、Llama 3.1-8B、三款Gemma 4变体,还有Mistral家族的几个模型,以及OpenAI的GPT-5.6和GPT-5.4系列。
在这里要解释一下PEFT
PEFT:全称是Parameter-Efficient Fine-Tuning,参数高效微调,一种不用更新模型全部参数、只训练一小部分新增参数就能让模型适应特定任务的训练方法,能大幅降低训练成本和显存占用
这个概念,以及论文里具体用的QLoRA技术
QLoRA:LoRA(低秩适配)的4比特量化版本,先把模型主体压缩到4比特精度以节省显存,再在旁边插入一个小巧的低秩矩阵进行训练,训练完成后只需要保存这个小矩阵,而不是整个模型
。简单说,这套技术让你不需要一整个数据中心的算力,用一张消费级显卡就能微调出一个专用小模型。
有两个模型系列被排除在正式排名之外,原因很有意思:Gemma 4的E2B和E4B版本,有28%到33%的案例在20轮工具调用后还没能提交合法的最终状态,直接超时失败;Llama 3.1-8B更严重,74.5%的案例出现了系统错误,36.6%的案例压根没调用终止工具。研究者专门指出,这两个模型有99.9%的场景遵守能力和100%的工具调用准确率,问题不在于"不知道该做什么",而在于"不知道该怎么把结果打包成合法格式"。
这就好比一个学生明明答对了所有题,却因为不会填涂答题卡而交白卷。能力和表达能力,是两码事。
最终排名结果显示,领跑模型是Muse Glimmer 30B,综合得分92.03分。紧随其后的是Qwen3.8-27B(91.83)和Qwen3.6-27B(91.28)。而在纯客观指标Tier 1上,反而是Qwen3.6-27B以93.63分领先。
真正的重头戏发生在第10名:一个只有4B参数、经过PEFT微调的Qwen3.5学生模型,量化压缩到2.6GB之后,Tier 1得分达到91.32分,超过了GPT-5.6的两个版本(luna中等推理强度90.63分,sol最高推理强度90.00分),和GPT-5.4满血版在最高推理强度下的91.37分几乎打平,差距只有0.05分。
4B小模型是怎么做到的
这个结果背后的训练方式,值得细说。
研究团队没有从零训练这个4B模型,而是用了一种叫"知识蒸馏"的思路:先让Qwen 3.5的27B和35B大模型(当作老师)去跑完717个训练案例,只保留那些Tier 1得分超过90%的高质量作答记录,去重之后留下600条精华轨迹,平均得分高达99.0%。
然后用这600条轨迹去训练四个不同尺寸的学生模型:2B、4B、9B、27B,全部采用QLoRA方式,固定的训练配方是秩为16、训练三轮、批次大小2。每个尺寸都独立训练了至少两次(用不同的随机种子),2B模型因为波动最大,额外训练了第三次。
整个训练过程只用了一张RTX 5090消费级显卡,累计9.4个GPU小时。单次训练最快27分钟(2B),最慢103分钟(27B)。这个硬件约束是研究团队故意设置的,目的就是验证这套流程能不能脱离数据中心级别的算力独立完成。
结果最戏剧性的地方在于:PEFT带来的提升幅度,随着基础模型能力的增强而递减,最后在27B上直接变成了负数。
具体数字是这样的:2B模型微调后提升了7.03分(三个随机种子平均),4B模型提升2.00分,9B模型提升1.65分,到了27B模型,微调后反而下降了0.91分。而且每一个随机种子在每一个尺寸上,提升或下降的方向都完全一致,没有出现"运气好就涨、运气不好就跌"的反复横跳。
这个现象可以类比成给学生请家教。一个基础薄弱的学生,请家教一对一辅导,进步空间巨大,可能一下子提高十几分。但一个已经接近满分的学霸,再请家教反而可能因为打乱了原本的做题节奏而分数略微下滑。如果不做这个"因材施教"的观察,直接假设"微调总是有用",那么在27B这个尺寸上,团队很可能会浪费大量算力去做一件不仅无效、反而有害的事情。
更有意思的是训练稳定性和这个趋势也是同步的。用三个随机种子跑出来的2B模型,得分波动幅度高达3.96分,说明这个尺寸的训练结果很不稳定,换个随机种子结果可能完全不一样。而到了27B,两次独立训练的波动幅度只有0.09分,几乎是复现级别的稳定。
研究者给出的解释是:一个能力较弱的基础模型,留给微调调整的"空间"更大,所以结果对训练过程中的随机因素更敏感;而一个已经接近任务天花板的强模型,微调能改变的东西本来就有限,自然波动也小。
这个解释挺有说服力的,但研究团队也很坦诚地指出了这个结论的局限性:这只是在这一套特定配方(QLoRA、秩16、600条轨迹、三轮训练)下观察到的现象,换一个更大的数据集或者不同的训练超参数,微调停止起作用的那个临界点可能会移动。这种不把话说满的态度,在追求"结论越劲爆越好"的学术圈里,反而显得挺难得。
脚本能做到的,和AI能做到的
为了搞清楚语言模型到底聪明在哪儿,研究团队还做了一个特别朴素但很有说服力的对照实验:写一个完全不用AI的规则脚本,按固定顺序调用路线规划器、票价计算器,再读取结构化的字段判断时间和中断情况,看它能考多少分。
这个"死板脚本"最终拿到了77.1分的综合得分和84.6分的Tier 1得分。
这个基线的意义在于划出一条清晰的分界线:哪些任务只靠固定流程就能搞定,哪些任务真的需要"临场判断"。
脚本在路线规划(93.5分)、票价计算(91.7分)、文化礼节(82.1分)这几类任务上表现相当不错,几乎接近满分模型的水平。但一旦涉及需要综合判断的场景,分数就断崖式下跌:时间推理只有52.1分,复合压力场景68.9分,无障碍需求69.7分,政策问答73.3分。
拿Qwen 27B基础模型和这个脚本做逐类对比会看得更清楚。在路线规划上,AI模型只比脚本多拿1.7分,票价计算上多拿4.6分,差距很小,说明这两类任务本质上确实是"查表+算术",AI的优势体现不出来。但在复合压力场景上,AI比脚本多拿22.8分,政策问答多拿23.4分,无障碍需求多拿21.5分,时间推理多拿21.4分。
这就好比考试里的选择题和作文题的区别。选择题只要背熟公式就能拿分,机械脚本和真人考生表现差不多;但作文题需要临场组织语言、权衡措辞、照顾读者感受,这时候死记硬背的应试技巧就不够用了,得看真本事。
语言模型真正值钱的地方,不在于它会算数,而在于它能在规则不完全明确的情况下做出合理判断。
服务器怎么配置,分数差2.7分
这份研究里还有一个特别容易被忽略、但工程上极其重要的发现:同一个模型,换一套服务器配置,分数能差出2.7分之多。
具体案例是Qwen3.8-27B和Qwen3.5-27B的对比。在统一的评测配置下(贪婪解码、4096token输出上限),Qwen3.8看起来比上一代Qwen3.5还要差3.60分,像是"越更新越退步"。
但研究团队没有轻易下这个结论,而是去深挖原因,发现问题出在两个地方。第一,Qwen3.8习惯生成更长的推理过程,在4096token的限制下,经常还没想完就被截断,根本没能提交最终答案,这种情况被系统误记为失败案例。把输出上限放宽到16384token之后,Qwen3.8立刻涨了1.72分。第二,Qwen3.8的官方模型卡建议用温度1.0、top-p 0.95的采样方式,而不是贪婪解码,换成推荐配置后又多涨了1.00分。
把这两个因素都纠正之后,Qwen3.8和Qwen3.5的差距从3.60分缩小到只有0.88分。也就是说,原本看起来"退步"的3.6分里,有2.7分根本不是模型能力的问题,而是测试者没用对配置。
这个发现挺扎心的,因为它说明:很多所谓的模型排名对比,可能压根没有公平可言,不是因为谁刻意作弊,而是不同代际的模型对服务器配置的敏感度不一样,用一套统一标准去套所有模型,反而制造出了虚假的差距。
如果不去深究这个配置差异,一个原本表现正常甚至更强的新模型,可能会被误判为"性能倒退",这种误判一旦写进报告或者产品决策,后果是实实在在的。
这就像拿同一把尺子去量两种不同材质的布料。一种布料遇冷会缩水,你要是不提前把布料泡开量,量出来的尺寸自然偏小,但这不代表这块布本来就小,只是测量方式没配合材料特性去调整。
正因为发现了这个坑,研究团队最终在正式排行榜里,给每个模型都配置了各自的最优参数,而不是强行套用一套统一标准,并且把每个模型具体用了什么配置全部写进了附录里,方便别人复现和核查。
分类别看,没有一个模型是全能王
如果只看总分,容易产生一种错觉,好像存在一个"最强模型"能碾压所有场景。但研究团队专门做了分类别的细致对比,结果打破了这个幻觉。
在十一个类别里,没有任何一个模型能拿到超过三个类别的第一名。
比如Qwen 27B基础模型在无障碍需求这一类上领先GPT-5.4满血版高达13.5分(91.1对77.6),但反过来,GPT-5.4在时间推理这一类上又领先Qwen整整13.7分(87.2对73.5)。
时间推理这个类别特别值得单独说一下,因为它暴露了不同厂商模型之间一个挺明显的能力鸿沟。GPT-5.6的两个版本在这一项上表现都很差,sol版本只拿了68.6分,是所有对比模型里最低的,甚至不如那个4B的小模型。这个短板单独拿出来看,幅度已经超过了它在综合得分上落后GPT-5.4的差距。
而那个4B的PEFT学生模型,虽然整体上打了个平手,但细看分类表现会发现它在票价计算这一类上拿到了全场最高分97.7分,在政策问答上和GPT-5.6 sol并列第一96.9分,路线规划仅次于sol排第二。它的弱项主要集中在时间推理和工具幻觉检测上。
这幅拼图告诉我们,不同模型的能力其实是"偏科"的,就像一个班里从来不存在门门功课都第一的完美学生。选择用哪个模型,得看具体业务场景里哪个类别的任务权重更高,而不是简单看一个总分排名。
写在后面
读完这份报告,最触动我的其实不是那个"4B打平GPT"的headline结论,而是研究团队处理"配置差异"那部分的态度。
大部分评测报告拿到一个"新模型不如老模型"的反常结果,很容易就直接写进去当成结论发表了。但这个团队没有,他们硬是把3.6分的差距拆开揉碎,查出2.7分其实是配置没调对,只有0.88分才是真正的能力差异。这种较真的劲头,比那个漂亮的4B数字本身更值得学习。
另一个让我意外的细节是PEFT效果随模型尺寸递减这件事。这个规律听起来符合直觉,但研究者用三个随机种子、四个尺寸、跨越两个独立测试集去反复验证同一个方向,还老老实实报告了统计置信区间,承认在最关键的留出测试集上,单独看4B模型和27B模型的差异其实统计上并不显著,只有把全部955个案例合起来看才勉强站得住脚。这种"结论没有想象中那么斩钉截铁"的自我克制,反倒让人更信这个结论。
还有个没写在结论里、但埋在附录里的小发现挺有意思:独立审核员复查答案库的时候,真的挑出了一个票价算错的案例(一个来回反悔买票的乘客场景,答案按两个成人算,但实际规则只该收一个成人的钱)。研究团队没有藏着掖着,直接公开承认并改正了这个错误。一个专门测试"AI算钱准不准"的评测系统,自己的标准答案里都能算错一次账,这事儿本身就挺有黑色幽默的意味,也提醒我们,再严谨的评测系统,底层的"标准答案"也未必绝对可靠。
这套研究留下的一个开放问题是:如果换一个更大规模、构成更丰富的训练数据集去微调那个27B模型,那个"越大越微调越退步"的现象会不会消失?研究团队自己也说这是未来值得深挖的方向。
一个装在2.6GB硬盘里的小模型,坐在地铁站的角落里,安安静静地帮陌生乘客算清楚从奥克兰到旧金山要花多少钱,同时提醒他们隧道正在维修,该去坐免费接驳车。这个画面,好像比任何排行榜上的数字,都更能说明这项技术研究到底图的是什么。
Q&A
Q1:MetroLLM-Bench是什么?
A:MetroLLM-Bench是一个专门测试语言模型能否胜任地铁售票机决策系统的评测基准,涵盖六个真实地铁系统、955个测试案例,考察模型的路线规划、票价计算、突发中断处理等能力。
Q2:4B参数的小模型真的能超过GPT-5.6吗?
A:在论文的客观指标Tier 1上,经过PEFT微调的4B Qwen模型(91.32分)确实超过了GPT-5.6的两个版本(90.63和90.00分),并且和GPT-5.4满血版最高推理强度下的成绩几乎打平,但在包含主观语义质量评估的综合得分上,4B模型仍略逊于这些顶级模型。
Q3:为什么27B大模型微调后反而变差了?
A:研究发现PEFT微调的提升幅度会随基础模型能力增强而递减,在27B这个尺寸上甚至出现了小幅下降(-0.91分)。这可能是因为强模型本身已经接近任务能力上限,留给微调调整的空间有限,而弱模型可调整的余地更大,效果也更明显。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
给多模态大模型做"极限瘦身"后,怎么教它重新学会看图说话
本文介绍LT-OPD训练框架,通过让极限压缩的多模态大模型在自己生成的内容上接受满血版模型指导,并配合渐进式课程学习,在仅保留5%视觉token时把性能保留率从68.6%提升到82.3%,且不增加推理成本。
AI训练的时间戳陷阱:为什么给智能体喂"标准答案"也会喂错
本文解读ALIGNOPSD方法,该方法针对AI智能体训练中"决策与时间戳错配"问题,通过先对齐功能相同的决策场景再打分,并按可变长度决策段分配信用,在ALFWorld、WebShop、Search-QA三大任务上相比GRPO提升5.5%至8.7%。
AI智能体做长任务时为什么会"失忆"?这篇论文给出了一种新解法
本文介绍自适应一致性图(ACG)方法,通过持久化执行记忆图与预算感知的上下文构建,帮助AI智能体在长任务中减少信息失联,在多项基准测试中相比ReAct等基线方法提升了任务成功率。
多智能体系统里的KV缓存困境:PReCache如何让AI团队协作提速3倍
多智能体AI协作时重复计算KV缓存浪费严重。PReCache提出预计算低秩缓存和中性基础缓存重构两项设计,免训练实现最高3.1倍加速、2.3倍吞吐提升,且准确率仅比不共享方案低1.1个百分点。
给多模态大模型做"极限瘦身"后,怎么教它重新学会看图说话
AI训练的时间戳陷阱:为什么给智能体喂"标准答案"也会喂错
AI智能体做长任务时为什么会"失忆"?这篇论文给出了一种新解法
多智能体系统里的KV缓存困境:PReCache如何让AI团队协作提速3倍





