

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏


你有没有玩过那种"手机全景拍照"功能?
一边转圈一边拍,最后拼成一张全景图。如果你转得太快,或者中途手抖了一下,拼出来的图往往会在接缝处出现明显的错位,墙角对不齐,地砖线条突然断掉。这种"拼接失败"的感觉,其实就是这篇论文要解决的核心问题的一个简化版本。
只不过,GeoVerse面对的问题要复杂得多:给它两张照片,它不是要拼接,而是要凭空生成一整段视频里没拍到的视角,而且生成的每一帧还得互相对得上,不能这一帧的椅子在左边,下一帧突然跑到右边去了。
**这件事到底难在哪**
新视角合成
*一句话解释:给定一个场景的几张照片,让计算机生成这个场景在其他角度、其他位置拍摄时应该长什么样。*
听起来像个魔术,但它背后有个根本性的矛盾:你既要忠实还原已经拍到的内容,又要合理"编"出没拍到的部分。这两件事其实是相互拉扯的。
早期做这件事的方法,比如NeRF(神经辐射场)和3D高斯泼溅,走的是"死磕重建"的路线。给它足够多、足够密的照片,它能把观察到的场景重建得非常精细。但问题是,一旦你要它生成一个完全没被拍到的角落,它就傻眼了,因为它压根没有"想象"这个能力,只能凭空插值,结果往往是模糊一片,或者干脆是一个空洞。
论文里提到,DL3DV这个数据集上,之前最好的方法GLD(Geometric Latent Diffusion,几何潜在扩散模型)的PSNR只有17.38分(这是衡量图像质量的一个指标,越高越好),而GeoVerse把它提到了19.61,涨了2.23分。这个差距听起来不大,但放到图片上看,是从"能看出来是什么但边缘发糊"到"细节清晰、纹理逼真"的跨越。
后来出现了另一条路,就是拿视频生成模型来硬上。既然视频模型见过海量的真实世界视频,它对"这个场景接下来应该长什么样"是有直觉的。ViewCrafter就是这条路的代表,它把点云线索和视频扩散模型结合起来。但这条路有个致命伤:视频模型是一帧一帧往下生成的,生成到第十帧的时候,它已经不太记得第一帧长什么样了,于是画面会慢慢"跑偏",专业说法叫累积漂移。想象你玩"传话游戏",第一个人说"红色的沙发",传到第十个人可能就变成"橙色的椅子"了,这就是视频模型逐帧生成时会遇到的信息衰减问题。
GeoVerse的作者们显然是同时看到了这两条路各自的短板:几何方法稳但不会"编",视频方法会"编"但不稳。于是他们的思路就变成了,能不能把两者的优点拼在一起?
**在几何的骨架上,长出视频的血肉**
GeoVerse的第一个关键设计,是选择在几何潜在空间里做生成,而不是直接在图像像素空间或者标准的视频潜在空间里生成。
深度潜在扩散模型(Geometry Latent Diffusion, GLD)
*一句话解释:不直接生成图片像素,而是先在一个专门描述"空间结构"的特征空间里生成,这个空间来自一个叫Depth Anything 3的3D基础模型,它对深度和相机位姿有很强的理解能力。*
这个选择背后的逻辑是:标准的图像或视频潜在空间,擅长表达"这个东西看起来是什么样子",但对"这个东西在三维空间里的位置关系"理解得很弱。而几何潜在空间正好相反,它天生就带着空间结构信息,跨视角的对应关系更稳。
但几何潜在空间也有短板,它是在相对有限的训练数据上学出来的,对"没见过的野生场景"泛化能力不够,也就是论文里说的GLD"受限于训练分布,在真实世界场景中生成保真度和稳定性都不足"。
这就是为什么GeoVerse要往这个空间里注入视频生成模型的先验知识。他们选用的是Wan2.2 VACE。
Wan2.2 VACE
*一句话解释:一个在海量视频数据上训练出来的高容量视频扩散模型,VACE是它的一个扩展模块,专门用来处理参考图像、视频编辑、补全等各种视觉条件输入。*
具体做法是,从Wan2.2 VACE里提取多个层级的中间特征,通过一种类似ControlNet的适配器结构,把这些特征作为"额外提示"注入到几何扩散模型里。
ControlNet风格适配器
*一句话解释:一种给预训练模型添加额外控制信号的技术,通过零初始化的卷积层保证一开始不会破坏原模型的能力,训练过程中再逐渐学会怎么利用新信息。*
这里有个细节特别值得说一下:GeoVerse并不是让视频模型去生成完整的一段视频再拿来用,而是只让它做一次前向推理,提取中间层的特征,这些特征在整个几何去噪过程中被反复复用。这样既拿到了视频模型的"审美直觉",又不用承担生成完整视频的巨大计算开销。
这就好比你请一位见多识广的室内设计师来帮你参考装修风格,但你不需要他把整套房子从头到尾画出来,只要他扫一眼你的房间照片,给你几句关于配色和布局的建议就够了。如果非要让设计师完整地画出一整套装修图纸(也就是让视频模型完整生成视频),耗时会成倍增加,而GeoVerse想要的只是那份"直觉",不是完整的画作。
**给场景配一个不会失忆的记事本**
如果说视频先验解决的是"单次生成质量不够好"的问题,那第二个核心设计解决的就是"多次生成会互相打架"的问题。
设想这样一个场景:你先让GeoVerse从两张房间照片生成三个新视角,接下来你想继续往房间深处探索,再生成三个更远的视角。如果每一轮生成都是独立进行、互不参考,那很可能第二轮生成的沙发颜色和第一轮对不上,或者墙上的画在第二轮里凭空消失了。
论文给出的解决方案是全局空间记忆。
全局空间记忆(Global Spatial Memory)
*一句话解释:一个持续累积的彩色点云,每生成一轮新视角,就把这一轮观察到的内容(颜色、深度、位置)反投影融合进这个点云里,成为一个越来越完整的场景"记事本"。*
关键在于,当GeoVerse要生成下一批目标视角时,它会先把这个记忆点云投影到目标相机的视角上,生成一份RGB-D(彩色加深度)的"提示图",外加一个标记哪些像素是已知、哪些是未知的有效性掩码。这份投影提示会作为条件输入给几何扩散模型,告诉它"这部分内容之前已经见过了,请照着来",而对于没见过的区域,则放手让生成模型去合理想象。
这个设计像什么呢?有点像你在玩一个大型开放世界游戏,比如某些沙盒建造游戏,地图会随着你的探索逐渐"点亮"。你走过的区域会被永久记录在小地图上,哪怕你转身往回走,那些区域也不会凭空消失或者变样。如果游戏没有这个记忆机制,每次你转头,系统都要重新猜测你身后是什么,那你很快就会发现,回头看到的房间和刚才离开时完全不一样了,这种体验是灾难性的。GeoVerse的空间记忆本质上就是给三维场景生成装上了这么一张"已探索地图"。
实验数据也印证了这套机制的价值:在Mip-NeRF 360数据集上,GeoVerse的ATE(绝对轨迹误差,衡量相机位姿估计准确性的指标)只有0.071,比GLD的0.105低了32.4%。消融实验里,去掉空间记忆之后,PSNR从19.65掉到17.87,ATE也从0.009涨到0.014,说明这个记忆模块确实不是可有可无的装饰。
**把100秒的等待压缩到9秒**
前两个设计解决了"生成质量"和"多轮一致性"的问题,但还有一个很现实的问题:这套系统跑起来要多久?
论文提到,原始的GLD跑一次推理要169秒,这在实际应用里几乎是不可接受的,谁也不想为了看一眼新角度的房间图,干等将近三分钟。
GeoVerse用了一种叫做reflow蒸馏的技术把这个时间压缩到了9.24秒。
Reflow蒸馏(Piecewise Reflow Distillation)
*一句话解释:扩散模型原本需要几十步甚至上百步的"去噪"迭代才能从随机噪声变成清晰图像,reflow蒸馏训练一个学生模型,让它学会把原本需要多步走完的路径拉直,用更少的步数走完同样的距离。*
具体做法是把整个去噪轨迹切成几段,每段单独训练一个"直线捷径",让学生模型学会一步跨过原本需要好几步才能走完的距离。GeoVerse最终把主要的几何生成部分(Level-1)压缩到了3步,配合Level-0级联的1步微调,总共只用4步就能完成一次生成。
这就像是原本你要去某个地方需要绕好几个红绿灯路口,但后来发现其实中间有条直接打通的近道,一步就能到。论文里做了详细的步数对比实验:如果把Level-1步数从3步砍到1步,速度从9.24秒降到6.07秒,但LPIPS(一种衡量图像感知相似度的指标,越低越好)从0.339恶化到0.367,砖墙纹理和物体边界会明显变糊。这说明步数不是越少越好,3步是他们找到的一个质量和速度的平衡点。
而Level-0级联部分,从49步砍到1步,LPIPS几乎没变化(0.339对比0.342),却省下了大量时间,这说明这一层的信息其实比较"浅",一步微调就能恢复得差不多。
这个发现挺有意思的,它说明扩散模型内部不同层级承担的任务复杂度是不一样的,与其平均分配计算资源,不如把预算集中在真正需要精细打磨的那一层。
**训练规模的扩张**
除了这三个核心设计,GeoVerse还做了一件比较朴素但很关键的事:把训练数据从4个数据集扩展到了15个,覆盖真实室内场景、户外驾驶场景、合成场景等各种类型,总共将近8800万张图像的训练池规模。
这背后的逻辑很直接:一个模型如果只在少数几种场景类型上训练过,遇到没见过的场景类型时表现自然会打折扣。论文的实验也验证了这一点,GeoVerse在ScanNetV2这种室内数据集上的表现,PSNR从GLD的15.33涨到了19.65,涨幅相当可观。
**实验结果说了什么**
论文在四个数据集上做了横向对比,包括两个训练时见过的场景类型(DL3DV和RealEstate10K)和两个训练时没怎么见过的场景类型(Mip-NeRF 360和ScanNetV2)。
在DL3DV上,GeoVerse的PSNR是19.61,第二名GLD是17.38。在RealEstate10K上,GeoVerse是21.29,比第二名MVGenMaster的20.54还要高。在推理效率上,GeoVerse基本稳定在9秒左右,而ViewCrafter、GEN3C这些方法都要跑到250秒以上,差距是几十倍。
在长序列一致性测试(也就是连续多轮生成一个大场景)中,GeoVerse在ScanNetV2上跑三轮生成,PSNR达到19.65,而GLD只有15.33,ViewCrafter更低,只有12.82。
这几组数字放在一起看,能感受到GeoVerse不是在某一个维度上取胜,而是同时在图像质量、几何一致性和推理速度这三条战线上都有明显提升。
**这套思路后来被谁接了棒**
GeoVerse这篇论文本身建立在GLD(Jang等人2026年的工作)的基础之上,GLD首次提出了在几何潜在空间里直接做多视角扩散生成,GeoVerse则是在这个骨架上补上了视频先验和空间记忆两块关键的肌肉。
论文相关工作部分还提到了几条并行的探索路径。Gen3R这篇工作把VGGT(一种视觉几何基础模型)的特征改造成几何潜在表示,试图把RGB生成和三维生成对齐起来一起训练。Geometry Forcing则是用几何基础模型的特征去监督视频扩散模型的中间表示,希望让视频模型"顺便"学会一些三维空间常识。这两条路径都还是把生成过程组织成视频序列,而GeoVerse选择的是直接在目标相机位置生成,不需要中间那些密集的视频插帧过程。
另外像Lyra 2.0这样的工作,走的是"逐帧几何匹配加自增强历史训练"的路子,来压制长序列生成里的累积漂移问题,思路和GeoVerse的空间记忆机制有点殊途同归,都是想办法让模型"记住"之前生成过什么。
**写在后面**
读这篇论文的过程中,最让我意外的一点是,它没有选择"造一个更大的模型"这条路,而是想办法把两个已经很成熟的、原本各有短板的技术拼在一起,用一个适配器桥接起来。这种"缝合"思路听起来简单,但真正让它跑通、跑好,需要在特征层级、注入位置、损失函数配比上做非常细致的调试,光是消融实验表格里列出来的每一项,背后可能都是无数次失败的尝试。
论文里有个细节我觉得值得单独拎出来说:他们发现Level-0级联只需要1步就能达到49步的效果,但Level-1如果只用1步,质量就会明显下降。这说明不同层级的特征对"迭代打磨"的需求是不对等的,这跟我们直觉里"越复杂的任务需要越多步骤"的想法其实是有出入的,有些看起来复杂的环节,其实信息已经比较确定了,真正需要反复推敲的只是其中一部分。这提醒我,做优化的时候不能一刀切地分配资源,得先弄清楚哪里才是真正的瓶颈。
论文的局限性部分也很坦诚,提到峰值视觉保真度还是受限于DA3特征空间的表达能力,在纹理稀疏或者结构复杂的区域,深度误差和外观漂移还是会在多轮记忆更新里累积。这说明这条路还没走到头,几何和外观的联合稳定性,仍然是一个悬而未决的问题。
如果未来有人能找到一种方式,让空间记忆本身也具备"自我纠错"的能力,而不只是被动累积,会不会让这套系统在真正意义上做到无限探索一个场景而不跑偏?
Q&A
Q1:GeoVerse是什么?
A:GeoVerse是一个新视角合成框架,它在几何潜在扩散模型的基础上,注入了Wan2.2 VACE视频生成模型的外观先验,并结合一个持续累积的全局空间记忆机制,实现了高质量、跨视角一致且推理速度快的新视角生成。
Q2:GeoVerse相比之前的GLD方法有哪些提升?
A:GeoVerse在DL3DV数据集上PSNR提升了2.23分,在Mip-NeRF360数据集上绝对轨迹误差降低了32.4%,推理速度从169秒压缩到约9秒,长序列多轮生成的一致性也显著提高。
Q3:GeoVerse是怎么做到推理速度这么快的?
A:GeoVerse采用了reflow蒸馏技术,把原本需要几十步的扩散去噪过程压缩成4步完成,同时只对Wan2.2视频模型做一次前向特征提取并复用,避免了生成完整视频带来的计算开销。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
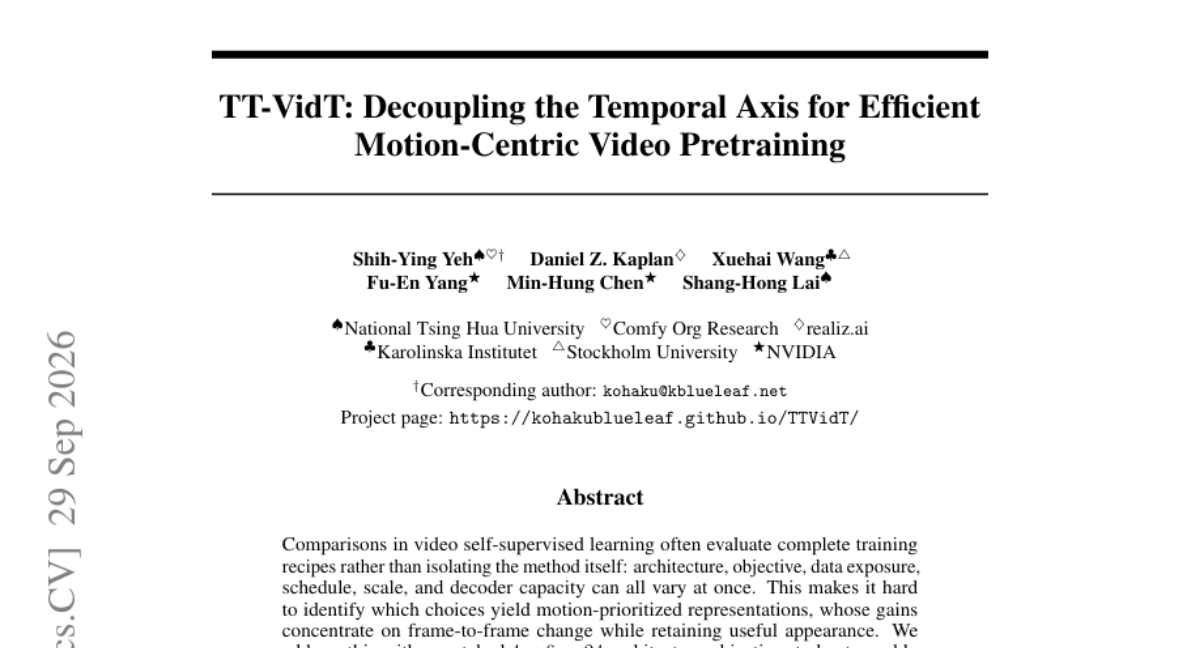
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
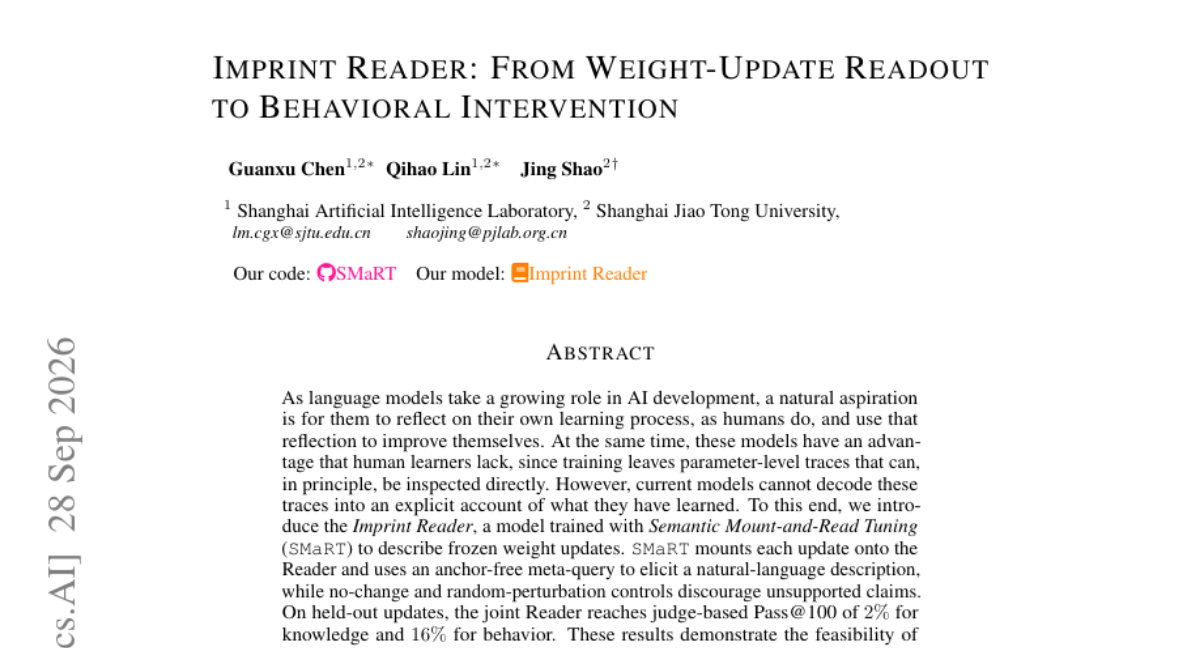
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
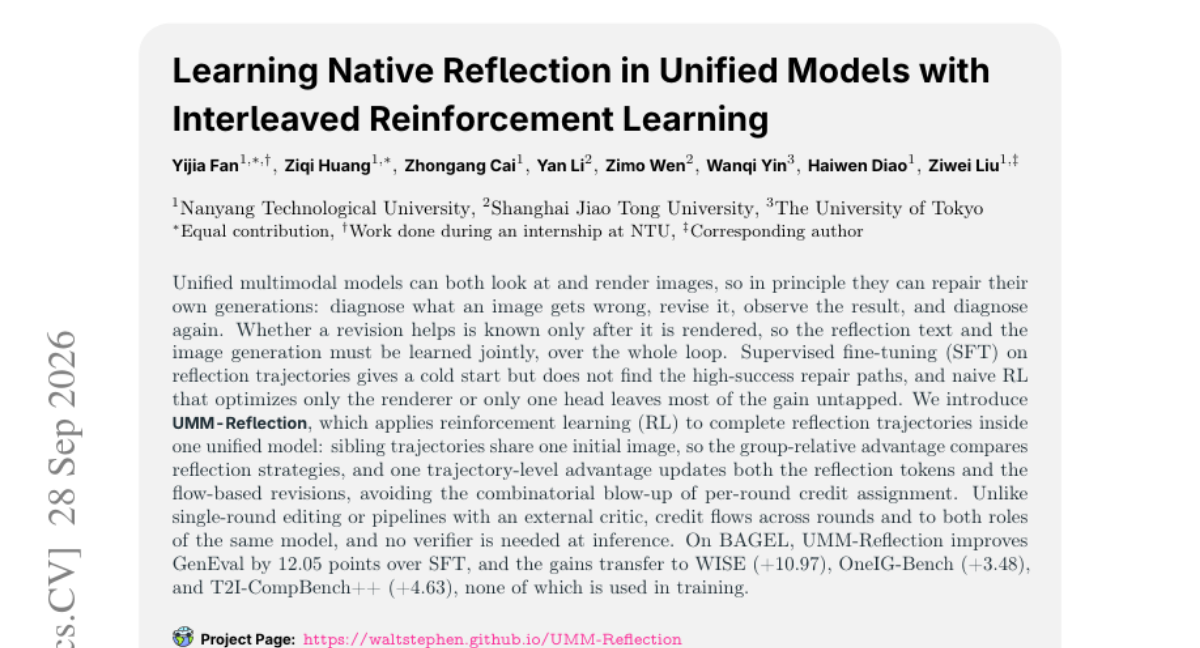
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
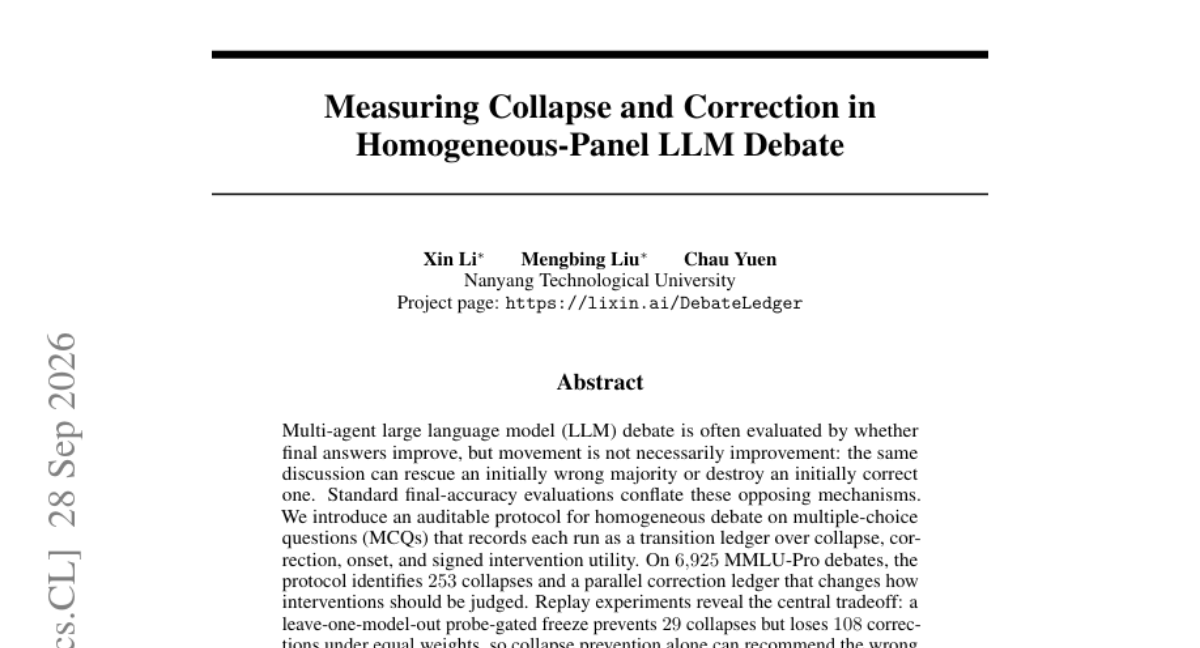
当三个AI辩论时,谁在拯救真相,谁在毁灭真相?
该研究提出可审计的LLM辩论评价协议,在6925场MMLU-Pro辩论中发现253次崩溃案例,揭示探针预筛选信号与初始准确率高度相关,且冻结类干预策略虽防住29次崩溃却损失108次修正,净效用为负,颠覆了"辩论必然提升准确率"的直觉。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
当三个AI辩论时,谁在拯救真相,谁在毁灭真相?





