




 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

AI搭积木,能拼出一台能用的车,却拼不出一台让人惊艳的车
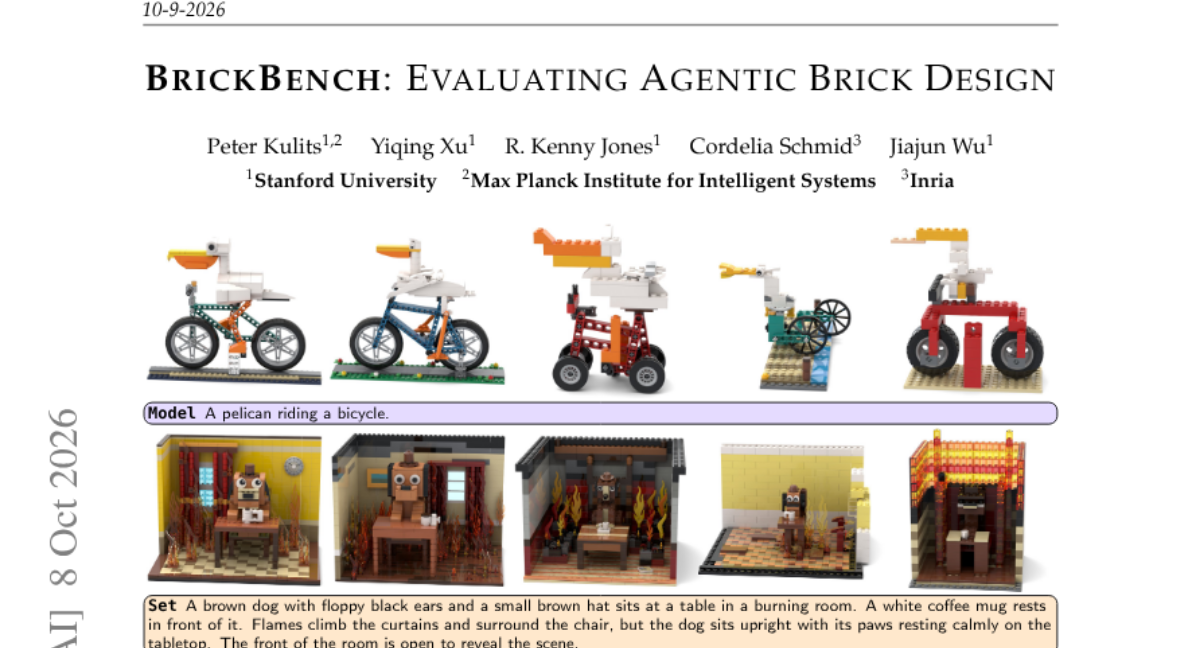


2026年的某一天,你让一个AI写代码,它能帮你修好一个开源项目里困扰了几个月的bug。你让它画个3D场景,它能写出Blender脚本直接渲染出来。你让它设计一个CAD零件,它也能写程序造出来。
这些事听起来都挺厉害,但有一件事可能会让你愣一下:这些AI现在也能搭乐高了。
不是那种简单的几十块积木拼个小房子,而是真正意义上的乐高套装设计,几百上千块零件,要选对颜色、拼对形状、还得保证整个结构立得住、不散架。给它一句话描述,比如"一只骑自行车的鹈鹕",它就要自己去乐高零件库里翻找合适的零件,一块一块搭出来。
这事听起来简单,做起来却藏着一个挺扎心的真相:机器现在能搭出"能用"的乐高,却搭不出"好看"的乐高。
这篇来自斯坦福大学、马克斯普朗克智能系统研究所和Inria的论文,就是想把这件事说清楚。他们管这套评测体系叫BrickBench。
搭积木到底难在哪
你可能觉得搭乐高嘛,不就是拼拼凑凑,有手就行。但如果你真拿起一套几百片的乐高套装试过就知道,这里面讲究可多了。
乐高零件库里有一万四千多种不同的零件类型,形状、尺寸、连接方式各不相同。你得先想清楚整体造型长什么样,再从这么庞大的库里挑出合适的零件,然后给每一块零件安排好位置、角度、颜色,还得保证它们能真正咬合在一起,搭出来的东西放在桌上不会一碰就散架。
这背后牵扯到两层问题。一层是物理上行不行,零件之间有没有打架(专业说法叫碰撞),整个结构在重力作用下站不站得住。另一层是好不好看,这个更难量化,两个作品可能都完全符合文字描述、物理上也都稳固,但一个像模像样,一个却透着一股子"能用就行"的敷衍感。
早先有专门为这个任务训练的AI模型,比如BrickGPT和BrickNet,它们是专门在乐高数据上调教出来的。但这篇论文里有个挺有意思的发现:一个压根没针对乐高训练过的通用编程智能体,表现反而甩开了这些专门模型一大截。
这事儿乍一听有点反直觉。专门训练的模型不是应该更懂行吗?但研究者发现,像GPT-5.6 Luna这样的通用代码智能体,在BrickNet原有的评测集上,对齐度评分只比真人设计的参考答案低0.02分,几乎打平,而且把BrickGPT远远甩在身后。
这就好比你本以为专业厨师做的菜一定比一个会看菜谱、会用工具、还会尝味道调整的聪明学徒强,结果学徒靠着不断试吃调整,反而做出了更接近大厨水准的菜。差别不在天赋,在于学徒能一边做一边检查、一边改。
这个发现直接推动了这篇论文要做一件新事情:既然通用智能体这么能打,那就得设计一套更难的考验,看看它们是不是真的学会了"设计"乐高,还是只是侥幸蒙对了简单题。
BrickBench:三道题,一个比一个难
研究者设计了三种不同的测试场景,每种场景对应一种不同的能力要求。
第一种叫Model模式,零件数量不超过400块,主要考验AI能不能搭出一个相对完整、单一的物体,比如一只鹈鹕、一条鲨鱼。
第二种叫Set模式,要求用400到4000块零件,这个区间不是随便定的,而是参照了乐高官方的BrickLink Designer Program(一个允许普通设计师提交作品、由乐高评估是否能成为正式发售套装的计划)对零件规模的要求。这意味着AI要搭的不再是一个孤零零的小摆件,而是一整套场景,比如论文里提到的那个"一只狗坐在着火房间里的桌子前"的复杂场景,涉及多个物体、多种材质和空间关系。
第三种叫Alt-Build模式,限定只能用某一款具体乐高套装(编号10698)里包含的783个零件、104种零件类型来搭建。这套零件以基础砖块和板件为主,偶尔有几扇窗户、几扇门、几个轮子。这考验的是在"巧妇难为无米之炊"的情况下,AI能不能还是想出办法搭出想要的东西。
这三种设置其实对应着真实世界里三种不同的创作困境。Model模式像是给你一盒随便挑的积木,让你捏出一个形象。Set模式像是让你按照正式出版物的标准,做一套完整的产品。Alt-Build模式则像是你手头只有家里现成的那几种积木,想拼出点新花样,这时候真正考验的是创造力而不是零件库的丰富程度。
三百道题,自带判卷标准
研究者给每种模式准备了100个文字提示,覆盖十个主题类别,比如中世纪城堡、交通工具、火车、太空科幻、建筑、动植物、海盗、历史场景等等。加起来一共300道题。
光有题目还不够,得知道怎么判对错。这里论文用了一个挺巧妙的办法,叫问题图(question graph)。简单说,就是把一句长长的文字描述拆解成一连串能用"是"或"否"回答的小问题。
问题图:把一段复杂描述拆解成一串是非题,并且按逻辑依赖关系组织起来,比如先问"画面里有没有狗",只有这题答"是",才接着问"这只狗的毛是不是棕色的"。
比如"一只棕色的狗,耳朵耷拉着是黑色的,戴着棕色小帽子,坐在着火房间的桌子前",会被拆成"有没有一只能辨认出来的狗"、"狗是不是棕色的"、"狗的耳朵是不是耷拉的"、"狗是不是戴着帽子"等等十几个小问题。再用一个视觉语言模型(VLM,能同时理解图片和文字的AI模型)从多个角度拍下搭好的乐高作品的照片,一个个回答这些是非题,最后算出有多少比例的问题被满足了。
这套做法有点像考试里的采分点设计。与其笼统地打一个模糊的印象分,不如把一道大题拆成许多个小得分点,每个点扎扎实实地核对,这样最后算出来的分数才真实可信,不会被"看起来还行"这种主观印象带偏。
除了判断搭得对不对,研究者还要判断搭得好不好看,这个更难量化的部分用了另一套机制,叫ELO对战评分(借用了国际象棋等级分的名字,简单说就是让不同系统的作品两两PK,赢得多的分数就高)。
具体做法是,针对同一道题,把不同AI系统搭出来的作品两两配对,让一个视觉语言模型当裁判,从两个角度问它问题。第一个问题带着原始文字描述,问哪个作品更符合描述,这叫对齐度ELO。第二个问题故意不告诉裁判原始描述是什么,只问哪个作品的"设计感"更好,按照官方乐高套装的标准来评判,看重零件的巧妙运用而不是搭的是什么主题,这叫设计ELO。
这里有个细节值得多说一句。为什么要故意隐藏文字描述来问设计感?
因为如果裁判知道题目要求搭"一个骑自行车的鹈鹕",它可能会不自觉地因为"哦这确实是个鹈鹕骑自行车"而给高分,哪怕这个作品的零件搭配其实很粗糙。把描述藏起来,裁判就只能盯着搭建本身的工艺水准来打分,这样才能把"符合要求"和"做得精致"这两件事彻底分开评判。
这就像请两个不同的评委来打分,一个评委拿着原始订单核对你做的菜是不是西红柿炒鸡蛋、有没有放盐,另一个评委压根不知道你点的是什么菜,只凭刀工火候摆盘来打分。两个分数合起来才能说明,你到底是精准完成了任务,还是顺便还做出了一道有水准的菜。
为了让这套AI裁判评分真的靠谱,研究者还专门招募了102名Prolific平台上的志愿者,让真人来对同样的作品两两打分,收集了4080条判断,和AI裁判的ELO排名做对比。结果发现在36组对比里有34组排名是一致的(用统计学里的肯德尔相关系数衡量,达到0.89,这个数字越接近1说明两套排名越吻合)。这说明让AI当裁判这件事基本靠谱,不是自说自话。
BrickAgent:给AI一套靠谱的搭建工具
光有考题和判卷标准还不够,还得给AI一个能实际动手搭建的环境,这就是论文里另一个重要贡献,叫BrickAgent。
这个环境里包含了完整的乐高零件数据库(叫LDraw,一套社区维护的数字乐高建模标准),还有一套叫BrickNet的连接系统,给每个零件标注了连接点的类型,比如凸起(stud)要对应凹槽或管道,卡榫(bar)要对应夹子(clip),铰链、球形接口、固定接口等等各有讲究。
LDraw:乐高社区维护的一套数字化零件标准,每个零件都有对应的真实世界原型,作品存成文本文件,记录每个零件的类型、颜色和空间位置姿态。
更关键的是,这个环境给AI提供了一整套实用工具:搜索零件库、按连接点摆放零件、镜像和测量零件、把小组件打包成子装配体再组合、从任意角度渲染效果图,还有一个会说人话的校验器,能告诉AI"你这里有两块零件撞在一起了"或者"这部分结构不稳会塌"。
这套工具链到底有多重要?论文专门做了个对照实验来说明。
他们把同一个AI智能体(GPT-6 Astra和GPT-5.6 Luna)扔进一个阉割版环境里,这个环境只给它乐高零件库和文件格式说明书,但拿掉了BrickAgent的全部辅助工具。结果有效作品的比例,GPT-6 Astra从100%暴跌到40%,GPT-5.6 Luna更惨,300次尝试里只成功了1次,跌到不到1%。
没有工具辅助时,GPT-6 Astra搭出来的作品平均有7处零件互相穿插打架,GPT-5.6 Luna更是平均156处碰撞,整个结构还散成了80多个互不相连的碎片。
这个数字差距说明了什么?
想象一下你蒙着眼睛拼乐高,光凭脑子里的想象去摆放零件,不许看、不许摸、不许用尺子量,最后搭出来的东西大概率是七零八落、互相卡住甚至穿模的一堆垃圾。而如果给你一副眼镜,让你能随时看清楚、量清楚、还有人在旁边提醒你"这里撞上了",你哪怕水平一般,也能搭出一个勉强立得住的东西。
对AI来说也是一样的道理。它脑子里或许知道"这个零件应该放在这个位置",但没有实时渲染反馈、没有物理碰撞检测,它就是在凭空想象一个三维结构该长什么样,出错的概率自然暴增。这个发现也呼应了论文标题里"Agentic"这个词的分量,agentic不只是说AI会自己写代码,更重要的是它能执行代码、看到结果、再回头修正,这是一整套循环,而不是一次性地把答案吐出来。
有意思的是,拿掉工具之后,Luna的对齐度和设计感分数居然还涨了一点,VQA涨了0.02,ELO涨了62分。研究者解释说,这是因为没有了"必须能实际搭建"这个紧箍咒,AI可以天马行空地摆放零件,视觉效果看起来更好,但搭出来的东西完全立不住、也拼不出来。这其实说明了一个很深的道理:可构建性这个约束条件本身是有代价的,它会限制AI的表达自由度,但正是这种限制让作品从"一张好看的效果图"变成"一个真实可以被制造出来的物体"。
十一个AI选手,谁搭得最好
论文测试了十一个当下主流的编程智能体,包括GPT-6 Astra、GPT-6.1 Sol、GPT-5.6 Sol、GPT-5.6 Luna、Claude Opus 5.5、Claude Opus 5、Gemini 3.8 Flash、Qwen 3.8 Flash、DeepSeek V4.1 Flash、GLM 5.3 Flash和Muse Spark 1.3,再加上两个专门训练的基线模型BrickNet-14B和BrickGPT做对比。
结果显示,当这些智能体用上完整的BrickAgent环境之后,造出有效作品这件事基本被攻克了。有五个智能体做到了100%的有效率,整体最低的也有80%。137次失败里,有44次是压根没在规定轮次内交出作品,剩下的要么是结构不稳(41次)、要么零件打架(31次)、要么用的零件数量不符合规定(21次)。
在符合文字描述这件事上,表现最好的GPT-6 Astra能满足95.4%的问题点,表现最差的GLM 5.3 Flash只有59%。但真正能把这些AI拉开差距的,是设计感评分,也就是Design ELO。最高分1299分和最低分753分之间差了546分,这个差距换算成胜率大概意味着,裁判在近96%的对局里会选择Astra的作品而不是GLM的作品。
有个细节挺有意思。两个后来才发布、没赶上人类评测环节的模型,Claude Opus 5.5和GPT-6.1 Sol,表现同样亮眼。GPT-6.1 Sol的综合ELO是1293分,和Astra的1297分几乎打平,但花费只要Astra的五分之一(0.87美元对4.06美元)。Claude Opus 5.5的设计ELO评分落在Astra的置信区间内,但花费只有Opus 5的40%。这说明贵不一定就搭得好,便宜也不一定搭得差,价格和表现之间压根没什么稳定的对应关系。
论文里还专门列了张表,把每家模型的零件使用习惯摆了出来。Astra在Model模式下平均用217个零件、35种零件类型、9种颜色,搭得又多又丰富。GLM则只用27个零件、10种类型、5种颜色,相当朴素。在Set模式下,Qwen、DeepSeek、Muse和GLM的作品平均分散成23到40个互不相连的部件,而Astra、两个Sol模型和Opus模型的作品只分散成2到4个部件,这说明后者更擅长把场景拼成一个完整连贯的整体,而不是几堆各自为政的零件。
研究者还发现,不同类型的问题被回答对的概率差异很大。所有模型回答颜色相关问题的正确率都在91%以上,颜色这东西确实好判断。但涉及材质和纹理的问题,正确率只有49%到83%,物体类型和状态紧随其后,也是比较容易出错的区域。这或许说明,AI对"是什么颜色"这种直观属性的把握已经很稳,但对"这个表面摸起来是什么质感"这种更抽象的概念理解还不够透。
真人设计 VS AI设计,十局九胜
说到这儿,可能有人会问,既然文字符合度都做到95%了,是不是就说明这些AI已经是合格的乐高设计师了?
论文的答案很干脆:还差得远。
研究者找了一批熟悉乐高设计的人,让他们看两件作品,一件是AI搭的,一件是从BrickNet数据集里随机挑出的、零件数量相近的真人设计作品,让评测者猜哪个是人做的。
这个测试没有按题目配对,因为BrickBench的题目本身没有对应的真人设计原型,只能按零件数量做匹配。五名评测者一共打了360次分,其中323次准确认出了真人作品,换算下来,没有一个AI的作品被误认成人类设计的概率超过五分之一。表现最好的GPT-6 Astra,在21次配对里也只被误认了4次。
这件事本身就很说明问题。所有AI的作品被识破的比例都显著高于随机猜测(也就是五五开),也就是说评测者不是瞎蒙蒙对的,他们是真的能看出端倪来。
论文把这种差距归结为三个方面:零件的巧妙运用、比例、和表面细节。这让我想起一个挺贴切的类比。你去菜市场买了同样的食材,让一个刚学会炒菜的人和一个干了二十年的大厨做同一道菜。两道菜可能看着都差不多,蛋也熟了、味道也不算难吃,严格按菜谱走流程确实都对,但大厨那道菜里总有些说不清道不明的细节,可能是火候拿捏得恰到好处,可能是摆盘时的一点巧思,让你一眼就能分辨出谁更懂行。AI现在搭的乐高,大概就处在"蛋熟了、味道也对、但总感觉差了点什么"的阶段。
这个发现对应着论文标题里那句点睛之笔:Agents are learning to build what works, but not yet what makes a great design,AI正在学会搭出能用的东西,但还没学会搭出真正出色的设计。
物理仿真的边界在哪里
论文也很坦诚地指出了自己这套物理校验方法的局限。
目前的稳定性检测,是把每个连通的零件组当成一个刚体,丢进物理引擎PyBullet里模拟重力作用,看它会不会倒塌或者移位超过一定阈值(3个LDraw单位,大约是一个凸起高度的四分之三)。
但这套检测没法模拟凸起连接的实际持握力,也没法模拟轴类零件之间的那种"晃一晃能滑动"的松动感。换句话说,一个在仿真里"站得稳"的作品,现实里拿去真的拼出来,说不定一碰就塌,或者某个连接处因为受力不均慢慢下垂变形。
要真正解决这个问题,得靠更精细的结构仿真,比如给每个连接点设定一个力的承受上限,或者干脆上有限元分析(一种工程上常用来模拟材料受力变形的数值方法)。论文提到已经有零星的学术尝试在做这个方向,比如用最大流网络去分析乐高结构的受力情况,或者专门针对简单乐高套装做有限元建模,但目前都还没有一个通用的、能套用在任意复杂度作品上的方案。
这就好比你现在有一把尺子能测出一栋房子有没有明显倾斜,但没法预测这栋房子十年后会不会因为材料老化而某个角落慢慢开裂。能测出明显的问题是第一步,但离"完全靠谱"还有距离。
这也是为什么论文很克制地说,这套物理校验是必要条件,但还不是充分条件。
写在后面
读完这篇论文,我一直在想一个问题:为什么符合描述这件事这么容易被攻克,而审美这件事却这么难?
论文里有个数字组合特别值得玩味。VQA对齐度分数最高和最低之间只差了36个百分点(95%对59%),而设计ELO的最高和最低之间却差了546分,换算成胜率接近96%。这种差距悬殊的对比说明,"听懂你说什么"和"做出让人眼前一亮的东西"根本不是同一种能力,前者可以通过堆砌更多零件、覆盖更多细节点来暴力解决,后者却涉及取舍、比例、巧思这些很难量化成损失函数的东西。
还有一个细节让我挺触动的,就是那个"隐藏文字提示去问设计感"的裁判机制设计。这个做法背后藏着一个很朴素但容易被忽略的洞察:符合要求和做得好看,其实是两条完全独立的评价维度,必须用两种不同的提问方式才能把它们彻底剥离开,不然很容易被"它确实搭出了要求的东西"这种光环效应带偏了对工艺水准的判断。这个思路放在其他评价场景里似乎也挺通用,比如评价一篇AI写的文章,你应该分别问"它有没有写到我要求的点"和"抛开主题不谈,这篇文章本身写得好不好",两件事不能混为一谈。
另外论文里那个环境消融实验的数字也值得再琢磨一下。同一个模型,有没有辅助工具,有效率能差出60个百分点甚至更多。这说明了一件很现实的事,我们现在评价一个AI模型"聪明不聪明",很大程度上其实是在评价这个模型加上它所在的工具环境这个组合聪明不聪明。脱离了环境单独谈模型能力,可能本身就是个有问题的提法。
这篇论文留了一个很明确的开放问题,就是怎么量化"设计感"这种东西,怎么让AI不仅仅学会"把要求的东西都塞进去",而是学会取舍,学会用更少更巧妙的零件实现更惊艳的效果。这事儿听起来简单,但往深了想,这可能触及到创造力到底是什么这个更根本的问题。
如果有一天AI真的能搭出让专业设计师也分辨不出真假的乐高作品,那时候我们该用什么标准去评价"这是不是真正的创造"?
Q&A
Q1:BrickBench是什么?
A:BrickBench是斯坦福大学等机构提出的一个评测基准,用来测试AI编程智能体能不能根据文字描述设计出可以真实搭建的乐高作品,包含300个提示和三种不同难度的零件限制场景。
Q2:AI搭的乐高作品和真人设计的作品有什么区别?
A:论文做了真人盲测,结果323次评测里有323次被真人评测者认出哪个是人做的,AI作品整体符合文字描述,但在零件巧妙运用、比例和表面细节上明显不如真人设计。
Q3:BrickAgent工具环境对AI搭乐高有多重要?
A:非常重要,实验显示拿掉搜索零件、碰撞检测、稳定性校验等辅助工具后,GPT-6 Astra的有效作品比例从100%跌到40%,GPT-5.6 Luna更是跌到不到1%。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章


为什么越难的题,AI 越学不会?RGPO 用一个"临时脚手架"解决了这个死结
RGPO用"临时脚手架"破解大模型强化学习的奖励稀疏难题:先让模型独立解题,失败则分段放出标准解法引导重写,仅采纳经验证更优的答案。难题测试准确率从0跃至99.5%,语言模型平均分高出最强基线5.0分。

让大模型学会"对齐":用专家路由给多语言能力松绑
论文提出用MoE模型的路由器输出作为跨语言对齐目标,通过持续预训练对翻译句对施加路由KL散度损失,在不改变分词和架构的前提下让隐藏表示更接近,并在四个开源MoE模型、七种语言上验证了下游任务性能的一致提升。

DiffGate:当老师和考官意见不一致时,AI学生该听谁的?
DiffGate提出难度门控的教师指导机制,让验证器决定何时需要教师介入,仅对失败且困难的轨迹提供有界教师指导,结合GRPO强化学习,在数学与代码任务上显著提升解题覆盖率与跨领域迁移能力。

语言模型真的需要一张可训练的词嵌入表吗?
研究者用固定不变的16位二进制编码替代传统可训练词嵌入表,在17亿参数规模模型上训练1000亿token,证明模型仍可获得实质语言能力,揭示输入表并非必需,但性能略逊于可学习方案。
为什么越难的题,AI 越学不会?RGPO 用一个"临时脚手架"解决了这个死结
让大模型学会"对齐":用专家路由给多语言能力松绑
DiffGate:当老师和考官意见不一致时,AI学生该听谁的?
语言模型真的需要一张可训练的词嵌入表吗?





