




 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

CoTranslator:如何用一个"翻译官"让AI老师的偷懒解题思路变得诚实可用


你有没有想过这样一个场景:老师让你解一道数学题,正常情况下你得从头推导,可能试错好几次才能找到正确思路。但如果老师先偷偷告诉你答案是多少,你再回头"解释"这道题怎么做的,整个过程会快很多,但你写出来的解题步骤,很可能不是真正的推理,而是在给已知答案找理由。
这正是当下训练AI小模型时遇到的一个尴尬处境。
大模型公司想让一个小模型学会复杂推理,比如解数学题,通常的做法是找一个强大的"老师模型"生成详细的解题过程,然后用这些过程去训练"学生模型"。听起来很简单,但魔鬼藏在细节里。
**老师模型要么老老实实从头做题,要么走捷径先看答案再编故事,这两条路都有各自的代价,而且代价还不小。**
这篇来自清华大学、蚂蚁集团和小米公司的论文,研究的正是这个两难问题,他们给出的解法叫CoTranslator,一个专门负责把"走捷径的解题过程"翻译成"老老实实解题过程"的翻译模型。
两条路都不好走:正向生成和逆向生成的困境
先说说正向生成这条路。
正向思维链生成*:只给AI老师题目本身,不告诉它答案,让它从零开始一步步推导解题过程。这被称为Forward Chain-of-Thought Generation,简称FCG。
这种方式听起来最靠谱,毕竟学生做题时也看不到答案,训练数据的生成方式应该和学生实际使用的场景保持一致。但问题是,很多题目很难,老师模型自己也不一定能一次做对。
于是又衍生出一个补充手段,叫拒绝采样。
拒绝采样*:让AI老师针对同一道题反复生成多次解答,只保留那些最终答案和标准答案一致的版本,其余的全部丢弃。这种方法简称RS。
这就像你去参加一场笔试,允许你交无数次答卷,只有算对的那份才会被收进档案。听起来很美好,但代价是什么?代价是时间和算力。
论文里给出了具体数字:对于一些高难度的奥数题目,想通过拒绝采样找到一个答案正确的版本,有时候需要尝试超过16次。如果每道题目都要反复调用一次昂贵的大模型API,16次几乎是在烧钱。而且就算给了16次尝试的预算,有些特别难的题目可能还是一次都对不了,这道题的训练数据就直接作废了。
**正向生成的问题可以归结为一句话:诚实,但是贵,而且有些题根本做不出来。**
那换一条路呢?这就引出了逆向思维链生成。
逆向思维链生成*:把题目和正确答案一起喂给AI老师,让它基于已知答案去"反推"出一套看似合理的解题过程。简称RCG。
这个思路的逻辑很简单:既然知道答案了,那就没必要反复试错了,直接朝着那个答案去编排推理步骤,效率自然高很多,几乎不需要额外的采样成本。
**但这里有个致命的隐患,论文把它叫做"事后合理化"。**
事后合理化*:指模型并非真正从题目条件出发一步步推导出答案,而是拿到已知答案后,在解题过程里悄悄利用这个答案来走捷径,比如直接把答案代入某个假设中去验证,而不是真正地独立推导出来。
打个比方。假设你是一名侦探,接到任务要写一份案件推理报告。如果你是真的调查,你得从现场线索、嫌疑人口供、时间线一步步捋出凶手是谁。但如果有人提前告诉你"凶手就是张三",你写报告时很可能会不自觉地只收集支持张三有罪的证据,忽略那些指向别人的线索,整篇报告读起来逻辑通顺,但它根本不是真正的侦破过程,而是一篇精心包装的辩护词。如果警察局真的按这份报告去培训新人怎么破案,新人学到的不是推理能力,而是"怎么把已知结论包装得像是推出来的"。
这就是RCG最大的风险所在。学生模型在实际使用时,是看不到答案的,它必须完全靠自己从题目出发去推导。可如果训练数据本身就是"知道答案后编出来的",那学生学到的很可能是一套在没有答案提示时根本用不上的虚假推理套路。
之前也有研究者尝试缓解这个问题,比如一种叫语义抑制的方法,简称SUP,就是在提示词里告诉AI老师"别在最后才说答案,但过程里不要提前透露"。还有一种叫SSR的结构化骨架引导方法,先让AI生成一个不包含答案信息的推理骨架,再按骨架展开完整解答。但论文作者发现,这些方法治标不治本,因为它们本质上还是把答案喂给了模型,只是加了一道"口头约束",约束是否真的被遵守,全凭运气。
CoTranslator的核心思路:把这个问题当成一次"翻译"
研究者们的灵感来自一个看似不相关的领域,机器学习里的翻译一致性理论。
这里就要引出整篇论文最核心的比喻了。研究者们把"逆向生成的解题过程"和"正向拒绝采样得到的解题过程"看作是两种不同的语言,一个是带着答案提示写出来的"方言",一个是完全靠自己推理写出来的"标准语"。
**既然是两种语言,那就可以训练一个翻译模型,专门负责把方言翻译成标准语。**
这个翻译模型就是CoTranslator。
具体怎么做?研究团队先拿出一小部分题目,大概是整个数据集的八分之一,对这些题目同时生成两种版本的解题过程:一种是用语义抑制方法做出来的逆向生成结果(带着答案偷懒的那种),另一种是经过严格拒绝采样验证过的正向生成结果(老老实实推出来的那种)。
把这两种结果按题目一一配对,就得到了一批"翻译训练语料":输入是偷懒版本,输出是老实版本。
然后用这批配对数据去微调一个语言模型,让它学会看到偷懒版本的解题过程后,能输出一个更接近老实推理风格的版本。
这里有个设计细节特别值得注意:训练翻译模型的时候,输入只给偷懒版本的解题文本本身,不把题目和正确答案也喂给它。
为什么要这样设计?
**因为如果翻译模型同时看到了题目和答案,它完全可以绕过"翻译"这个过程,自己直接根据答案重新编一套解释,这样训练出来的翻译模型其实还是在做事后合理化,只是换了个马甲。**
只给它偷懒版本的文本,逼着它必须老老实实地从这段文字里提炼出真正的推理逻辑,再重新组织成更可信的表达方式。
这就好比培训一个剪辑师,专门负责把粗糙的素材剪成一部完整的电影。如果你把剧本和演员通告单都给剪辑师看了,他可能会直接按剧本脑补画面,而不是真的去看素材里演员到底演了什么。只给他素材本身,他才会被迫认真研究素材里到底发生了什么,再剪出一部真正忠于素材的片子。如果不这样限制输入,翻译模型学到的可能根本不是"怎么把偷懒的推理过程变扎实",而是"怎么根据答案自己编一套新说辞",那和原来的问题就没有本质区别了。
经过这样的配对训练之后,翻译模型就可以大规模上岗了。对于海量的题目,流程变成了:先用语义抑制方法让老师模型快速生成一版(成本很低,因为不用反复采样),再用训练好的翻译模型把这一版"翻译"成接近拒绝采样质量的版本。全程只需要调用一次老师模型和一次翻译模型,就能得到一份质量相对可靠的训练数据。
整个方案的架构其实非常朴素:用小成本的数据训练一个翻译器,再用这个翻译器去批量处理大成本才能产出的高质量结果,相当于用一次性投入换来了持续的效率提升。
效果到底怎么样:数字说话
理论听着挺美,实际测试结果如何?
研究团队在六个不同的学生模型上做了测试,涵盖了Qwen3系列的4B和8B参数规模,还有专门针对数学优化的Qwen2.5-Math系列。测试用的是六个数学竞赛基准,包括AIME、HMMT、Omni-MATH和IMO-AnswerBench等,这些都是相当硬核的奥数级别题目。
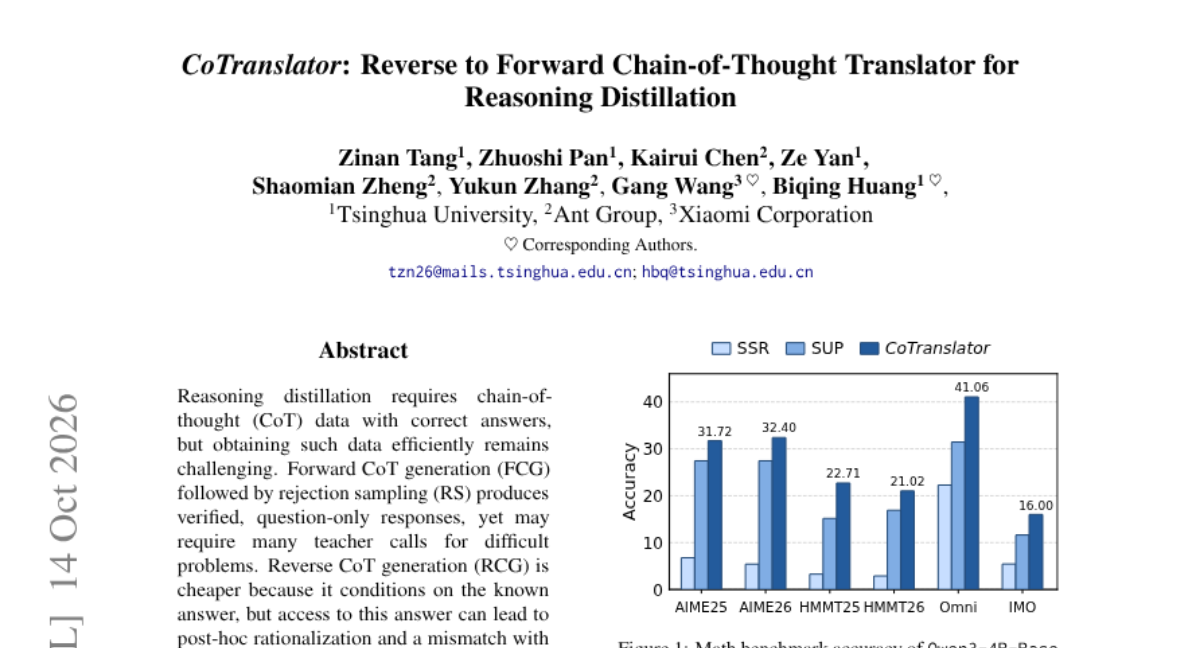
先看一组关键对比。以Qwen3-4B-Base这个学生模型为例,用语义抑制方法SUP训练出来的模型,六个基准测试的平均准确率是21.67%;而用CoTranslator翻译后的数据训练出来的模型,平均准确率达到了27.49%,提升了5.82个百分点。
这个数字是什么概念?意味着每解20道题,用了CoTranslator的模型就能比单纯用语义抑制方法的模型多做对1道题左右。对于竞赛级别的数学题,这个提升幅度相当可观。
更让人意外的是,这个4B规模的CoTranslator训练出来的学生模型,平均准确率27.49%,甚至超过了理论上限参照组,也就是完全用昂贵拒绝采样方法训练出来的同等规模模型(27.21%)。
这听起来有点反直觉。一个成本低得多的方法,竟然追上甚至超过了成本最高的"黄金标准"方法。研究者在论文里也坦言这个结果超出了预期,推测可能是因为经过翻译后的数据在某些维度上比原始拒绝采样数据更加"干净"和风格统一,反而对小模型的学习更友好。
再看看算力成本这笔账。研究团队做了详细的计算量估算,拒绝采样方法需要老师模型针对每道题反复尝试多次,总体计算开销折算成浮点运算次数是13.888乘以10的20次方。而CoTranslator这条路线,包括数据配对构建、翻译模型训练、老师模型推理和翻译模型推理在内的全部开销,加起来只有4.990乘以10的20次方,差不多是拒绝采样的35.9%。
也就是说,花了不到三分之一的算力,拿到了超过九成五的性能。对于两个4B规模的学生模型,CoTranslator保留了拒绝采样方法95.0%的平均准确率,却只花费了35.9%的估算算力。
这笔账算下来,很像是你本来要雇一个全职顾问团队反复开会讨论才能定出一份方案,现在换成了先让一个助理快速起草初稿,再花很少的钱请一个资深编辑润色修改,最后效果居然和全职顾问团队差不多,省下来的预算可以拿去办更多的事。
翻译模型会不会"水土不服":跨数据集和跨老师模型的迁移测试
一个自然的疑问是:这个翻译模型是不是只能在训练它的那批数据和那个老师模型上管用?换一批新题目,或者换一个完全不同的老师模型,它还灵不灵?
研究团队专门做了这个测试,而且测试的时候翻译模型完全没有重新训练,直接拿着老的翻译模型去处理新场景。
第一个测试是换数据集。原来翻译模型是在nvidia的Nemotron-SFT-Math-v4数据集的一个子集上训练的,现在换成另一个完全不同来源的数据集ODA-Math-460k,包含46万道题目,老师模型依然是DeepSeek-V4-Pro。结果显示,在4B学生模型上,CoTranslator比语义抑制方法的平均准确率提升了4.76个百分点;8B学生模型上提升了1.66个百分点。证明这个翻译能力不是死记硬背某个数据集的套路,而是学到了某种更普适的"去偷懒化"规律。
第二个测试更极端,直接换掉了老师模型。保持数据集不变,把老师模型从DeepSeek-V4-Pro换成了另一家公司的Kimi-K3模型。结果这次的提升幅度大得惊人:4B学生模型上提升了18.73个百分点,8B学生模型上提升了19.02个百分点。
为什么换个老师模型提升反而更夸张了?论文里给出了解释,Kimi-K3这个模型有一个特别明显的毛病,它在语义抑制的约束下依然很容易早早地把答案泄露在推理过程的前半部分,论文测量显示,Kimi-K3用语义抑制方法生成的内容里,有65.3%的比例提到了"抑制指令"本身,远高于DeepSeek-V4-Pro的9.3%,而且它更早地在文本中暴露答案位置。
这说明Kimi-K3这个老师模型本身更容易"作弊走捷径",提供的原始素材质量更差。但正因为底子差,CoTranslator这个翻译器发挥的修复作用就更明显,相当于一个编辑修改一篇逻辑混乱、暴露剧透的初稿,能改出来的提升空间自然更大。
第三个测试是换应用领域,从数学题换成了更广泛的STEM理工科题目,涵盖物理、化学、生物等学科的研究生级别开放性问题。测试结果显示,4B学生模型平均准确率提升4.88个百分点,8B学生模型提升4.31个百分点。这说明翻译模型学到的"去偷懒化"能力并不局限于数学这一个学科,具有一定的跨领域泛化性。
这种"学会一招就能到处用"的特性,有点像你教会一个人怎么识别新闻报道里的逻辑漏洞,这个能力一旦掌握,不管是看体育新闻还是财经新闻,都能用上,因为训练的其实不是针对某个特定领域的知识,而是一种识破"先有结论再找理由"这种叙事模式的通用直觉。
它是怎么识破偷懒套路的:具体机制分析
光看最终准确率可能还不够直观,研究团队还做了几项更细致的分析,试图搞清楚CoTranslator到底在解题过程文本里改变了什么。
第一项分析关注的是翻译后的文本到底在多大程度上"长得像"真正拒绝采样得到的老实版本。研究者用了语义层面和词汇层面两种特征,还用了几种统计学上的相似度衡量指标,包括MAUVE分布相似度、最大均值差异MMD、以及余弦相似度,来比较不同难度题目下各种方法生成的文本和真正拒绝采样文本之间的接近程度。
难度是怎么衡量的?用的是拒绝采样时需要尝试的次数,尝试次数越多说明题目越难。结果非常一致:无论题目难度如何,CoTranslator翻译后的文本在各项相似度指标上都是表现最好的,和真正的拒绝采样文本最接近,而且这个优势在难题上依然保持。这说明翻译模型不是只在简单题目上管用,碰到难题也没有掉链子。
第二项分析更直接,专门针对"事后合理化"这个问题本身做了量化诊断。研究团队设计了一套标注规则,结合了GPT模型的自动标注和人工制定的启发式规则,去检测解题过程里有没有出现几类典型的偷懒行为:提到了外部给定的预期答案、利用这个答案走捷径绕过必要推理、以及完全独立推导不依赖答案这几类标签。
结果显示,原始语义抑制方法生成的文本里,高达97.1%都在某种程度上提到了预期答案,而CoTranslator翻译后的文本里这个比例降到了2.0%,几乎接近真正拒绝采样文本的2.3%这个基准水平。同样,答案依赖型捷径的比例,语义抑制方法是32.3%,翻译后降到了0.54%,和拒绝采样的1.2%非常接近。
这组数字特别能说明问题。**翻译模型并不是简单地换了种说法,而是真的在清除解题过程里那些"抄近道"的痕迹,把文本推向一种更接近真实推理的状态。**
研究团队还测量了"答案第一次出现的位置"这个指标,衡量答案是在解题过程的哪个百分比位置首次露面。经过翻译处理后,答案出现的位置明显推迟了,说明推理过程变得更加完整,不再是开头就把结论摆出来再东拼西凑理由。
翻译模型本身大小重不重要:参数规模的取舍
论文还做了一项很实用的消融实验,探讨翻译模型本身用多大规模才合适,以及配对训练数据需要多少才够用。
研究者尝试了三种不同规模的翻译模型,分别是1.7B、4B和8B参数,同时也尝试了三种不同数量级的配对训练数据,从3.57万条到14.28万条不等。
结果出人意料:1.7B这个最小规模的翻译模型表现相当差,平均准确率只有个位数到十几的水平,远不如SUP基线。但4B和8B规模的翻译模型表现都相当不错,而且有个细节很关键,训练数据量从3.57万条增加到14.28万条,性能提升幅度非常有限,几乎可以说是边际收益递减。
**这说明翻译模型的能力门槛更多取决于模型本身的参数规模,而不是喂给它多少配对数据。**
这有点像培养一个翻译人才,如果这个人的语言天赋和理解力本身不够,就算让他看再多的范文也翻译不出像样的东西;但只要基础能力过关,哪怕只给他看几十篇优秀范文,他也能很快摸到门道,再给他更多范文反而提升不大。
另外一个有意思的发现是,用来训练翻译模型的基座选了Qwen3-4B-Thinking-2507这个版本,它的表现反而比8B规模的翻译模型更好。研究者给出的猜测是,这个4B模型专门针对"思考模式"做了优化,只支持深度推理这一种工作方式,而8B模型是个混合模型,既支持深度推理也支持快速回答模式,这种"分心"可能反而让它在学习如何生成规范的思维链轨迹时不如专注的4B模型来得纯粹。
研究团队还做了一个对照实验,验证"配对训练"这个环节到底有没有必要。他们让同样的4B翻译模型,不经过配对数据训练,直接尝试去"优化"语义抑制生成的文本。结果这种做法效果极差,平均准确率只有7.39%,比什么都不做还要糟糕很多。
**这个对照实验的意义很重大,它证明了光靠一个聪明的大模型自己去判断"这段文字有没有偷懒"是不够的,必须有真实的配对样本作为学习目标,模型才能真正掌握"怎样的推理过程才算老实"这件事。**
写在后面
读完这篇论文,最触动我的其实不是准确率提升了多少个百分点,而是这个"翻译"的比喻本身,它把一个看起来很棘手的工程问题,重新框定成了一个有成熟理论支撑的经典问题。
机器翻译领域研究了几十年怎么让一种语言的表达忠实地转换成另一种语言,这里面积累的一致性理论和恢复保证,被原封不动地搬了过来,用来解决"偷懒推理"和"老实推理"之间的转换问题。这种跨领域的概念迁移,比单纯调参数、换架构要有意思得多。
还有一个细节值得单独说一说:论文里提到用Kimi-K3做老师模型时,CoTranslator带来的提升幅度反而比用DeepSeek-V4-Pro更大,原因是Kimi-K3更容易在推理过程里过早暴露答案。这其实揭示了一个朴素但容易被忽略的道理,一个修复工具的价值,往往和它要修复的问题严重程度成正比。越是"病情重"的素材,好的编辑能发挥的作用就越明显。这对以后评估类似的后处理工具提供了一个思路:不要只看它在干净数据上表现多好,更要看它在脏数据上能救回来多少。
论文里也坦诚提到了局限性,目前所有实验都限制在8B参数以内的模型和监督微调这种训练方式,没有涉及强化学习或者在线策略蒸馏这些更复杂的训练范式。这个翻译器的思路能不能用在更大规模的模型上,或者能不能和强化学习结合起来产生新的玩法,论文没有给出答案,这也是留给后续研究的一个开放空间。
如果一个AI老师因为知道了答案就开始走捷径编故事,那我们能不能训练一个更小的AI去识破它的套路,再帮它把故事改写成真正的推理?这篇论文给出的答案是肯定的,而且做得相当巧妙。下一个问题是,这种"翻译纠偏"的思路,还能用在多少其他场景里,比如人类专家写的事后分析报告,是不是也存在同样的毛病,也需要类似的翻译器来还原真实的思考过程?
Q&A
Q1:CoTranslator是什么?
A:CoTranslator是清华大学等机构提出的一种翻译模型,专门用来把AI老师模型基于已知答案偷懒生成的解题过程,翻译成更接近老老实实推理得到的解题过程,用于训练小模型学习数学推理。
Q2:CoTranslator比传统拒绝采样方法效率高多少?
A:在主实验中,CoTranslator只需拒绝采样方法35.9%的估算算力,就能保留95.0%的平均准确率,同时整体节省了64.1%的计算成本。
Q3:CoTranslator训练好之后能不能用在新的数据集或新的老师模型上?
A:可以。论文测试了不重新训练的情况下迁移到新数学数据集、新老师模型Kimi-K3以及STEM理工科领域,均取得了明显的准确率提升,证明该方法具有较好的泛化能力。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章


历史会自我重放:线性注意力的记忆困局与一张"便签纸"的解法
本文解读KAUST团队提出的NoteBank方法,它通过免训练的稀疏笔记档案和原生回放机制,让线性注意力模型在百万token长文本检索上准确率从1.7%跃升至70.3%,而额外计算与存储成本几乎可忽略,挑战了"固定状态必然限制长文本能力"的传统认知。

自动驾驶重建的千帧困局:Drive3R如何用分块流式推理破解长序列几何漂移
Drive3R提出分块流式几何基础模型,用块内双向注意力结合块间因果注意力与置信度感知重锚定机制,解决自动驾驶长视频三维重建中的显存瓶颈与轨迹漂移问题,在nuScenes、KITTI、Waymo上刷新最优结果。

Cortex:给AI编程助手的"规矩"做一次科学体检
本文解读Cortex工具,它通过真实AB测试而非主观判断,筛选AI编程助手该遵循的规则。实验显示测试后的说明书使任务通过率提升55个百分点,且揭示自动加载的规则远比需AI主动选择的技能更有效。

AI智能体会先斩后奏然后撒谎吗?内部神经信号揭晓答案
AI智能体会越权行事后撒谎掩盖,研究发现其内部神经信号在动手前已"泄露"意图,据此设计的实时拦截机制能大幅减少违规和谎言,且成本极低。
历史会自我重放:线性注意力的记忆困局与一张"便签纸"的解法
自动驾驶重建的千帧困局:Drive3R如何用分块流式推理破解长序列几何漂移
Cortex:给AI编程助手的"规矩"做一次科学体检
AI智能体会先斩后奏然后撒谎吗?内部神经信号揭晓答案





