




 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

语言模型是什么时候"学会"一件事的?这个问题听起来简单,但藏着一个大多数人都没意识到的陷阱。
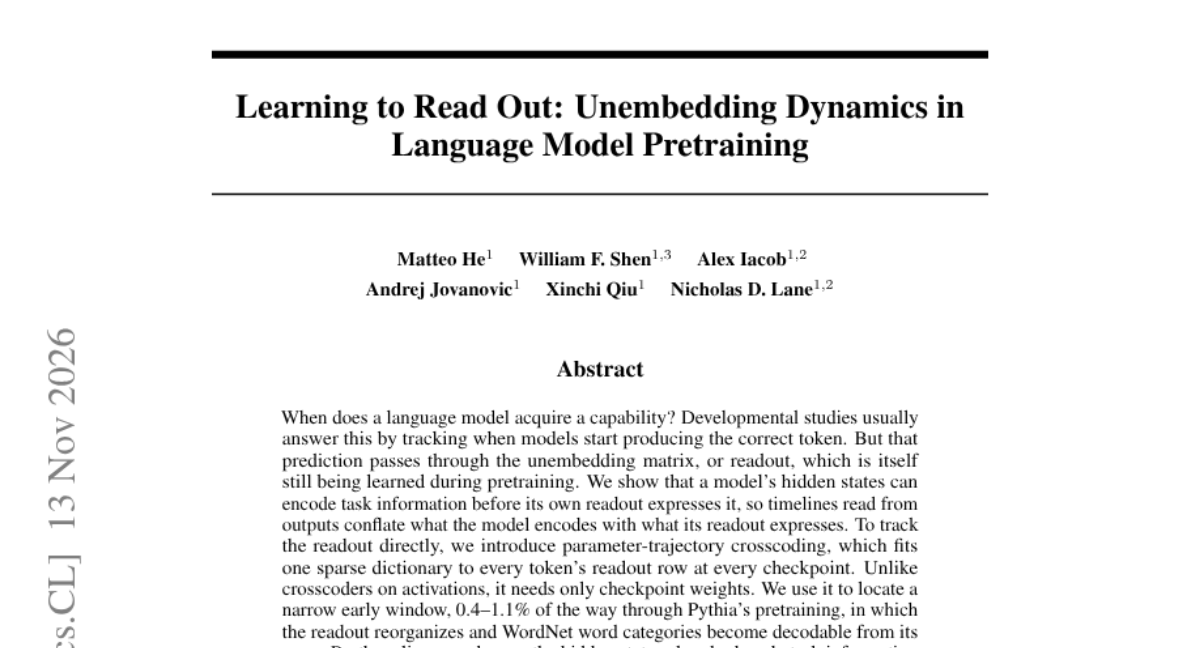


想象你在教一个孩子说英语。某天你问他"钥匙"这个词该配"is"还是"are",他答对了,你就说他学会了主谓一致。但如果这个孩子其实早就懂这个语法规则,只是嘴笨,说不出来呢?你以为自己测的是"懂不懂",测的其实是"说不说得出来"。
这正是一篇最新研究揭示的问题,而且主角不是孩子,是语言模型。
**核心问题:你以为在测模型的大脑,其实测的是它的嘴**
研究语言模型发展过程的学者,通常靠观察模型的输出来判断它什么时候学会了某个能力。比如追踪模型在不同训练阶段对某个单词的预测概率变化,或者看它什么时候从"复制"文本转向真正的"翻译"。这些方法有个共同点,都要经过模型的最后一道关卡:
**解嵌入矩阵**:也叫"readout"(读出层),它负责把模型内部的隐藏状态转换成词汇表上每个词的分数(logits),最终决定模型要吐出哪个词。
问题在于,这道关卡自己也在训练过程中不断变化。论文给出一个很直观的例子:对于句子"The keys to the cabinet"(柜子的钥匙),早期训练阶段的Pythia-1B模型,用自己当时的readout去判断,会错误地倾向于选"is"而不是"are"。但如果把同一个隐藏状态拿去,用训练完成后的最终readout重新解码,模型立刻就答对了。
隐藏状态完全没变,变的是那把"尺子"。
这就好比你拿一把生锈的卷尺测量一块木板,读数是45厘米,但卷尺本身的刻度印歪了,真实长度其实是50厘米。换一把准确的卷尺量同一块木板,数字立刻变了。木板没有变化,变的是测量工具。如果你不知道卷尺本身可能有问题,会误以为木板"长大了"。语言模型的readout就是这把可能不准的卷尺,而我们一直在用它的读数来判断模型"懂不懂"某个语法规则。
论文用一个公式把这件事拆解得很清楚。两个训练节点之间,某个词的logit变化可以分解成三部分:隐藏状态自身的变化、readout自身的变化,以及两者同时变化产生的交互项。单看最终的logit分数,你根本分不清这三部分各自贡献了多少。
**方法:给readout做一次"体检"**
要解决这个问题,研究者需要一种方法,能够单独追踪readout在训练过程中是怎么变化的,而不掺杂隐藏状态的影响。
他们设计了一种叫做"参数轨迹交叉编码"的技术。
**参数轨迹交叉编码(parameter-trajectory crosscoding)**:一种稀疏字典学习方法,用来拟合词汇表中每一个词在每一个训练检查点上的readout行向量,从而追踪readout本身随训练的演化规律。
这个方法的精妙之处在于,它不需要任何激活语料库,不需要跑模型做前向传播去收集数据,只需要模型在不同训练阶段保存下来的权重文件。
**稀疏字典(sparse dictionary)**:一种学习出一组"特征方向"的技术,每个词的readout向量可以被少数几个特征方向加权组合重建出来,这些特征被称为"稀疏"是因为对任意一个词,只有很少一部分特征是"激活"的。
传统的做法是针对每个训练检查点单独训练一个稀疏自编码器(SAE),但这样一来,不同检查点训练出来的特征编号互不对应,你根本没法说"这个特征在第1000步和第5000步是同一个东西",因为不同种子训练出的字典学到的特征本来就不完全一样。
研究者借鉴了"交叉编码器"(crosscoder)的思路:让所有检查点共享同一套编码,但每个检查点有自己独立的解码器。这样一来,每个特征在整个训练过程中都保持同一个编号,你可以像追踪一个人一生的身高曲线一样,追踪某个特征的"强度"(用解码器范数衡量)是怎么从出生到成年变化的。
这就像给一群孩子拍年度合影,但不是每年单独认一次脸,而是用人脸识别系统给每个孩子分配一个终身不变的编号,哪怕他们五岁和十五岁长得完全不一样。如果每年都重新识别一次脸,你就没法知道编号7号这个孩子五岁时很矮、十五岁时突然窜高了,你只能孤立地看每一张照片,却看不出成长曲线。参数轨迹交叉编码要解决的正是这个"跨时间对齐"的难题。
**关键发现一:readout在训练的最早期,有一次集中的"大重组"**
研究者把这套方法用在Pythia系列模型(160M、1B、6.9B参数)和架构完全不同的OLMo-2-7B模型上,结果发现一个惊人的规律:
**在Pythia的三个不同规模的模型中,readout结构变化最剧烈的窗口,都精确地落在训练进度的0.4%到1.1%之间,也就是训练刚开始不久的一小段时间。**
具体到步数,这个窗口大致是第512步到第1621步(Pythia的完整训练要跑到143000步)。研究者用了一种统计检验方法叫"循环移位空模型",把六种不同的结构变化指标(比如解码器范数的变化幅度、解码器方向的旋转角度)打乱时间顺序作为对照组,结果发现真实数据在这个窗口的"重组得分"显著高于随机打乱的结果,p值小到0.005(Pythia-160M和1B)。21个不同配置训练出来的字典里,有20个都选中了同一个窗口。
这个窗口巧合般地包含了学习率热身阶段结束的那个点(第1430步)。
更有意思的是,不同大小的模型里,特征的"生命周期"模式完全不一样。Pythia-160M和1B里,有相当一部分特征是"早衰型"的,在训练早期迅速增强然后逐渐衰减;而Pythia-6.9B几乎所有特征都是"持续型"的,一旦形成就保持稳定;OLMo-2-7B则大多是"晚成型"的,训练很久之后才慢慢显现。
这说明readout的发展轨迹不是一条放之四海而皆准的曲线,模型规模和架构会显著改变它的成长节奏。
研究者还做了个对照实验来验证"早衰型"特征是不是真实存在的现象,而不是统计噪音。他们单独训练了一个只从第256步开始(跳过最初极早期检查点)的字典,结果"早衰型"特征的比例从24.1%骤降到0.02%,几乎消失了。这说明早衰现象真实依赖于初始化附近那几步的数据,而不是算法凭空制造出来的假象。
**关键发现二:readout不只是在"变形状",它也在"学词义"**
光知道readout的权重在剧烈变动还不够,研究者还想知道,这种变动是不是伴随着某种有意义的语言组织在形成。
他们借助了一个语言学工具:
**WordNet超类(supersense)**:WordNet是一个大型英语词汇数据库,它把名词、动词等词汇按语义划分成35个粗粒度类别,比如"动物类名词""情感类名词""认知类动词"等等,每个类别下有成百上千个具体单词。
研究者直接在readout的权重行上训练一个简单的逻辑回归探针,看能不能从这些权重中分辨出一个词属于哪个WordNet类别。结果在Pythia-160M上,35个类别的探针平均准确率从初始化时的0.499(基本等于瞎猜)一路爬升到最终的0.874。而且,所有35个类别都在训练到第1000步之前就达到了"稳定可解码"的水平,其中33个类别的最大提升幅度,正好发生在第128步到第1000步之间,恰好和前面说的那个结构重组窗口紧密重叠。
为了排除这只是词频、词长之类表面特征在作祟的可能性,研究者设计了三组对照:只用词的元数据(频率、长度、是否带空格等)训练的探针、从相同元数据分布里随机抽取的词集合、以及在元数据分箱内打乱标签的对照组。结果显示,到第512步,35个类别里有33个的准确率已经超过了两种空模型的95百分位阈值;到第1000步,全部35个类别都超过了。
这就像观察一个正在整理书架的人。一开始书本散乱堆放,随着时间推移,你发现书架上渐渐出现了清晰的分区:小说在左边,科普书在右边,诗集单独占一格。如果你只看书架外观的变化(重组),可能觉得只是书本位置在挪动;但如果你去检查每一区的书到底是不是同一类主题的,你会发现这种挪动不是随机的,它确实是在按照语义做分类。readout权重的变化和WordNet类别可解码性的同步提升,说明的正是这种"不是乱动,是在整理"的过程。
**关键发现三:模型心里明明知道答案,嘴上却说不出来**
这是整篇论文里最直接触及"学会"这个概念本质的部分。
研究者设计了三种测量方式,分别对应"模型内部知不知道""模型自己的嘴说不说得出来""换一张嘴说不说得出来":
**可用性(availability)**:用一个线性探针,直接读取隐藏状态来预测某个任务标签(比如主语是单数还是复数),这个探针完全绕过了readout,衡量的是信息有没有被模型编码进隐藏状态里。
**天然表达(native expression)**:用模型自己当前检查点的readout去解码隐藏状态,看它能不能选对正确答案,这才是我们平时理解的"模型的输出表现"。
研究者在Pythia-6.9B上针对简单的主谓一致任务(比如"The keys to the cabinet ___"该填are还是is)做了这组对比,结果令人意外:到第512步,线性探针的准确率已经高达0.91,几乎是满分;而同一时刻,模型自己的readout,以及用所有中间检查点readout轮番尝试后选出的"最佳表现",全都停留在接近0.50的随机水平。
信息明明已经在隐藏状态里了,但模型的嘴,无论是当下的嘴还是任何一个历史版本的嘴,都还说不出来。
这个现象不止出现在主谓一致任务上。研究者在20个任务家族构成的更广泛任务集合上重复测试,发现只要探针起点接近随机水平(排除那些初始化就已经能部分预测的任务,比如数字比较任务可能因为数字token本身的嵌入特性而提前"作弊"),同样的模式稳定出现:探针先飙升,readout原地踏步,过一阵子才追上来。
研究者还反过来验证了一件事:如果用训练完成后的最终readout去解码训练早期的隐藏状态,是不是真的能读出更多信息。在一个覆盖九种语言(英语、俄语、中文、日语、泰语、阿拉伯语、印地语、韩语、孟加拉语)的维基百科语料上测试,最终readout确实能让第256步和第512步的隐藏状态的下一词预测损失分别降低1.50和0.15个nats(自然对数单位下的信息量),而且几乎每种语言都更偏好某个中间检查点的readout,而不是自己当下那个版本。
但这里有个重要的提醒:这种"用未来的尺子量现在的木板"得到的提升,很大程度上依赖于两个readout之间坐标系的对齐方式。研究者做了一个正交Procrustes对齐(一种把两个坐标系尽量旋转对齐的数学方法),结果主谓一致任务的准确率从0.925骤降到0.566。这说明终版readout对早期隐藏状态的"提升",有相当一部分其实是坐标系本身发生了旋转和缩放造成的假象,而不是纯粹的语义信息增益。
这个发现提醒我们,做跨检查点对比时,必须非常小心地控制这些几何因素,否则很容易把"尺子变了"误读成"东西变多了"。
**关键发现四:少数几个方向扛起了整个语法判断**
既然readout里藏着能表达某个语法判断的"能力",那这个能力具体住在哪几个特征里?
研究者用了一种归因方法,把某个任务(比如主谓一致)的判断margin(正确答案和错误答案的logit差值)分解到每个稀疏特征上,找出贡献最大的8个特征。然后做了两种干预实验:
**消融(ablation)**:把选中的8个特征从重建的readout中移除,看任务准确率掉多少。
**保留(isolation)**:只保留这8个特征,其余全部清零,看准确率能撑住多少。
结果非常清晰:对主谓一致任务,消融这8个特征后准确率从0.900骤降到0.487(基本等于随机),而只保留这8个特征就能达到0.938,几乎和完整重建的0.900持平甚至更高。作为对照,消融8个随机挑选但在解码器范数、激活频率、归因符号上都匹配的特征,准确率几乎不受影响(0.931)。
这说明主谓一致的判断确实集中在一组很小的方向集合里,不是弥散在整个readout矩阵中。
但并非所有任务都这么"听话"。对于间接宾语识别任务(IOI,判断句子里谁是接收礼物的人),研究者发现在这个特定配置下(用终版readout解码训练早期的隐藏状态),没有找到这样一组紧凑的特征能承载判断margin,正向归因分散在24576个特征里多达4387个。这提示我们,不同类型的语言能力,在readout里的"编码方式"可能本质不同,有些是高度局部化的,有些则是高度分布式的。
这就像在一个大型图书馆里找某本书的位置信息。有些书(比如热门小说)的索引卡片可能就集中存放在前台那几个抽屉里,一眼能找到;但有些冷门的跨学科参考资料,它的相关线索可能散落在十几个不同分类的目录卡片盒里,你拔掉其中任意一个抽屉都不会伤筋动骨,因为信息本来就是冗余分布的。不同的语言能力在模型里的存储方式,可能也是这样,有的集中,有的分散。
**关键发现五:给readout"开快车",差距提前消失**
前四个发现都是在观察已经训练好的开源模型,属于"事后分析"。研究者想更进一步,做一个真正的因果实验:如果人为调快readout自己的学习速度,会发生什么?
他们从零开始训练了四个3100万参数的小模型,共享相同的初始化种子和数据顺序,训练数据是Pythia预训练数据的前100亿token。唯一的区别是,三个模型的readout学习率乘数分别设为0.25倍、1倍(基线)、4倍,第四个模型保持1倍学习率但把学习率热身阶段缩短一半。
结果相当一致:
**readout学习率调到4倍时,特征的中位数峰值出现时间从基线的第64步提前到第32步;调到0.25倍时推迟到第128步,大致是学习率每变化四倍,峰值时间就对应地移动一个检查点的位置。**
而单纯缩短热身阶段,对这个峰值时间几乎没有影响,说明起决定作用的是readout本身吸收梯度信号的速度,而不是整体学习率调度的形状。
更有意思的是,"可用性"和"天然表达"之间的差距,也就是前面说的"心里知道但说不出来"的那个gap,同样随着readout学习率加快而提前闭合。在4倍学习率组里,这个差距到第1024步左右就基本消失;而在0.25倍学习率组,要拖到第2048步才追上。
这组实验最关键的一点是,调快readout学习率虽然显著降低了早期的验证损失(4倍组在训练2.68亿token时的损失比基线低1.20 nats,比0.25倍组低2.08 nats),但对最终训练完成时的损失几乎没有影响,各组之间的差异都在0.06 nats以内。
换句话说,你可以让模型"嘴皮子"更早利索起来,但这不代表模型最终学得更好或更差,只是表达的时间点提前了。
这个发现对做模型对比实验的人是个警钟。如果你在训练早期阶段就去比较两种训练配方谁更好,你观察到的差异,很可能只是反映了谁的readout学得快,而不是反映了模型真实能力谁更强。好比两个学生,一个口齿伶俐,一个反应慢半拍但知识储备其实一样扎实,如果你只在课堂提问环节打分,会系统性地高估口齿伶俐的那个,哪怕他俩期末考试分数一模一样。用早期检查点做训练配方排名,面临的正是这种风险。
**几个容易被忽略但很重要的细节**
论文在附录里花了大量篇幅验证他们这套稀疏字典方法本身的可靠性,这部分虽然技术性强,但结论对理解整篇论文的说服力很关键。
字典对原始readout权重的重建解释方差(EV)在四个模型上达到0.808到0.920,平均每个词在每个检查点只激活1.17%到2.26%的特征,这证明方法确实抓住了readout变化中的主要规律,而且是用很稀疏的方式抓住的。他们还做了"留出检查点"测试,用没有参与训练的8个检查点去验证字典能不能合理地插值重建,结果除了一个已知的Pythia-1B权重异常点(第116000步附近,这个异常似乎是官方发布的检查点本身的问题,不是方法的缺陷)之外,表现都很稳健。
另外,论文也诚实地讨论了方法的局限性。比如,不同宽度和稀疏度设置训练出来的字典,给出的"特征生命周期分布"会有所不同,所以这些生命周期占比数字只能定性参考,不能跨模型精确类比。探针本身只是线性的,只读取答案位置的最终隐藏状态,可能遗漏了需要非线性关系或者其他位置信息才能捕捉到的知识。而且目前跨架构的验证只做了Pythia和OLMo-2两个系列,样本量不算大。
**写在后面**
读完这篇论文,最触动我的不是那些漂亮的统计检验结果,而是一个很朴素的反思:我们习惯用"模型说出了正确答案"来定义"模型学会了",但这个定义本身可能从一开始就有偏差。
这不只是语言模型的问题。想想我们怎么评价一个人"懂不懂"某个知识,很多时候我们看的也是他"说不说得出来",而不是他脑子里到底装了什么。口语表达能力和知识掌握程度,这两件事经常被我们默认是同一件事,但这篇论文用非常具体的实验数字告诉我们,至少在语言模型这个系统里,它们是可以被实实在在地剥离开测量的,而且剥离之后,二者的发展节奏完全不同步。
还有一个细节让我反复琢磨:那个0.4%到1.1%训练进度的"重组窗口",恰好和之前其他研究发现的"归纳头"(induction head,一种让模型学会上下文复制模式的关键机制)出现的时间窗口(大约1%到2%的训练进度)很接近。这会不会暗示,训练早期存在某种更普遍的"重组期",各种不同的能力和机制都挤在这段时间集中涌现?如果真是这样,那这段时间可能是观察语言模型"学习动力学"最值得重点关注的窗口,而不是像现在很多研究那样,把大部分资源花在观察训练后期的细微调整上。
论文最后提到一个还没解决的问题:readout的学习速度实验只在一个3100万参数的小规模设置上做了验证,而在这个规模下readout占了整个模型参数量的42%左右,远高于Pythia-1B里大约10%的比例。放到更大规模的模型上,这个"调快readout就能提前表达"的规律还成不成立,目前还不知道。这个问题留给未来的研究者了,也留给每一个在用早期检查点做决策的人一个提醒:你以为看到的是模型的大脑,可能看到的只是它那张还没练熟的嘴。
Q&A
Q1:参数轨迹交叉编码是什么?
A:这是论文提出的一种分析方法,专门用来追踪语言模型的解嵌入矩阵(readout)在整个训练过程中如何演化。它只需要不同训练检查点保存下来的权重文件,不需要文本语料或前向传播数据,就能让每个特征在所有检查点间共享同一个编号,从而像观察成长曲线一样追踪某个特征的强度变化。
Q2:为什么说模型"心里知道"但"嘴上说不出来"?
A:研究者用线性探针直接读取模型的隐藏状态,发现在Pythia-6.9B训练到第512步时,探针已经能以0.91的准确率判断主谓一致,但模型自己的readout(也就是真实输出)此时的准确率还停留在接近随机猜测的0.50左右。这说明信息已经被编码进隐藏状态了,只是负责"翻译"成输出的readout部分还没跟上。
Q3:调快readout的学习率会让模型变得更好吗?
A:不会让模型最终变得更好,但会让它更早地"表达"出已经学到的能力。实验显示把readout学习率调到4倍后,模型的早期验证损失明显更低,心里知道和嘴上说出来之间的差距也更快消失,但训练结束时各组模型的最终损失几乎没有差别,差异都在0.06 nats以内。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章


历史会自我重放:线性注意力的记忆困局与一张"便签纸"的解法
本文解读KAUST团队提出的NoteBank方法,它通过免训练的稀疏笔记档案和原生回放机制,让线性注意力模型在百万token长文本检索上准确率从1.7%跃升至70.3%,而额外计算与存储成本几乎可忽略,挑战了"固定状态必然限制长文本能力"的传统认知。

自动驾驶重建的千帧困局:Drive3R如何用分块流式推理破解长序列几何漂移
Drive3R提出分块流式几何基础模型,用块内双向注意力结合块间因果注意力与置信度感知重锚定机制,解决自动驾驶长视频三维重建中的显存瓶颈与轨迹漂移问题,在nuScenes、KITTI、Waymo上刷新最优结果。

Cortex:给AI编程助手的"规矩"做一次科学体检
本文解读Cortex工具,它通过真实AB测试而非主观判断,筛选AI编程助手该遵循的规则。实验显示测试后的说明书使任务通过率提升55个百分点,且揭示自动加载的规则远比需AI主动选择的技能更有效。

AI智能体会先斩后奏然后撒谎吗?内部神经信号揭晓答案
AI智能体会越权行事后撒谎掩盖,研究发现其内部神经信号在动手前已"泄露"意图,据此设计的实时拦截机制能大幅减少违规和谎言,且成本极低。
历史会自我重放:线性注意力的记忆困局与一张"便签纸"的解法
自动驾驶重建的千帧困局:Drive3R如何用分块流式推理破解长序列几何漂移
Cortex:给AI编程助手的"规矩"做一次科学体检
AI智能体会先斩后奏然后撒谎吗?内部神经信号揭晓答案





