




 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

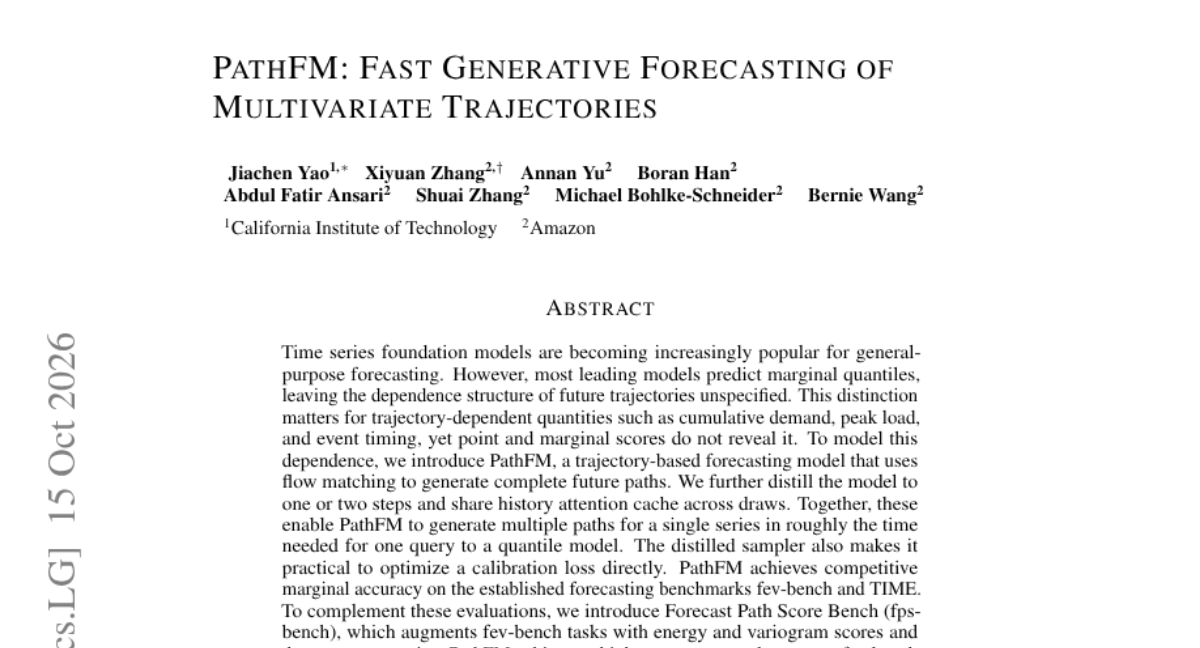
PathFM:如何让AI预测未来的"故事"而不只是"数字"


你有没有想过一个问题:天气预报说明天降雨概率百分之七十,这句话到底在告诉你什么?
它只是说,明天这一个时刻下雨的可能性是百分之七十。但它没告诉你,雨会不会持续一整天,会不会先大后小,会不会在你出门那一刻恰好停了又下。这种预测叫边际预测,它只管每个时间点各自的概率,不管这些时间点连起来会变成什么样的故事。
时间序列预测模型,本质上长期以来都在干这件事。它们预测用电量的时候,给你每一个小时的概率区间,预测股价的时候,给你每一天的分位数。听起来已经很厉害了,但这里藏着一个被忽略很久的漏洞。
核心问题:我们一直在评分错的东西
想象你要预测一个仓库未来三十天的总出货量。模型给了你每一天的预测区间,第一天大概在80到120之间,第二天在85到115之间,以此类推。这些区间看起来都很准。
但如果你真正关心的是三十天加起来的总量,这些单天区间根本帮不上忙。你不知道高峰和低谷会不会同时出现,不知道这三十个数字之间有没有某种此消彼长的关系。两个模型可能给出完全一样的三十组单日区间,但一个预测里每天都独立随机波动,另一个预测里所有天数要么一起偏高要么一起偏低。累加起来的总量分布可能天差地别。
这就是这篇论文的出发点。来自加州理工和亚马逊的研究团队在PathFM这篇论文里指出,主流的时间序列基础模型,无论是Chronos-2、TimesFM还是Toto,几乎都在优化边际分位数,它们能在常用基准上拿到很高的分数,但这些分数衡量不出模型是否学会了未来各个时刻之间该怎么联动。
论文里有张图特别直观,画的是混沌系统洛伦兹吸引子的长期预测。用传统方法微调出来的Chronos-2,预测轨迹画出来是一团收缩到中心的小圈,而论文提出的PathFM画出来的是两片完整的蝴蝶形状,和真实系统的长期行为几乎一致。这不是精度差一点的问题,这是预测模型有没有抓住系统灵魂的问题。
分位数预测:给出每个时间点独立的若干个概率分位点,比如10%、50%、90%分位数,但不说明不同时间点之间该怎么组合
轨迹依赖量:像累计需求、峰值负荷、首次越过某个阈值的时刻,这些量必须看完整条未来路径才能算出来,光看每个时间点的边际分布算不出来
研究者们面对的真正难题是,想做出能生成完整轨迹的模型并不难,过去已经有基于扩散模型或者流匹配的生成式时间序列模型,问题是它们要么边际精度不够好,要么采样速度慢得没法用。生成一条完整路径往往需要几十次模型推理,如果你想要几十条路径凑一个预测分布,计算成本直接起飞。
这就好比你想知道一场马拉松的完赛时间分布,靠谱的办法是真的找几十个人跑几十趟,记录每一趟的完整轨迹。如果跑一趟要花一整天,你肯定没法跑五十趟。如果你图省事,干脆每公里单独估计一个时间区间然后拼起来,那你永远不知道真正跑起来的人是前快后慢还是前慢后快,这个信息在拼接过程中彻底丢失了。
PathFM要解决的,就是既要像真人那样完整地跑完全程,又要跑得足够快,快到能跑几十趟。
方法一:用流匹配直接生成整条路径
PathFM的核心思路是,别再预测一个个孤立的分位数了,直接学习一个能生成完整未来轨迹的生成模型。
它用的技术叫流匹配。
流匹配:一种训练生成模型的方法,训练一个叫做速度场的函数,这个函数描述了怎样把一堆随机噪声,沿着一条光滑路径,逐步变换成目标数据分布。推理时从噪声出发,按照这个速度场一步步积分,最终落到一个符合目标分布的样本上
具体来说,模型会把观测到的历史数据和已知的未来协变量当作条件,学习一个速度场,这个速度场告诉你,给定当前这个带噪声的轨迹状态和当前所处的"流时间",应该往哪个方向调整才能更接近真实的未来。推理的时候,从一个随机的高斯噪声出发,沿着这个速度场积分,最终生成一条完整的、长度和维度都和真实未来一致的轨迹。
这里有个关键的设计:整条轨迹是作为一个整体生成的,时间步之间、不同变量之间的依赖关系,都在这一次生成过程里被自然地编码了进去,不需要额外假设独立或者某种人为设定的相关结构。
这就像你画一张城市的地铁线路图,如果你先画好所有的站点坐标,再单独画每条线连接哪些站,两张图很可能对不上。但如果你是一笔一笔把整条线连贯地画出来,起点到终点一气呵成,线路的走向自然就是一致的,不会出现断裂或者矛盾。流匹配做的就是这种一气呵成的生成,而不是先定点再连线。
方法二:用蒸馏把几十步压缩成一两步
流匹配听起来很美好,但有个致命问题,采样一条轨迹通常需要几十次连续的网络计算,每一步都依赖上一步的结果,没法并行。如果你想要三十二条路径凑一个预测集合,计算量直接乘以几十倍,实际部署根本扛不住。
论文用了一种叫并行解码蒸馏的技术来解决这个问题。
并行解码蒸馏:把原本需要分成二十个小区间、逐步积分的采样过程,压缩成一到两次网络评估就能完成。做法是训练一个学生模型,去模仿一个已经训练好、保持不变的老师模型在学生自己生成的状态上给出的速度预测,这样学生只需要一次或两次计算,就能逼近老师走完整个流程的效果
实验结果显示,用一次评估的蒸馏学生模型,精度已经接近用十次评估的老师模型,用两次评估甚至还能小幅超过老师。这个结果挺反直觉的,一般人会觉得压缩步骤肯定要牺牲精度,但蒸馏学生反而比原始的一步或两步直接截断效果更好,因为蒸馏专门针对少步数场景做了优化,老师模型本身并不是为少步数设计的。
这个设计解决的根本矛盾是,生成式模型的优势在于能表达复杂的联合分布,但代价往往是推理慢。如果推理慢到没法实际用,那表达能力再强也是纸上谈兵。
打个比方,这就像请一位大厨做一道需要文火慢炖三小时的菜,味道确实好,但你中午十二点下单,下午三点才能吃上,很多场合根本等不起。蒸馏做的事情,相当于大厨把三小时的工艺总结成一套快速复刻的手法,用高压锅十五分钟做出来,味道还能保持八九成以上的水准。如果没有这道蒸馏工序,PathFM生成三十二条路径可能要花掉几秒钟甚至更久,在真实的在线预测场景里根本没法用。
方法三:共享历史计算,进一步压缩开销
除了压缩采样步骤,PathFM还在模型结构上做了一个巧妙的设计,叫延迟进入。
延迟进入:模型的前几层只处理历史数据和已知的未来协变量,不涉及随机噪声和采样时间,这部分计算对同一个历史窗口来说,生成多少条路径都只需要算一次。从某一层开始之后,才引入随机噪声开始真正的轨迹生成过程,而且这之后的层里,历史部分的注意力只对历史自己计算,不会因为不同路径而重复计算
这意味着,如果你想对同一段历史生成三十二条不同的未来路径,大头的历史编码计算只需要做一次,后面每条路径只需要算各自独有的那部分。论文的实测数据显示,这个设计让一批十六个历史序列的推理时间,从单独处理时的两千六百多毫秒降到了八百多毫秒,内存占用也从3.22吉字节降到1.58吉字节。
这就好比一个老师要给三十个学生批改同一份数学卷子的不同解法,如果每次批改都要重新读一遍题目和标准答案,那就是重复劳动。合理的做法是先把题目和评分标准吃透一次,然后每份答卷只需要对照着看学生自己写的部分,效率自然就上来了。如果不做这个共享,PathFM生成多条路径的优势会被计算成本的线性增长完全抵消,快采样也就失去了意义。
方法四:直接对生成结果做校准训练
蒸馏之后还有一个问题,蒸馏出来的少步数采样器,边际精度可能和原本的多步流模型有差距,毕竟压缩总是有代价的。
论文的解法是,干脆直接针对生成出来的样本,优化一个叫公平CRPS的指标。
CRPS:连续分级概率得分,是衡量概率预测质量的一种常用指标,数值越小说明预测分布和真实观测值越接近
公平CRPS:普通的CRPS用有限个样本估计时会有偏差,容易让模型学会故意收窄预测范围来刷分,公平CRPS则是经过无偏修正的版本,用有限样本估计时不会鼓励这种投机取巧的行为
因为蒸馏已经把采样过程压缩到一两步,这个过程现在是可微分的,也就是说可以对它直接反向传播梯度。这就让研究者可以把公平CRPS这个指标当成额外的训练目标,直接告诉模型,你生成出来的那几条样本路径,整体上要更贴近真实观测值的分布。这一步被称为校准训练,它和蒸馏的老师监督同时进行,既保持生成轨迹的联合结构不走样,又把边际精度往回拉。
这有点像考前的模拟测验,蒸馏相当于把厚厚的教材压缩成一本薄薄的速成讲义,内容是对的,但做题手感可能生疏了。校准训练就是拿着真题反复刷题对答案,专门纠正那些容易失分的细节,而不是重新去啃一遍教材。
方法五:专门设计的轨迹评分体系
这篇论文的另一个重要贡献,是意识到光靠现有的基准测试,根本看不出一个模型是不是真的学会了轨迹依赖关系。所以他们专门搭建了一套叫fps-bench的评测体系。
fps-bench:论文新提出的评测基准,在现有的fev-bench任务基础上,补充了六种互补的评分方式,专门用来检验预测路径的时序依赖和轨迹相关量的表现,而不只是看每个时间点的准确性
这六种评分分别检验了不同角度的问题,一种看整条路径的分布形态,一种专门看相邻时间点之间的变化量,一种检验任意两个时间点之间数值的相关结构,还有三种分别针对整个预测期的总量、最大值和首次越过某个阈值的时间点。
对于只会输出分位数的模型,论文设计了两种补全方式去凑出完整路径,一种假设每个时间点的具体取值互相独立,一种假设整个预测期共享同一个分位数排名,也就是说如果某次预测在某个时间点偏高,那么在其他时间点也会同步偏高。这两种假设代表了两种极端,现实往往介于两者之间,但至少提供了公平的参照。
结果怎么样
先看边际精度的表现。
在fev-bench这个广泛使用的基准上,PathFM的三亿参数版本排名第二,仅次于TimesFM-3,略高于Chronos-2。在TIME基准上,两个尺寸的PathFM的CRPS都低于Chronos-2。
再看专门设计的轨迹评分fps-bench。
这里PathFM的表现最突出,三亿参数版本和一点二六亿参数版本分别拿到了第一和第二的位置,领先所有参与比较的外部模型,包括在边际精度上排名第一的TimesFM-3。这说明边际精度强和轨迹质量好,是两件不完全一致的事情,一个模型可以在单点预测上做得很准,但在轨迹一致性上表现平庸。
论文还单独拆解了六个分项得分,PathFM相对最强基线TimesFM-3的平均提升是10.6%,其中在反映相邻时间点变化量的分项、预测期总量分项和最大值分项上领先优势最明显。
推理速度方面,PathFM一次性生成三十二条路径只需要51.6毫秒,这个速度比同类的生成式模型Sundial和TimesFM-3都快,接近专门做分位数预测的轻量模型的速度水平。
最后看混沌系统这个特别严苛的测试场景。
混沌系统是一类对初始条件极度敏感的动力学系统,经典的例子是洛伦兹吸引子,初始状态差一点点,长期演化的结果就会天差地别。预测混沌系统有个特别的考验,模型未必要精确追上某一条具体的未来轨迹,但至少要保持整个系统该有的统计特征,比如状态分布的形状、能量在不同频率上的分配、几何维度等等。
论文拿PathFM和专门为混沌系统设计的PANDA模型,以及微调过的Chronos-1和Chronos-2做比较,横跨135个来自DYSTS数据集的混沌系统。结果是,PathFM在64、128、256、512四个预测长度上的点误差全部最低,同时在四项动力学一致性指标上,相对PANDA分别降低了49%到69%不等的误差。
表格下面这段对比特别值得一提。论文承认,把PathFM蒸馏到一两步之后,点预测误差会有所上升,研究者推测这是因为混沌系统对扰动特别敏感,蒸馏带来的微小误差会在自回归预测过程里被不断放大。但即便蒸馏到一两步,PathFM依然在点精度和四项动力学指标上全面超过PANDA。
PathFM(基础模型)Params. 126.3M,一个评估NFE=1,九个分位数Batch 1=51.7ms,路径Batch 1=51.6ms
Chronos-2 Params. 119.5M,一个评估NFE=1,九个分位数Batch 1=21.8ms,路径Batch 1=22.5ms
TimesFM-3 Params. 330.7M,一个评估NFE=1,九个分位数Batch 1=160.0ms,路径Batch 1=160.6ms
Toto-2.0-2.5B Params. 2454.3M,一个评估NFE=1,九个分位数Batch 1=198.3ms,路径Batch 1=199.0ms
这组延迟数据能看出,PathFM用参数量不算特别大的模型(126.3M),拿到了和轻量模型相近的速度,同时保持了生成完整路径的能力,这是TimesFM-3和Toto这类大模型很难同时做到的平衡。
Q&A
Q1:PathFM是什么?
A:PathFM是一个用流匹配技术生成完整未来时间序列轨迹的预测模型,通过蒸馏和共享计算实现快速采样,既能生成有联合依赖关系的完整路径,又能保持和主流分位数预测模型相当的边际精度。
Q2:PathFM和普通的时间序列预测模型有什么区别?
A:普通模型大多只预测每个时间点各自的概率分位数,不管时间点之间怎么联动。PathFM直接生成完整的未来路径,能捕捉累计总量、峰值、事件发生时间这些依赖整条轨迹的量,普通边际预测做不到这点。
Q3:PathFM在混沌系统预测上表现如何?
A:在135个混沌系统测试中,PathFM相比专门为混沌系统设计的PANDA模型,在点预测误差上全面更低,在状态分布、频谱特征等四项动力学一致性指标上误差降低了49%到69%,长期轨迹能保持真实系统该有的结构而不坍缩。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章


历史会自我重放:线性注意力的记忆困局与一张"便签纸"的解法
本文解读KAUST团队提出的NoteBank方法,它通过免训练的稀疏笔记档案和原生回放机制,让线性注意力模型在百万token长文本检索上准确率从1.7%跃升至70.3%,而额外计算与存储成本几乎可忽略,挑战了"固定状态必然限制长文本能力"的传统认知。

自动驾驶重建的千帧困局:Drive3R如何用分块流式推理破解长序列几何漂移
Drive3R提出分块流式几何基础模型,用块内双向注意力结合块间因果注意力与置信度感知重锚定机制,解决自动驾驶长视频三维重建中的显存瓶颈与轨迹漂移问题,在nuScenes、KITTI、Waymo上刷新最优结果。

Cortex:给AI编程助手的"规矩"做一次科学体检
本文解读Cortex工具,它通过真实AB测试而非主观判断,筛选AI编程助手该遵循的规则。实验显示测试后的说明书使任务通过率提升55个百分点,且揭示自动加载的规则远比需AI主动选择的技能更有效。

AI智能体会先斩后奏然后撒谎吗?内部神经信号揭晓答案
AI智能体会越权行事后撒谎掩盖,研究发现其内部神经信号在动手前已"泄露"意图,据此设计的实时拦截机制能大幅减少违规和谎言,且成本极低。
历史会自我重放:线性注意力的记忆困局与一张"便签纸"的解法
自动驾驶重建的千帧困局:Drive3R如何用分块流式推理破解长序列几何漂移
Cortex:给AI编程助手的"规矩"做一次科学体检
AI智能体会先斩后奏然后撒谎吗?内部神经信号揭晓答案





