

 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

网信办:商业网站9种违法情形将对负责人约谈


网信办:商业网站9种违法情形将对负责人约谈
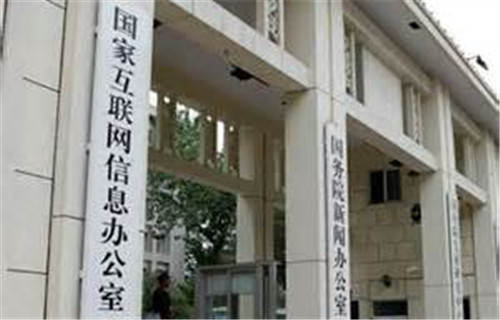
4月29日消息,国家互联网信息办公室发布《互联网新闻信息服务单位约谈工作规定》,规定通过采编、发布、转载、删除新闻信息等谋取不正当利益等9种违法情形将对主要负责人、总编辑等约谈,未达到整改要求或未按要求整改的单位将依法予以处罚。该规定于6月1日起实施。
《规定》中的9种违法情形包括:未及时处理公民、法人和其他组织关于互联网新闻信息服务的投诉、举报情节严重的;通过采编、发布、转载、删除新闻信息等谋取不正当利益的;违反互联网用户账号名称注册、使用、管理相关规定情节严重的;未及时处置违法信息情节严重的;未及时落实监管措施情节严重的;内容管理和网络安全制度不健全、不落实的;网站日常考核中问题突出的;年检中问题突出的;其他违反相关法律法规规定需要约谈的情形。
《规定》称,互联网新闻信息服务单位未按要求整改,或经综合评估未达到整改要求的,将依照《互联网信息服务管理办法》、《互联网新闻信息服务管理规定》的有关规定给予警告、罚款、责令停业整顿、吊销许可证等处罚;互联网新闻信息服务单位被多次约谈仍然存在违法行为的,依法从重处罚。
此前,国家网信办和北京等地网信办,已经通过约谈一些违法情节严重的互联网新闻信息服务单位,督促其采取有效措施进行整改。比如,在今年2月2日曾约谈网易,收到了良好效果。网信办方面称,上述规定是在这些实际工作的基础上进一步研究出台的。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章
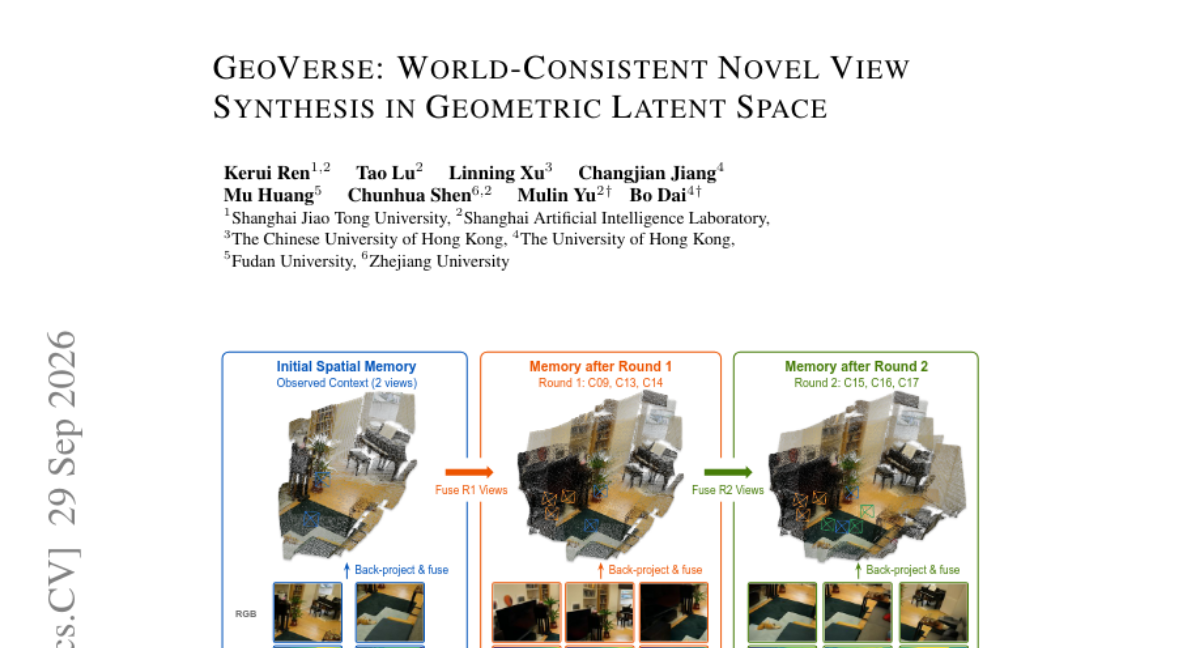
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





