




 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

英特尔酷睿Ultra第三代,如何推动AI PC规模化落地?


2023年9月,在英特尔正式提出AI PC概念后,一个全新的PC纪元拉开帷幕。
彼时,就在大家都还在谈论什么样的PC,才是真正的AI PC时,英特尔已经做出了一个大胆的预测:到2028年,AI PC将占据PC市场80%的市场份额。
时隔两年后,AI PC已经开始成为PC市场的主流趋势。
据Gartner给出的预测数据显示,到2025年末,AI PC在全球出货量预计将达到7780万台,市场份额将达到31%,AI PC最终将会在2029年成为常态。
也是在这一年,就在大家开始接受生成式AI将改变一切时,越来越多人需要一台AI PC,来作为新一代生产力工具。
作为AI PC的提出者,也是AI PC的算力提供者,英特尔代号为Panther Lake的酷睿Ultra第三代处理器将在CES 2026上正式发布。
而英特尔Panther Lake处理器带来的性能提升,也将成为AI PC规模化落地的关键。

01 基于三层混合核心策略,将CPU性能再提升50%
生成式AI技术的普及应用,拉升了个人用户对算力的需求,如何为AI PC打造一颗高算力、低能耗的AI芯片,就成了英特尔必须要面对的问题。
Panther Lake,正是英特尔给出的又一个答案。
作为英特尔酷睿Ultra第三代处理器,Panther Lake延续了英特尔从Meteor Lake就已经开始应用的三层混合核心策略——性能核(P核)侧重于提升单线程性能和吞吐量,能效核(E核)侧重于提升多线程性能和并行计算能力,低功耗能效核(LP-E核)则侧重于解决日常低负载效率任务。
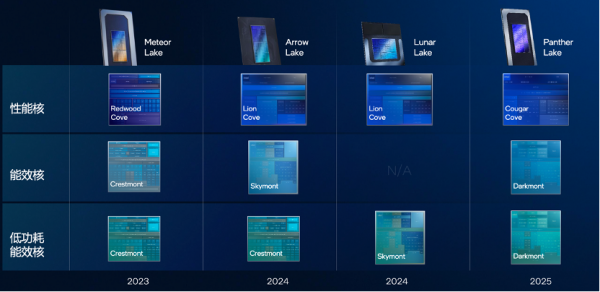
在此基础上,这些内核又都基于英特尔最新的Intel 18A制程得到了大幅优化,性能得到再次提升。
以性能核为例,Panther Lake全新的Cougar Cove性能核保留了18个执行端口同时,L3缓存容量提升了50%,达到了18MB,与此同时,还在以下三个方面得到了提升:
第一,引入内存消歧。
CPU在处理内存读写操作时,往往需要严格遵循指令的读写顺序,这种严格的依赖关系导致内存单元经常处于等待状态,由此也造成了内存带宽利用率低下,无法充分发挥硬件潜力。
内存消歧技术通过智能预测,精准预测出哪些操作可以并行执行、哪些存在真实依赖,打破了原本的依赖关系,让CPU多个执行单元能够进行乱序或并行内存读写操作,从而充分利用内存带宽。
第二,TLB再增强。
TLB本质上是CPU内部虚拟地址到物理地址的映射缓存,它将常用的地址映射预先存储,实现快速查找,从而避免CPU频繁访问系统内存进行页表遍历的耗时。
得益于Intel 18A先进制程,英特尔在Panther Lake上实现了1.5倍的容量提升,极大地提升了复杂工作负载下的应用体验。
第三,优化分支预测。
分支预测技术的核心在于通过CPU预判程序执行路径中可能出现的分支,并提前做好准备,这其中有两项指标尤为关键,一个是预测分支走向的准确率,另一个是将预测结果反馈给CPU核心流水线的时效性。
相较于英特尔上一代产品Lunar Lake,Panther Lake首先在预测准确性和分支预测的延迟上都有了大幅优化,从而使得CPU能够将更少的时间花费在预测和修正开销上,将更多时间投入到真正有用的计算任务中,从而显著提升有效计算时间占比。
此外,Panther Lake的能效核同样引入了分支预测、内存消歧技术,并优化了动态预取器控制、Nanocode,将多线程和并行计算能力进行了大幅提升。
据英特尔官方给出的数据显示,在这一系列技术加持下,Panther Lake与上一代处理器相比,在执行单线程任务时,相似性能下功耗降低了超40%,相似功耗下性能提升超10%,在执行多线程任务时,相似功耗下性能提升超50%,相似性能下功耗降低超30%。
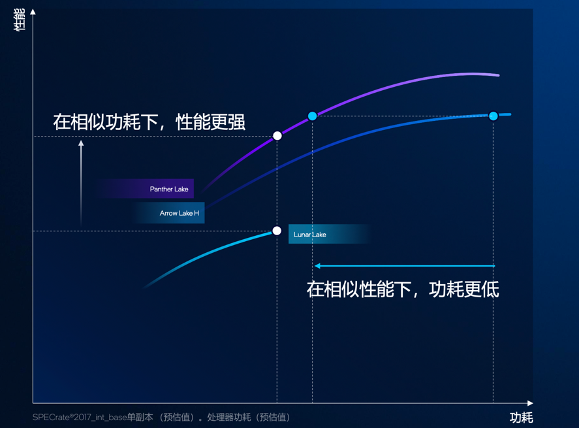
Panther Lake不仅继承了Lunar Lake高能效和Arrow Lake高性能优势,CPU和GPU性能较上一代产品提升了50%,还引入了性能更高、面积更小的NPU,为AI PC规模化量产、成为新一代生产力工具打下了基础。
02 生成式AI应用爆发,生产力工具技术重构
来自中国互联网络信息中心统计数据显示,截至2025年8月底,我国累计有538款生成式AI服务完成备案,263款生成式AI应用或功能完成登记。
与此同时,截止2025年6月,我国生成式AI用户规模达到5.15亿人,普及率达到了36.5%。
生成式AI应用大爆发、用户渗透率持续上升,让PC用户的日常应用场景已经从单纯的办公、浏览、游戏等负载转向同时涉及传统计算、图形渲染,乃至AI推理的混合工作负载。
为了应对这样的混合工作负载,英特尔面向AI PC打造的酷睿Ultra做出了两方面技术重构:
首先是,前文提到的三层混合核心策略。
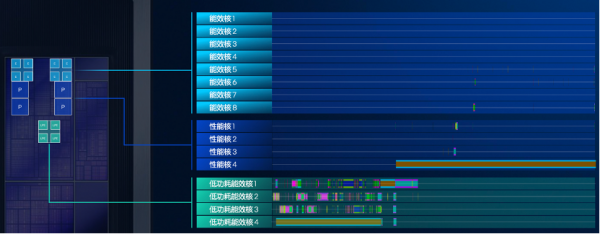
在Panther Lake处理器中,最终是由硬件线程调度器来完成对不同核心的调用和任务分配,由于能效核、性能核、低功耗能效核,以及能效曲线相较前代都有了不小的优化,英特尔这代产品中硬件线程调度器的分类模型根据Panther Lake的核心特性进行了分类,并采集了更多系统级的信息来对反馈表进行升级。
在这一系列指标优化下,Panther Lake中的硬件线程调度器可以在更多场景下来实现混合核心之间的并行调度,更大程度发挥出了三层混合核心策略的优势。
英特尔技术专家就曾以UL Procyon基准测试模拟混合工作负载进行测试,在混合工作负载环境下,当没有突发性高负载需求时,系统优先保持在低功耗模式运行,当检测到需要高性能响应的突发性大负载时,系统会迅速将该负载调度至性能核进行处理,从而为用户提供快速响应。
其次是,CPU、GPU、NPU构成的XPU架构。
传统PC负载相对单一,往往是由CPU处理逻辑任务,GPU处理图形任务,生成式AI的普及应用,将PC负载拉升到了一个新维度。
这其中既有如在线会议中的实时翻译、语音转录、背景虚化这类持续低强度AI后台任务运行需求,有如图像处理工作中的生成图像、视频编辑AI增强、Copilot复杂查询这类突发高强度AI任务运行需求,也有用户边办公边运行AI助手、边游戏边使用AI生成直播工具这类多任务并行需求。这就要求AI PC拥有足够强的本地AI算力。
英特尔Panther Lake处理器中将专为AI负载提供算力的运算单元NPU升级到了NPU5,每个神经计算引擎中引入了更大的MAC阵列单元,从而提供更高的计算密度和运算效率,并能最高提供180TOPS平台算力。
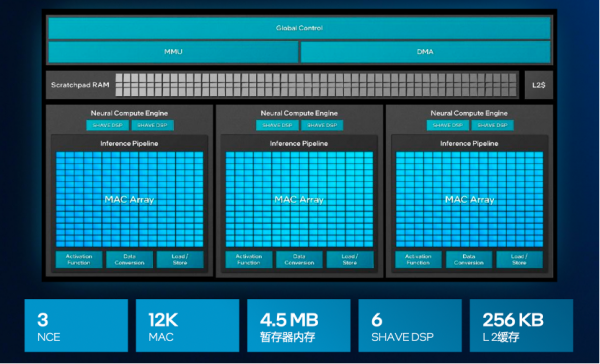
在面对越来越多强算力需求的AI工作负载时,对于AI PC,续航能力是另一个大多数用户关注的点,为了提升笔记本电池供电下的续航能力和用户体验,英特尔在电源管理堆栈中引入了智能自适应机制,在后台根据实际工作负载,自动在预先设置的性能模式和更高效的节能模式之间进行无缝切换。
据Gartner给出的预测数据显示,到2026年末,优先投资开发PC端AI功能的软件厂商比例将从2024年的2%攀升至40%,并出现多种能够在PC端本地运行、在2023年之前不曾出现的小语言模型(SLM)。
英特尔在Panther Lake中进行的这一系列技术调整和架构优化,正是在解决AI工作负载、优化AI应用体验、推动AI PC这一轮生产力变革。
03 OEM齐发力,AI PC迎来规模化落地
2026年,正在成为AI PC规模化落地的关键一年。
据Gartner给出的预测数据显示,2026年AI PC出货量将达到1.43亿台,市场份额将达到55%。
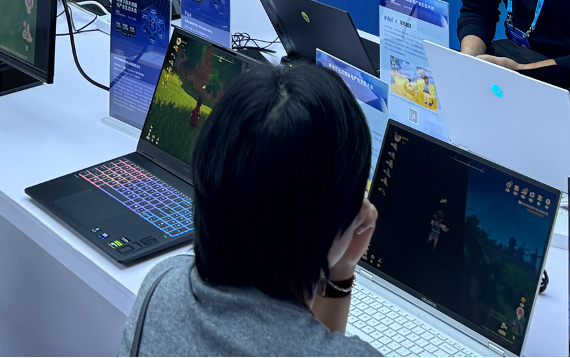
与此同时,一年一度的全球消费电子大型盛会CES 2026即将于1月6日在拉斯维加斯拉开帷幕,联想、华硕、雷神等一众PC厂商已经相继官宣,将在CES 2026上推出AI PC新品。
在CES 2026上,有两项关乎AI PC的关键发布值得我们期待:
第一,英特尔Panther Lake将正式发布,作为首款基于Intel 18A制程的客户端处理器,这款采用XPU架构、三层混合核心策略,以及大量AI优化算法,并拥有180TOPS算力处理器,将在2026年成为AI PC规模化爆发的底层基础。
第二,联想、华硕等一众PC厂商搭载Panther Lake的AI PC,也将在CES 2026上集中亮相,这些产品将成为2026年AI PC市场主力产品,也将成为推动AI PC市占率突破50%的主力军。
2026年,在大模型引爆新一轮AI硬件热潮后,AI PC率先成了引领这场生产力变革的主角。


 0赞
好文章,需要你的鼓励



至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章


GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。

TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。

该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。

AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
金旺
主编





