

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

国立情报学研究所&综合研究大学院大学&东京大学联合出品:当AI学会"挑剔"地读懂评分标准,奖励模型的准确性提升了几个档次


这项由日本国立情报学研究所(National Institute of Informatics)、综合研究大学院大学(SOKENDAI)及东京大学联合开展的研究,以预印本形式发布于2026年4月,论文编号为arXiv:2604.13618v1,感兴趣的读者可通过该编号在arXiv平台查阅完整原文。
**一、故事从一个"老师改卷"的困境说起**
教过学生的老师都知道,批改作文是件头疼的事。数学题有标准答案,对就是对,错就是错。但作文呢?"这篇文章好不好"这个问题,不同的老师可能给出截然不同的分数。如果你让老师在没有任何评分标准的情况下批改,结果往往摇摆不定;但如果给老师一份详细的评分量规——比如"结构是否清晰?论证是否有力?用词是否恰当?"——老师的评分就会稳定得多,也更可靠。
大型语言模型(比如ChatGPT这类AI)的训练面临着同样的困境。研究人员需要告诉AI什么样的回答是好的,什么样的是坏的,这个过程叫做"基于人类反馈的强化学习",简称RLHF。在这个过程中,有一个关键角色叫做"奖励模型"——你可以把它理解为那位负责打分的老师。奖励模型读过两个候选回答之后,要判断哪个更好,然后给出一个分数,指导AI往好的方向学习。
问题在于,当评价标准是隐性的、主观的时候——比如评价一篇创意写作、一段礼貌的客服回复——仅凭奖励模型自己的"直觉"打分,结果往往不够可靠。正如没有评分量规的老师改卷,容易被表面的华丽文字迷惑,而忽视了内容的实质。
于是,研究者们提出了一种叫做"量规增强验证"的方法:在让奖励模型打分之前,先给它一份评分量规(rubric),把评价标准拆解成一系列可以回答"是"或"否"的具体问题,比如"回答的语气是否礼貌?"、"是否提供了实质性的解决方案?"有了这份清单,奖励模型的判断就稳定多了。
然而,这条路并不好走。绝大多数现有的量规增强方法,都需要人工标注员手写量规,或者花钱调用大型专有模型来生成量规。这不仅成本高昂,还意味着大量现成的偏好数据(也就是那些简单标注了"A比B好"的数据对)根本用不上。更麻烦的是,这篇论文的研究团队通过实验发现,自动生成的量规其实是把双刃剑——质量好的量规确实能大幅提升判断准确率,但质量差的量规反而会把奖励模型引向错误答案,比没有量规还糟糕。
这就是研究的出发点:能不能设计一套方法,只用那些廉价易得的"A比B好"二元偏好数据,就训练出一个既会生成优质量规、又会识别并拒绝劣质量规的奖励模型?
**二、先摸清楚:自生成的量规到底有多靠谱?**
在正式提出解决方案之前,研究团队先做了一番"摸底调查",用实验数据搞清楚自生成量规的真实效果。
他们选用了一个叫做RM-Bench的测试集中最难的那部分数据。这个测试集特别刁钻,专门把那些"文笔华丽但内容空洞"的被拒绝答案,与"内容扎实但文笔一般"的正确答案配对,考验奖励模型能不能看穿表面、抓住实质。
研究团队训练了两个奖励模型,分别基于两个不同的基础模型:一个叫Tulu3-8B-SFT,另一个叫Qwen3-8B。训练方式是用一种叫GRPO的强化学习方法,让模型在给出判断之前先"想一想",输出一段推理过程,再给出最终答案。
实验设计是这样的:对于测试集里的每一道题,先让基础模型随机生成一条量规,然后分别看看奖励模型"带着量规判断"和"不带量规直接判断"的准确率差多少。
结果让人有些意外。随机生成的量规,绝大多数情况下对模型的判断几乎没有影响——准确率的变化幅度集中在零附近,就像向平静的湖面扔了一粒沙,几乎没有涟漪。Tulu3-8B-SFT模型的结果甚至偏向负面,负向偏移的量规比正向偏移的还多;Qwen3-8B稍好一些,但有益的量规依然稀少。
这说明随机生成量规没什么用,但研究者并没有就此放弃。他们接着追问:那质量好的量规和质量差的量规,分别会产生什么效果?
为了回答这个问题,他们让基础模型对每道题生成五条量规,然后用GPT-5(一个能力很强的大模型)对每条量规打1到5分,评估这条量规是否准确捕捉了题目意图,以及是否能有效区分好坏答案。评分4到5分的量规被标记为"高质量",1到2分的被标记为"低质量"。最后,他们挑出同时拥有高质量和低质量量规的300道题,分四种条件测试奖励模型:不使用量规、使用随机量规、使用高质量量规、使用低质量量规。
数据说话:使用高质量量规时,Tulu3-8B-SFT的准确率从50.3%飙升到58.5%,提升了8.2个百分点;Qwen3-8B则从61%跳到74.7%,足足提升了13.6个百分点。而使用低质量量规时,结果惨不忍睹——Tulu3-8B-SFT跌到39.6%,Qwen3-8B跌到49.3%,都远低于"不用量规"的基准线。
这组数据揭示了一个关键事实:奖励模型并没有无视量规,而是真的在跟着量规走。量规质量好,它就走上正轨;量规质量差,它就被带进沟里。这正是所谓"合作失败"——生成量规的模块和使用量规的模块没有形成有效配合,反而相互拆台。
于是,研究目标变得非常清晰:需要一套机制,让量规生成端只产出有帮助的量规,让验证端学会识别并拒绝有害的量规。
**三、C2框架:让"出题老师"和"阅卷老师"学会配合与互相审查**
研究团队从人类沟通的智慧中找到了灵感。语言学家格莱斯(Grice)早在1975年就指出,人类沟通之所以能顺畅运转,不是因为说话者总是完美可靠,而是因为说话者和听话者都在不断调整:说话者学习哪种表达方式最能帮助听话者理解,听话者则学习什么时候该信任说话者、什么时候该保持怀疑。
研究团队把这个道理套用到量规生成与验证的场景中,提出了他们的框架,命名为"C2",全称是"合作且批判性的奖励建模"(Cooperative yet Critical Reward Modeling)。核心思路可以用一句话概括:训练一个"合作的量规生成器"专门生成有帮助的量规,以及一个"批判性的验证器"专门识别量规是否可信,只有被验证器认可的量规才会被采纳。
整个框架分三个步骤展开。
第一步是"合成有用和有害的量规对"。这一步的逻辑很妙:研究团队用基础模型同时充当"量规出题者"和"答案评判者"两个角色。对于训练集里的每道题,他们先让基础模型在没有量规的情况下判断两个答案哪个更好,记录下此时模型对正确答案的信心分数,这是基准线。然后,他们让基础模型生成16条候选量规,再对每条量规分别测试:加入这条量规之后,模型对正确答案的信心是升高了还是降低了?
能让模型对正确答案信心升高(即从本来就答对的情况下答得更确定,或者从答错的情况下扭转为答对)的量规,被标记为"有用量规";反之,能把模型往错误方向推的量规,被标记为"有害量规"。最终,每道题保留效果最强的一条有用量规和一条有害量规,形成"对比量规对"。这些数据完全从现有的二元偏好数据中生成,不需要任何额外的人工标注或大型专有模型。
第二步是"训练合作的量规生成器和批判性的验证器"。量规生成器用一种叫DPO(直接偏好优化)的方法来训练:把"有用量规"设为正确示范,把"有害量规"设为错误示范,模型从对比中学习,逐渐朝着生成有用量规的方向靠拢。这就像告诉一位出题老师:"这样的提示有效,那样的提示有害,你慢慢揣摩其中的规律。"
验证器则用GRPO强化学习方法训练,但面对两类任务:一类是"不带量规的判断",模型只需给出哪个答案更好;另一类是"带量规的判断",模型不仅要给出哪个答案更好,还要先判断这条量规是"有用的"还是"有害的",然后再做出最终判断。奖励信号由三部分构成:格式是否正确(有没有按要求输出分析段落和答案标签)、答案是否正确(判断结果是否与黄金标签一致)、以及量规评估是否正确(对量规好坏的判断是否与第一步标注的结果一致)。三个信号加权叠加,形成综合奖励。
第三步是"推断时的选择性跟随"。训练完成后,在实际使用时,验证器会先读入量规生成器产出的量规,然后判断:这条量规是有用的还是有害的?如果判断为有用,就依据这条量规做出最终判断;如果判断为有害,就忽略这条量规,退回到"不依赖量规"的独立判断模式。这种机制确保了哪怕量规生成器偶尔出错,验证器也能自我纠偏,而不会被劣质量规带跑偏。
**四、实验结果:数字背后的真实差距**
方法提出之后,自然要用实验来检验。研究团队在多个基准测试上进行了对比实验。
他们选用了四个评测基准,各有侧重。RewardBench覆盖聊天、安全和推理三大领域;RM-Bench特别考验模型能否抵抗文笔长度等表面特征的干扰,专注内容实质;RewardBench2是一个四选一的题目集,主要考察事实准确性和指令遵循能力;JudgeBench则测试模型能否区分事实正确与逻辑严谨的答案,横跨知识、推理、数学和代码四个领域。
作为对比基准,研究团队设置了四种方案:直接使用未经额外训练的基础模型作为下界;使用GRPO训练的推理型奖励模型(也就是没有量规、只有推理链的版本);在推理型奖励模型的基础上临时加入自生成量规;以及从更大的Qwen3-32B模型获取量规作为上界参考。
结果如下。在Tulu3-8B-SFT系列中,推理型奖励模型的四项基准平均分是55%,加入自生成量规之后反而跌到52.8%(这再次印证了劣质量规的危害),而C2框架将平均分提升到58.3%,超出推理型奖励模型3.3个百分点。在最难的RM-Bench上,C2以65.6分对64.9分,微幅领先。
在Qwen3-8B系列中,效果更加亮眼。推理型奖励模型的平均分是74.7%,而C2将其推高到78.5%,与使用Qwen3-32B生成量规的"上界方案"78.4%几乎持平。这意味着一个8B(即80亿参数)的小模型,通过C2框架,达到了需要借助参数量是自身四倍的32B模型才能达到的效果。RM-Bench上的差距尤为显著:C2达到87.8,推理型奖励模型只有81.3,足足差了6.5个百分点。
这项优势也体现在实际应用中。研究团队进一步测试了奖励模型指导下游AI训练的效果——也就是用奖励模型来筛选训练数据,再用这些数据优化语言模型的回答质量,最后在AlpacaEval 2.0和Arena-Hard两个对话质量评测上打分。结果显示,在Tulu3-8B-SFT系列中,用C2引导的下游模型在AlpacaEval 2.0的长度控制胜率(LC win rate)上达到25%,而推理型奖励模型只有19%,差距达到6个百分点;在Arena-Hard上,C2引导的模型得分26.8,推理型奖励模型是21.3,差距5.5个百分点。Qwen3-8B系列因为基础能力本就更强、输出多样性相对更低,差距稍小,但C2依然保持领先。
**五、深挖细节:C2的优势究竟从哪里来?**
数字好看固然不错,但研究团队更想弄清楚:C2的优势到底来自哪里?是因为推断时多用了计算资源,还是因为训练方式本身更高明?他们设计了一系列分析实验来回答这个问题。
第一个疑问是计算资源的问题。C2在推断时需要先生成量规、再判断量规好坏,如果判断为有害还要再走一遍"不带量规"的判断流程。总体来看,C2每道题消耗的token数(可以理解为计算量的单位)大约是推理型奖励模型的2.5倍。那么,如果给推理型奖励模型也增加同样多的计算量——比如让它对同一道题判断2.5次然后取多数票——是不是也能达到C2的效果?
实验结果给出了清晰的答案:不能。研究团队测试了N=4、8、16、32四个不同的投票次数,在每个设置下,C2都稳定领先于计算量相当的推理型奖励模型。Tulu3-8B-SFT系列中C2始终保持约2到3个百分点的优势,Qwen3-8B系列中约保持2个百分点的优势。这说明C2的收益确实来自训练方式的改进,而不仅仅是更多算力。
第二个疑问是鲁棒性问题。在实际应用中,量规生成器产出的量规质量是参差不齐的,好的坏的都有。如果推断时遇到大量低质量量规,C2还能保持优势吗?
研究团队用前面那300道题(每道题都有高质量和低质量两条量规)构造了五种不同的混合比例:高质量与低质量的比例依次设为9:1、7:3、5:5、3:7和1:9,测试三个系统——推理型奖励模型(不会拒绝量规)、去掉"选择性跟随"机制的C2、以及完整版C2——在每种条件下的准确率。
推理型奖励模型对量规极度敏感:在高质量量规占绝大多数(9:1)的情况下,Tulu3-8B-SFT版本的准确率约53%;一旦低质量量规成为主流(1:9),准确率跌至39%。同等条件下,Qwen3-8B版本从73%跌至52%。反观完整版C2,同样的范围内,Tulu3-8B-SFT只从51%跌到46%,Qwen3-8B只从76%跌到70%,下降幅度远小得多。而且随着低质量量规比例增加,"选择性跟随"机制带来的收益越来越大,说明这个机制确实在发挥作用。当然也有一个小瑕疵:在高质量量规几乎全是优质的极端情况(9:1)下,Tulu3-8B-SFT版本的C2略低于推理型奖励模型,说明较弱的模型有时会错误地拒绝有用量规。
第三个疑问是量规生成器本身的训练是否有效。研究团队从RM-Bench的难题子集中取200道题,分别让基础模型、C2量规生成器(经过DPO训练后的版本),以及家族内更大的模型(Tulu3-70B和Qwen3-32B)各生成一批量规,再由GPT-5打分。结果显示,经过DPO训练之后,量规质量分布明显向高分段移动:低质量量规(1到2分)比例下降,高质量量规(4到5分)比例上升,平均分从Tulu3-8B的2.11提升到2.66,从Qwen3-8B的3.15提升到3.52。而更大模型的参考均分分别是2.85和3.62——也就是说,经过C2训练的8B小模型,量规质量已经接近参数量是自身数倍的大模型。
第四个疑问是框架中各组件各自贡献了多少。研究团队做了消融实验,分别测试去掉"合作量规生成器"(用未经DPO训练的基础模型代替)、去掉"批判性验证器"(用没有量规质量评估能力的推理型奖励模型代替)、以及去掉"负面量规训练信号"(只用正面量规训练,不引入有害量规对比)三种变体的效果。
结论很明确:三个组件都有贡献,缺一不可,但最关键的是"负面量规"的对比训练。去掉有害量规的训练信号,模型性能下降最多。这说明让模型"学会什么不该做",与"学会什么该做"同样重要,甚至更加关键。在另外两个组件之间,批判性验证器的贡献略大于合作量规生成器——也就是说,在关键时刻能拒绝劣质量规,比把量规生成得更好更重要。
**六、用显微镜看量规质量的变化**
为了更直观地理解量规质量的改变,研究团队还做了一次细致的"错误分析"。他们从RM-Bench中随机取80道题,分别用基础模型和C2量规生成器生成量规,然后由人工标注员在不知道哪条量规来自哪个模型的条件下,对每条量规进行分类标注。标注类别包括以下几类问题:遗漏了重要约束条件、包含了与题目无关的评判标准、内部标准相互矛盾、太过模糊缺乏可操作性,以及超出题目范围过度苛刻。
基础模型生成的80条量规中,完全没有问题的只有28条,占35%;其中最常见的问题是标准过于模糊(33.8%)和包含无关标准(26.3%)。经过C2的DPO训练之后,无错误量规的比例从35%提升到52.5%,提升了约50%;模糊问题从33.8%骤降至5%,无关标准从26.3%降至12.5%,关键约束遗漏从21.3%降至10%。美中不足的是,过度苛刻的比例从12.5%微升至18.8%——这大概是因为模型在努力让量规更具区分性的过程中,有时候会矫枉过正,加入了一些超出题目原意的额外要求。总体来看,这个副作用代价不大,整体质量提升是显而易见的。
研究团队还在附录中提供了一些量规样例,让人对质量差异有直观感受。比如一道题要求"不借助额外数据结构找出两个数组的公共元素",高质量量规会精准抓住"不能使用列表、集合、字典等数据结构存储中间结果"这个核心约束,而低质量量规则会含糊地说"结果列表是必要的所以用列表可能是可以接受的",直接造成标准自相矛盾。再比如一道空间推理题——"我把盘子放在苹果上,然后把盘子从厨房拿到餐厅,苹果在哪里"——高质量量规正确推断苹果留在了厨房;低质量量规则错误地描述了物理关系,说苹果被藏在盘子下面,并把"安全性"这个标准牵强地应用到物体位置上,完全跑偏了。
**七、研究的边界与未来空间**
任何方法都有局限,研究团队也坦诚地指出了C2的两个主要限制。
第一个限制是对基础模型能力的依赖。C2的批判性验证器需要有足够强的推理能力,才能可靠地判断一条量规是有用还是有害。从实验结果也能看出,在"几乎全是高质量量规"的极端情况下,能力较弱的Tulu3-8B-SFT版本会过度拒绝有用量规,说明弱模型的判断力还不够稳健。
第二个限制是推断时的额外开销。C2需要先生成量规、再判断、如有必要再进行一次不带量规的判断,整体延迟约是推理型奖励模型的2.3到2.4倍(在单块A100 GPU上,每道题的平均判断时间从约1500到2000毫秒,增加到约3600到4800毫秒)。对于资源受限的场景,这个额外消耗不可忽视。研究团队认为,未来可以通过更高效的量规生成方式或更智能的"是否需要量规"判断机制来缓解这一问题。
此外,研究团队还做了一些额外的下游实验。他们用Qwen3-8B进行了"Best-of-N选择"实验——即从N个候选答案中选出最佳答案。在GPQA-Diamond(一个需要博士级别知识的推理测试)上,N=16时C2比推理型奖励模型高3.1个百分点;在MATH500上高2.4个百分点;在IFEval严格指令遵循测试上高1.7个百分点。他们还测试了拒绝采样微调(用奖励模型筛选最优回答来微调模型),C2在AlpacaEval 2.0上比推理型奖励模型高2个百分点,在Arena-Hard上高2.2个百分点。这些结果表明,C2的优势并不局限于某种特定的使用方式,而是具有广泛的适用性。
归根结底,这项研究解决的是一个很实际的问题:在AI训练中,仅凭简单的"好/坏"标注数据,能不能训练出既有明确评判标准、又能识别评判标准是否靠谱的奖励模型?C2给出了一个相当令人信服的肯定答案。它的核心智慧在于,与其费力生成完美的量规,不如同时训练模型学会什么样的量规有害——毕竟,学会不犯错,有时候和学会做对事情一样重要。
这对普通用户意味着什么?每次你与某款AI助手交流,背后都可能有奖励模型在默默评估AI回答的质量。奖励模型越准确,AI就越能持续给出有用、真实、符合要求的回答,而不是用华丽的文字包装空洞的内容。C2框架让这个"幕后裁判"变得更可靠,间接提升了你每次与AI互动的体验质量。
对于想要深入了解这项研究的读者,可以通过arXiv编号2604.13618查阅完整论文,标题为"C2: Scalable Rubric-Augmented Reward Modeling from Binary Preferences",发表于2026年4月。
Q&A
Q1:C2框架中的"量规"是什么,为什么它对AI训练很重要?
A:量规(rubric)是一份评分清单,把"这个回答好不好"这个模糊问题,拆解成一系列具体的是非题,比如"语气是否礼貌?""是否提供了实质性帮助?"有了量规,AI的奖励模型在打分时就有明确依据,而不是凭"感觉"。实验数据表明,高质量量规能让奖励模型准确率提升8到14个百分点,但低质量量规会产生反效果,让准确率跌到比不用量规还低的水平。所以量规质量本身就是个关键问题。
Q2:C2框架为什么不需要人工标注量规就能工作?
A:C2用了一个巧妙的自举机制:让基础模型既当"出题者"又当"阅卷者"。对每道题生成16条候选量规,同时测试每条量规是让模型往正确方向走还是往错误方向走。能引导模型答对的量规被标记为有用,会把模型带偏的被标记为有害,形成对比数据对。整个过程只依赖现成的"A比B好"二元偏好数据,不需要人工写量规或调用专有大模型,大幅降低了成本和门槛。
Q3:C2框架和普通奖励模型相比,实际效果差多少?
A:在RM-Bench这个专门考察奖励模型能否看穿文笔陷阱、抓住内容实质的测试集上,Qwen3-8B版本的C2达到87.8分,而普通推理型奖励模型只有81.3分,差了6.5个百分点。更值得关注的是,8B参数的C2框架在多个基准上的综合表现,与使用参数量是自身四倍的32B模型生成量规的方案相当。在实际AI训练应用中,用C2引导的语言模型在对话质量评测上比用普通奖励模型引导的版本高出约2到6个百分点。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
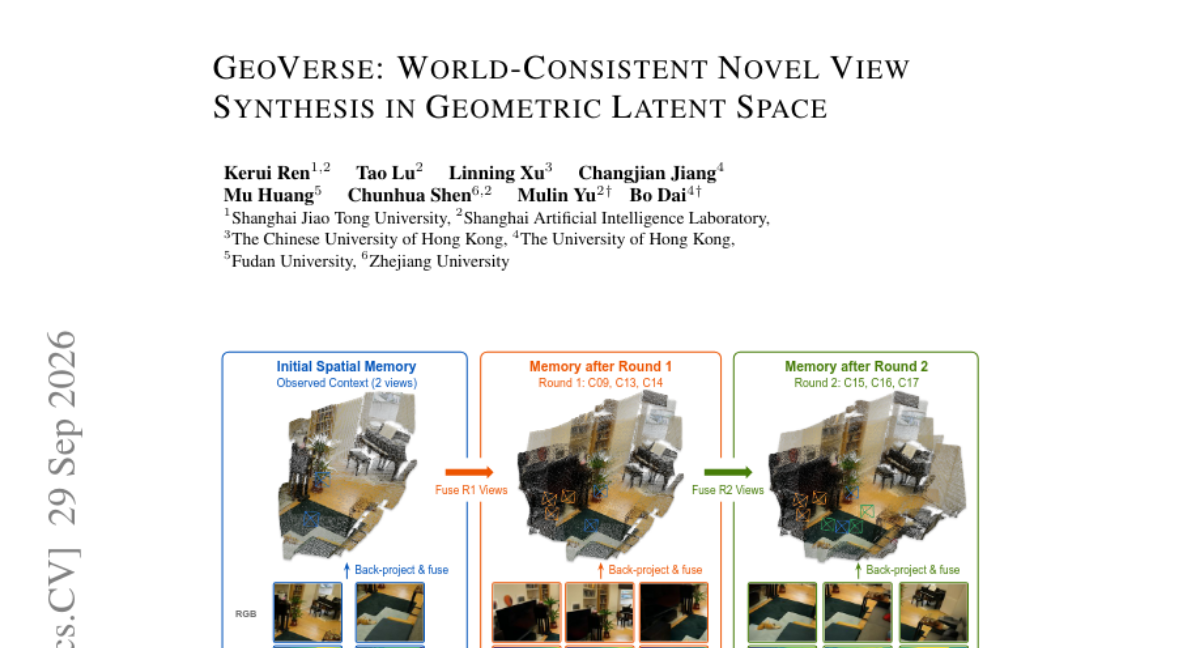
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





