

 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

生成一个3D手办要等25秒,你会不会不耐烦?


2025年那会儿,如果你想用AI生成一个3D模型,得先做好等待的心理准备。
市面上比较靠谱的方案之一,Roblox团队发布的Cube模型,靠着一种叫自回归的方式逐个吐出形状编码,最终拼成一个完整的3D网格。这个过程严谨,但是慢。慢到什么程度呢?生成一个物体平均要花25.71秒。你点了生成键,去接了杯水回来,进度条可能才走到一半。
**这篇论文要解决的,就是这个"慢"字。**
浙江大学ZIP实验室联合Monash大学、阿德莱德大学的研究者们提出了一个叫Block3D的新方法,把生成时间从25.71秒压到了4.99秒,快了5.15倍,而且生成质量不降反升。这事儿听起来简单,做起来却牵扯到一整套精妙的设计。我们慢慢拆开看。
先说说为什么3D生成这么慢。
生成一个3D物体,本质上是让AI预测一长串"形状编码",也就是描述这个物体几何形状的数字序列。Cube模型把每个网格表示成1024个离散编码,这1024个数字必须被正确地填出来,模型才能把它们解码成看得见摸得着的三维形状。
目前主流有两条路。
**第一条路是自回归,一个接一个地生成编码,前一个生成完了才能生成下一个。**
这就好比你在餐厅点菜,服务员必须记完你第一道菜的要求,才能开始记第二道,不能同时处理。问题是,一旦某道菜记错了,前面已经写在单子上的字没法擦掉重写,只能将错就错地往后传。1024个编码,就是1024次不可逆的决定,错误会一路累积到最后。这条路慢,还没法反悔。
第二条路是扩散或者流匹配模型,一次性把整个序列都拿出来反复打磨,每一轮都要把全部1024个编码重新算一遍。
想象你在临摹一整幅画,扩散模型的做法是每一笔都要把整张画布重新看一遍再落笔,而不是画完一个角落就往下一个角落走。这样做的好处是可以随时纠正错误,因为没有什么部分是提前锁死的。坏处也很明显:画布越大,每一轮的成本就越高,细节越丰富,需要打磨的轮数也越多。
自回归的问题是"不能改错",扩散的问题是"改错太贵"。Block3D想要的,是一个中间地带:既能局部反悔,又不用每次都从头算一遍。
把长队伍切成小方阵
Block3D的第一个核心思路,是把这条1024个编码组成的长队伍,切成一段一段的连续区块,学术上叫做
**块(block)**:把长序列切分成若干个连续的小段,每段包含固定数量的编码,比如64个一组。
区块和区块之间,还是按照从左到右的顺序生成,前面的区块生成完了才轮到后面的区块,这部分保留了自回归的因果关系。但是在一个区块内部,所有的编码是同时被处理的,用的是双向注意力,也就是区块里任何一个位置都能看到同一个区块里其他所有位置的信息。
这就像是把原本一个人排队一个个填表格,改成了分批叫号。每批比如64个人,一起进入一个房间填表,房间里大家可以互相参考,填完这一批人的表格,这批人就锁定离场,不能再回来改了,然后下一批人进场。
如果批次大小设成1,那就退化成了纯自回归,一个一个来,没有并行的好处。如果批次大小设成1024,那就是整个序列一起处理,退化成了纯扩散,又变成每次要处理全部内容的老问题。Block3D选了一个中间值,实验里用的是64。这个数字不是拍脑袋定的,论文专门做了对比实验,我们后面会看数据。
区块内部具体怎么"同时处理"呢?这里用到了一个叫
**M2T和T2T**:M2T全称是mask-to-token,就是把一个还没确定的空白位置填上具体编码;T2T全称是token-to-token,是把一个已经填过的位置重新审视一遍,如果发现填得不对,就换成更靠谱的候选。这两个操作机制来自另一篇论文LLaDA2.1。
的编辑机制。一个区块刚开始进入生成阶段的时候,所有位置都是空白的掩码状态,模型先给每个位置一个初步猜测和对应的置信度分数,置信度足够高的猜测会被立刻采纳填进去,这是M2T在起作用。
猜错了还能改,这才是关键
光靠M2T还不够。因为模型第一轮给出的猜测未必都靠谱,有些位置可能填错了但当时置信度算得比较高,蒙混过关了。如果没有纠错机制,这些错误会被锁死在区块里,跟着往后传。
**T2T机制的存在,就是给这些已经填过的位置一次"回头看"的机会。**
它不会瞎改,只有当新的候选编码和当前已填的编码不同,而且新候选的置信度超过某个阈值,才会执行替换。论文里这个阈值设的是0.9,比M2T用的0.95的阈值要宽松一点,这个细节值得琢磨:模型对"要不要接受一个新填的空白"更谨慎,对"要不要纠正一个已经填了但可能错的位置"反而给了更多机会去修正。
这套修正机制不是无限次进行的。论文设计了一个叫
**去噪步数T**:完成一个区块最多允许迭代打磨的次数,论文实验里默认设为4。
的硬性上限,还配了一个**确定性配额**,保证哪怕模型一直不太自信,每一轮迭代也必须至少填上一定数量的空白位置,这样一来,无论如何,一个区块保证能在T轮之内彻底填满,不会无限拖延下去。
这个设计像什么呢?
想象你在批改一叠试卷,规定自己最多改4遍。第一遍先把有把握的题目打好分,第二遍回头看看有没有算错的地方顺手改一改,但整个批改过程有个硬性截止时间,不管多纠结,第4遍必须交卷。如果没有这个硬性上限,你可能会在某几道模糊的题目上反复纠结,改到天荒地老都不放手,那生成速度就无从谈起了。这个"确定性配额"保证的,就是不管模型多犹豫,进度条也得往前走。
如果去掉T2T这个纠错环节会怎样?论文专门做了对照实验,只用M2T不带T2T的版本,几何指标里的F@1%(一种衡量生成形状和目标形状贴合程度的分数,越高越好)从0.309掉到了0.287,倒退了7%左右。这说明单靠"填空白"是不够的,"回头改错"这一步是实打实带来了收益的。
训练时怎么让模型学会"改错"
这里有个挺微妙的问题:如果只用真实数据训练模型去纠正编码,模型在推理阶段面对的其实是自己之前生成出来的、可能带有错误的编码,训练和推理用的素材不一样,模型很可能学不会真正需要的能力。
论文设计了一个叫
**残差目标(Residual Objective)**:训练时只针对那些和真实答案不一样的位置计算损失,而不是对所有位置都算,这样能让模型专注在真正需要学习纠错的地方。
的巧妙训练方式,具体做法是先故意把训练数据"弄脏",一部分位置换成掩码符号,一部分位置随机换成错误的编码,这个比例是从45%到95%之间随机采样的,然后让模型先跑一遍前向推理,把这个"脏"数据尝试填一遍,生成一个带有模型自己产生的错误的候选序列,接着才用这个候选序列去计算真正的训练损失,而且损失只计算那些和真实答案不一致的位置。
这就好比教一个学生批改作文,与其只给他看干净的范文让他背,不如先让他自己写一篇有错别字的草稿,然后专门盯着这些错别字讲解怎么改。这样训练出来的批改能力,才是真正对付实战场景里那些"自己犯的错"有用的能力,而不是纸上谈兵。
论文管这套流程叫"编辑感知训练"(Edit-Aware Training),核心就是让模型在训练阶段就见识过带有自己风格错误的候选答案,推理时才不会两眼一抹黑。
数据说话:到底快了多少,好了多少
理论讲完了,实打实的数字才是硬道理。研究团队在TRELLIS-500K这个大规模3D资产数据集里随机挑了100个没有参与训练的物体作为考卷,让Block3D和另外四个方法(ShapeLLM-Omni、TRELLIS-text、AR3D-R1,以及最关键的对照组Cube)分别生成,然后用几个指标打分。
几何精度方面,用的是倒角距离(衡量生成表面和真实表面的贴合程度,数值越小越好)、法线一致性(衡量表面朝向是否吻合,越高越好)和F分数(结合精度和召回率的综合指标,越高越好)。结果Block3D在这三项上全部拿了第一,倒角距离0.078,比Cube的0.094更低;F分数0.309,比Cube的0.219要高出不少。文本匹配度上Block3D的CLIP分数是23.24,略低于Cube的23.87,但差距很小,属于同一档次。
速度方面才是真正的重头戏。Block3D平均生成时间4.99秒,Cube是25.71秒,足足快了5.15倍。而且不只是平均值好看,中位数、90分位数这些统计量全部都优秀,标准差也小到0.43秒,说明这个速度优势是稳定的,不是偶尔碰上几个简单案例撞出来的运气。
论文还专门做了参数敏感性的实验。区块大小从32一路试到256,发现区块越大,速度越快(256时只要2.15秒),但质量代价很明显,F分数掉到0.103,惨不忍睹。综合权衡下来,64是速度和质量的平衡点。去噪步数从4试到20,发现步数增加并不能带来稳定的质量提升,反而白白拖慢速度,4步就够了。
这套方法站在谁的肩膀上
Block3D不是凭空冒出来的,它站在了几篇关键论文的肩膀上。区块化的因果生成结构,借鉴自一篇叫Block Diffusion的论文,这篇论文本来是给文本生成设计的方案,Block3D把它搬到了3D形状编码这个全新的场景里。M2T和T2T这套编辑机制,则是来自LLaDA2.1这篇更晚近的工作。而作为整个方法基石的离散形状编码和解码器,直接沿用了Cube这个模型的冻结组件,也就是说Block3D并没有重新造轮子去设计3D表示方法,而是把注意力全部放在"怎么更快更好地生成这些编码"这个问题上。
这种"整合而非重造"的思路本身也值得说一说。研究者没有从零开始造一个全新的3D表示体系,而是选择站在已有的、被验证过的组件之上,只对生成过程的效率和纠错能力动刀子。这种做法风险更低,也更容易看清楚哪部分改进真正起了作用。
不过论文也很坦诚地承认了局限。一旦一个区块被"锁定",后面的区块就再也没法回头修正它了。这意味着如果错误发生在跨区块的层面,比如前面几个区块已经把物体的整体比例定歪了,后面的区块再怎么努力也无力回天。论文管这个叫"曝光偏差"(exposure bias),承认Block3D并没有彻底解决这个问题,只是把纠错的粒度从"每个编码"放大到了"每个区块",给了更大的容错空间,但没有做到完全没有偏差。
Q&A
Q1:Block3D是什么?
A:Block3D是浙江大学等机构提出的一种文本生成3D模型的方法,通过把形状编码切分成小区块并行去噪,同时引入置信度引导的纠错机制,在保持几何质量的前提下大幅提升生成速度。
Q2:Block3D比原来的方法快多少?
A:在100个测试物体上,Block3D平均生成时间为4.99秒,相比对照基准Cube模型的25.71秒,实现了5.15倍的速度提升,同时几何精度指标还有所提高。
Q3:Block3D的区块大小和去噪步数怎么选最合适?
A:论文实验表明区块大小64、去噪步数4是速度与质量的平衡点,区块过大(如256)会让F分数从0.309骤降到0.103,步数增加到20也不会带来稳定的质量提升。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章
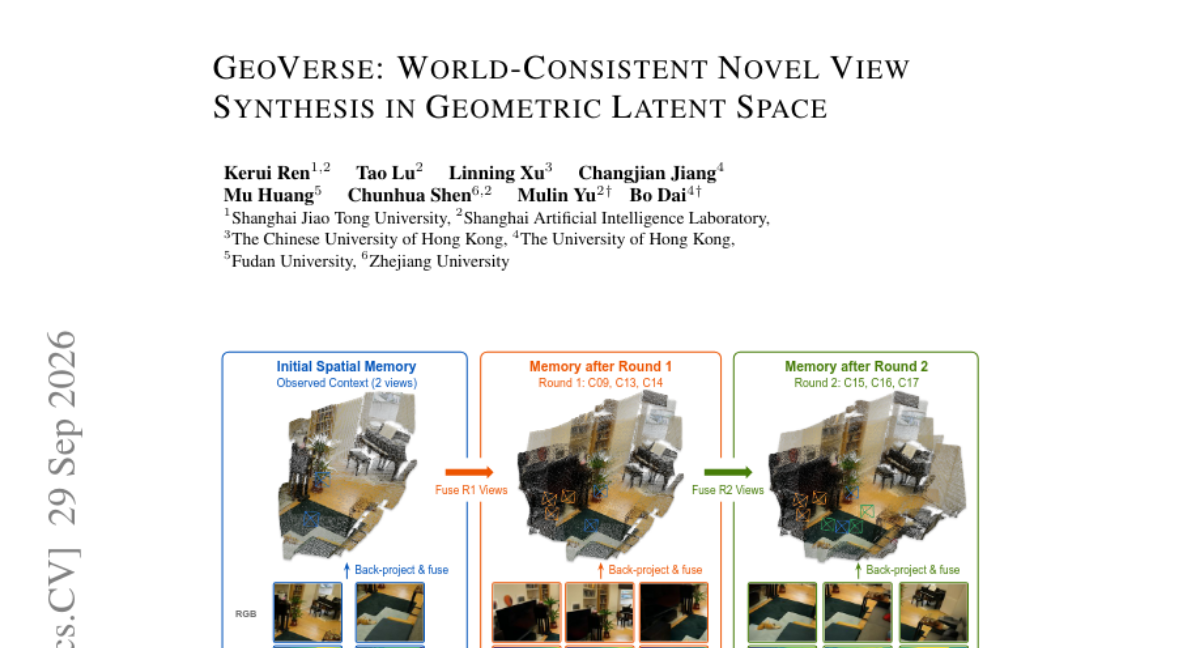
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





