

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

AI能不能自己教自己?RISE让模型用昨天的自己训练今天的自己


先说一件挺反直觉的事。
现在训练大语言模型做数学题、写代码,主流做法是让模型自己生成一堆答案,做对了就奖励,做错了就惩罚。这个方法叫RLVR
**RLVR(可验证奖励强化学习):通过检查答案对不对来给模型打分,然后用这个分数调整模型参数的训练方法**
听起来很合理,但这里藏着一个巨大的浪费。假设模型写了一段800字的解题过程,最后答案错了,于是这整段800字全部被判定为"不好",不管其中有没有正确的推理步骤。这就像老师批改一篇作文,只看最后一句话对不对,前面999个字不管写得多精彩,只要结尾错了就全篇打零分。这种打分方式漏掉了大量信息,模型根本不知道自己是哪一步开始走偏的。
于是研究者们想到了另一条路:让一个更聪明的"老师"模型逐字逐句地告诉学生模型每个词该怎么写,这叫做On-policy Distillation,简称OPD
**OPD(在线策略蒸馏):教师模型在每一个字的位置都给出一个完整的概率分布,告诉学生模型这个词选得好不好、还有哪些词也可以选,比单纯的对错反馈信息量大得多**
这个思路听起来很美好,但问题来了:这个"老师"从哪儿来?
如果用一个更大、更强的外部模型当老师,学生练习久了之后走的路会越来越野,老师看着学生这些"野路子"的解题过程,反而给不出靠谱的建议,这是因为外部老师从来没在这些新奇路径上"练过手"。如果让模型自己当自己的老师,给自己看一眼正确答案再重新生成一遍作为参照,这个办法也有毛病:很多模型的"举一反三"能力(也就是在提示里塞进正确答案后能不能真正利用好这个信息)本身就不够强,给了提示也不一定能用好。
这篇论文的作者,来自Salesforce AI Research的团队,决定换一个思路来回答这个问题:教师到底应该是谁?
他们的答案挺巧妙的:既然谁都当不好老师,那就让模型的"未来自己"当老师。
具体来说是这样的。假设模型现在是θn这个状态,经过一轮RLVR训练之后变成了θ'n+1,这个过程本身已经证明了往这个方向走是有效的(毕竟通过了正确答案的验证)。既然这个方向是对的,那为什么不多走一步?把这段位移再放大一点点,投射到一个"更未来"的位置上,用这个虚构出来的、更强的未来版本模型来当老师,反过来教现在的模型。
这就是RISE的核心想法:Recursive Improvement via Self-Extrapolating Policy Distillation
**RISE:通过外推模型自身的强化学习训练轨迹来构造一个"合成教师",不需要任何外部模型,也不需要给模型看正确答案作为提示**
这个想法有点像一个人在健身。你今天举了50公斤,比昨天多了2公斤,如果你相信这个进步趋势是真实的(因为是靠扎实的训练达到的,不是偶然一次超常发挥),你完全可以在心里给自己定一个更高的短期目标,比如"下周我应该能举到54公斤",然后按照这个目标去调整动作和呼吸节奏。如果不这么想,你可能只会满足于50公斤这个已经达到的成绩,进步速度会慢很多。但如果你把这个目标定得太离谱,比如直接想象自己能举100公斤然后强行按那个姿势练,那大概率是要拉伤肌肉的。RISE要解决的正是"外推多远才安全"这个问题。
数学上,这个外推写成一个很简单的公式:新的教师状态等于当前状态加上一个放大系数乘以位移量,这个放大系数用希腊字母β表示,β大于1的时候就是往前多看了一步。
这里有两种做法。一种是在参数空间里直接外推,也就是把模型的权重本身按照这个公式做加减法,这在模型合并领域有个专门名字叫task arithmetic
**task arithmetic(任务算术):把不同微调阶段模型的参数进行加减运算,来实现知识的组合或强化,这个技术最早在模型融合的研究里被提出**
另一种做法是在logit空间里外推,也就是不动模型权重,只对模型输出的每个词的概率取对数之后做加减法。这两种做法在数学上等价于对同一个非线性函数做零阶和一阶泰勒展开,实际效果会有所不同,论文里两种都做了实验。
为什么这种外推是可行的,而不是异想天开?作者们引用了最近几年模型训练动力学方面的研究发现:强化学习训练过程中,参数的更新方向其实高度集中在一个很小的子空间里,而且这个子空间里的变化趋势接近线性。作者自己也做了验证,对Qwen3-1.7B和Qwen3-8B两个不同规模模型的训练轨迹做主成分分析,发现仅仅三个主成分方向就能解释86.6%到88.5%的方差,两个规模相差5倍的模型,这个数字差异不到0.1%。这说明这不是某个模型的偶然特性,而是训练过程本身固有的结构。
这就好比高速公路上的车流,虽然每辆车走的具体路径细节各不相同,但整体车流方向是高度一致的,你站在高处俯瞰,能用一条箭头基本概括所有车的运动趋势。如果车流真的杂乱无章,各走各的方向,那外推预测下一秒的车流位置就没有任何意义,但恰恰因为车流呈现出主导方向,你才能大胆地往前预判。
不过外推这件事光靠这个"教师"是不够的,还得配合一套"消化吸收"的机制,也就是蒸馏这一步。
为什么不能直接把外推出来的"未来版本"模型当成下一步的正式模型直接拿来用?论文做了对照实验回答了这个问题。他们尝试跳过蒸馏这一步,直接把外推出来的参数θfuture当作下一轮的模型,结果发现整体数学平均分几乎没有提升,在Qwen3-8B上从60.0只涨到60.3,在Qwen3-1.7B上从45.4涨到45.6,这个提升幅度和随机波动差不多,等于没有真正学到东西。
这说明外推这一步走得太快太猛,直接采纳的话相当于让模型"抢跑"到一个自己还没真正验证过的状态,虽然方向大体正确,但具体走到哪个点上是有噪声的,直接拿来用风险很大。蒸馏这一步的作用就是把这个有点冒进的"未来目标"当作参照,让模型通过正常的梯度下降一步步靠近它,而不是一步跳过去。这就像跑步教练给你定了一个进阶目标配速,但不是让你直接按那个配速冲刺,而是每天训练时以这个目标为参照微调你的节奏,让你的身体慢慢适应,真正把能力提上去,而不是靠着一时的肾上腺素冲一次就受伤。
那么完全不做强化学习训练,只靠自我蒸馏的位移方向来外推,会发生什么?论文里专门做了这个实验,结果相当惊悚:训练进行到60步左右直接崩溃,数学测试准确率从基础水平暴跌到2.4%,模型生成的回答长度从2000个词暴涨到8000个词的上限(也就是说模型开始不停地啰嗦,永远说不完),训练奖励也跌到零。
这个现象背后的原理是这样的:没有强化学习的验证信号来"锚定"方向,纯粹靠自我蒸馏产生的位移完全是自我参照的,模型这一步往哪个方向走,纯粹取决于它上一步走了哪个方向,跟对错完全无关。这就好比一个人对着镜子里的自己不断模仿放大自己刚才的动作,如果一开始的动作有一点点偏差,镜子里的"自己"会把这个偏差放大,然后真实的自己又去模仿这个被放大的偏差,如此循环几轮之后,动作会完全失控,而如果镜子外面有一个真实的教练在旁边纠正,告诉你"这个动作对,那个动作错",这种失控就不会发生。RLVR在这里扮演的正是这个教练的角色。
所以RISE整体是这样运作的:先做一轮正常的RLVR训练,用对错来更新模型;然后用更新前后两个状态的差异构造一个外推出来的"未来教师";再用这个教师的逐字概率分布来蒸馏当前模型,让每个字的决策都往更精细的方向调整。整个循环里,RLVR负责把握大方向不走偏,蒸馏负责把每个字的细节打磨到位。
论文还发现,外推的安全范围会随着训练推进不断收窄。他们直接拿训练中途保存的检查点做实验,测试不同β值下外推能带来多大提升。结果发现在训练早期(第50步),哪怕β设到2.0这么激进,也能带来7.3分的提升;但到了第100步,同样的β=2.0直接导致准确率暴跌15分;到了第200步,哪怕只是β=1.5也要付出7.7分的代价。
这个规律很好理解。模型刚开始训练的时候离最优解还很远,往前多看几步基本都是在正确方向上,出错的代价不大;但随着训练接近收敛,模型已经离最优解很近了,这时候再用大步幅外推,很容易一步就冲过了终点,反而把已经调好的状态又搞乱了。这就跟开车进车库一样,刚开始车离车库还远的时候,方向盘打得猛一点没关系,反正还有大量空间可以调整;但快要停进车位的最后几十厘米,你要是还按照刚才那个打方向盘的力度来,八成会撞墙。RISE给β设置了一个从大到小递减的时间表,训练前期激进一些,后期逐渐收敛到1(也就是不再外推),正是为了应对这个安全区间不断收窄的问题。
论文的实验覆盖了数学推理、多学科理科(STEM)、代码生成和多轮智能体任务四大类,模型规模从1.7B到8B参数不等,涵盖了Qwen3、OLMo3、Qwen2.5等不同架构。
结果相当一致:RISE在几乎所有场景下都超过了纯粹的RLVR训练,也超过了那些依赖"给模型看正确答案提示"的自我蒸馏方法。最典型的例子是OLMo3-7B在AIME'24这个竞赛级数学题上,从基础RLVR训练的30.2分直接提升到46.9分,涨了16.7个百分点。这不是小打小闹的提升,而是接近翻倍的跃升。
论文里还有一个细节值得单独说一说。研究者担心RISE会不会只是让模型在已经会做的题目上更加"死记硬背",而不是真正拓宽了解题能力的边界。他们专门对比了avg@16(16次尝试的平均正确率)和pass@16(16次尝试里只要有一次做对就算成功)这两个指标。如果只是死记硬背,pass@16应该没什么提升;但实际结果是,RISE在1.7B模型上把AIME'24的pass@16提升了9.6个百分点,比avg@16的6.3个百分点还高。这说明RISE真的扩大了模型能解决的问题范围,而不是简单地在原有能力上抹了层油光。
代价方面,RISE因为多了一轮蒸馂训练,会带来一些额外的计算开销。在8B模型上大概是GRPO(也就是最常用的RLVR算法)训练时间的1.6倍,在1.7B模型上是1.3倍。考虑到不需要额外采样、不需要外部大模型,这个开销总体上是可以接受的。
写在后面
读完这篇论文,最让我意外的一个点是"教师非静止"这个设计。之前看到的很多蒸馏方法,无论是用外部大模型还是用privileged conditioning的自我蒸馏,教师都是固定住的,一旦确定了教师的水平,学生能达到的上限也就基本锁死了。RISE把这个假设直接打破了:教师是随着学生每一轮训练不断刷新的,学生进步一点,教师立刻也跟着往前挪一点。这意味着蒸馏不再是一次性的"压缩"过程,而是一个真正意义上的循环迭代系统。
另一个让我反复琢磨的地方是论文里那张主成分分析的图。三个方向就能解释近九成的方差,这个数字本身说明了一个更普遍的事情:大模型的训练轨迹远没有参数数量那么复杂,绝大部分的"学习"其实发生在一个极其狭窄的通道里。如果这个规律在更多任务、更多模型规模上都成立,那也许我们对"训练"这件事的理解还停留在表面,真正决定模型走向的可能只是那几个主导方向,剩下的绝大多数参数维度只是在"陪跑"。
论文最后也坦白了一个局限:如果奖励信号本身是可以被"钻空子"的(reward hacking),外推反而会把这个漏洞放大,因为外推的本质就是把已经发生的位移趋势再夸大一遍。这让我想到一个问题:当我们让AI学着放大自己过去的进步趋势时,我们有没有办法提前判断,这个"进步"到底是真的变聪明了,还是只是找到了一个新的作弊漏洞?这个问题这篇论文没有回答,可能也是接下来最值得追问的方向。
Q&A
Q1:RISE是什么?
A:RISE是Salesforce AI Research提出的一种大语言模型训练方法,它通过外推模型自身强化学习训练轨迹(在参数空间或输出概率空间中),构造出一个"未来版本"的合成教师,再用这个教师逐字蒸馏当前模型,不需要任何外部模型或正确答案提示。
Q2:RISE和普通的强化学习训练比有什么优势?
A:普通RLVR只给整段回答一个对错分数,无法区分具体哪个词写得好或不好。RISE额外提供逐字级别的密集监督信号,实验显示在数学推理、代码生成、多轮智能体任务上都显著超过纯RLVR,例如OLMo3-7B在AIME'24上准确率从30.2%提升到46.9%。
Q3:RISE的外推系数β该怎么设置?
A:论文发现外推的安全范围会随训练推进不断收窄,训练早期可以用较大的β(如1.2到1.5),后期需要逐渐衰减到1,否则容易导致教师质量崩溃。作者建议使用随训练步数线性或余弦衰减的调度策略。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案
论文提出动态民主同意框架,融合伯奈斯公关理论与系统动力学反馈模型,分析政治支持率如何受滚雪球增长、选民饱和、感知延迟和制度信任侵蚀四种机制影响,揭示宣传投放为何会失效甚至反噬。
让AI开一年网店,结果它把自己搞破产了
阿里巴巴团队推出E-Commerce Bench基准,让18个顶尖AI模型经营虚拟网店一年,揭示AI在长周期自主商业决策、供应商谈判防骗、现金流管理及经验学习方面存在巨大能力差异与隐藏短板。
雷达和光学,两张脸拍同一片地
本文解读ReFlowSET框架,它通过系统评测多款图像压缩器选出最适合雷达与光学图像的编解码器,并从零训练轻量生成模型完成雷达图到光学图的翻译,在多个数据集上取得领先的感知与分布质量表现。
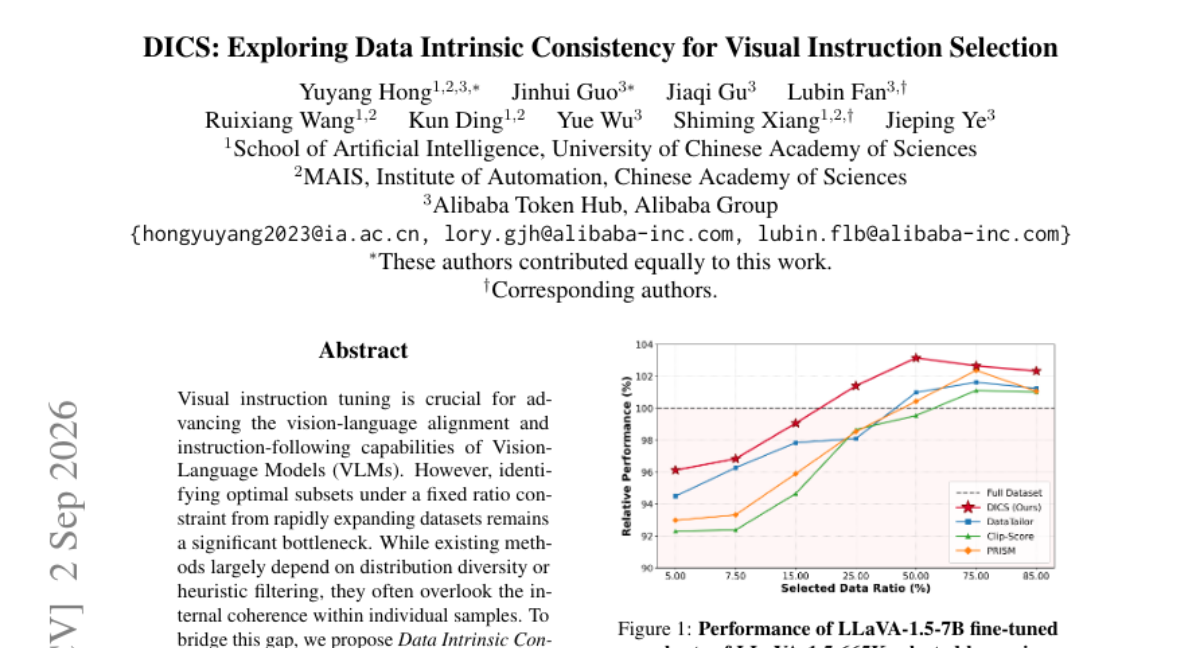
DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据
阿里团队提出DICS方法,通过评估图片、问题、答案三者的内在一致性给训练数据打分,结合自适应采样策略筛选高质量子集。仅用25%的LLaVA-1.5-665K数据训练即超越全量数据效果,并在600万样本规模验证下用不到四分之一数据逼近官方InternVL3-8B性能。
政治人物砸重金投广告,为什么支持率还是会突然崩盘?一个系统动力学模型给出了答案
让AI开一年网店,结果它把自己搞破产了
雷达和光学,两张脸拍同一片地
DICS:给AI训练数据做一次“体检”,用四分之一的数据打赢全量数据





