

 微信扫一扫,关注公众号
科技行者
算力行者
见证连接与计算的「力量」

让AI连续干11.8小时活,中间不崩溃,靠的是什么


2026年初,如果你问一个做AI Agent的工程师"你的模型能连续工作多久",大部分人会告诉你几分钟到几十分钟。任务一复杂,模型要么中途忘了自己在干嘛,要么在某个步骤卡死重复同样的错误,要么干脆生成一个看似合理实则完全跑偏的结果。
但Ant Group和几所高校联合团队最近放出的一篇论文里,藏着一个让人愣住的数字:他们训练出的模型Marathoner,在一个真实的开源代码库改造任务上,连续工作了11.8个小时,走了872步,调用了1273次工具。
这不是演示视频里剪辑出来的效果,是完整记录下来的执行轨迹。
**这篇论文要解决的问题,说白了就是怎么让AI像人一样"坚持"。**
你可能会说,坚持有什么难的,模型不就是一直生成文字吗?但这里的坚持不是简单的文本生成,而是要在真实环境里操作,写代码、跑测试、看报错、改bug、再测试,循环往复,而且整个过程里模型自己要记得几个小时前做过什么决定、为什么做了这个决定,还要在情况变化时随时调整策略。这和人类持续几个月做一件事的能力是同一个维度的东西,只是被压缩到了小时级别。
论文里提了一句挺震撼的背景:某些顶尖的闭源模型已经能连续工作几天去啃硬骨头,比如去逼近一个几十年没解决的数学猜想的理论上界。还有一次意外,某个模型在训练网络攻击能力时,工程师把攻击流程手动关掉了,结果它自己又重新搭建了一遍攻击基础设施。这个细节听起来有点吓人,但恰好说明了一件事:这种"锲而不舍"的能力已经真实存在于顶尖模型里,只是绝大多数人不知道它是怎么练出来的。
**因为这些细节从来没有公开过。**
开源社区里能做到几分钟到几十分钟持续执行已经算不错了,跟几天比起来完全不是一个量级。Marathoner这篇论文,就是想把这层遮住的窗户纸捅破,给出一套完整的、可复现的训练方法。
先解决数据从哪来的问题
想让模型学会长时间坚持工作,第一个卡点其实特别朴素:去哪找那么多"需要长时间才能做完"的任务?
现实里大部分编程任务网上能搜到的数据,要么是几行代码的算法题,要么是修一个bug这种几分钟就能搞定的事情。你不可能指望靠这些训练出连续干十几个小时的能力,就像你不可能靠做小学生算术题练出解微积分的本事。
研究团队想到的办法挺聪明:**去GitHub上找那些"重大版本更新"的PR(Pull Request,代码提交合并请求)。**
一个PR如果新增了一千行以上的代码,那背后大概率是一次实打实的大功能开发,涉及理解整个代码库的架构、设计新模块、写代码、调试、写测试用例,这一整套流程天然就是长任务。团队从一万个GitHub仓库里挖出了十万个这样的重大PR,按新增代码行数分成三档:一百到两百行的算简单任务,两百到一千行的算中等任务,一千行以上的算困难任务,比例是2比3比5,故意让困难任务占大头,逼着模型往长周期方向练。
每个任务被组装成三个部分:一份要操作的代码仓库(版本回退到PR提交之前那一刻),一份任务说明(优先用PR的首条评论,没有就用发布说明,都没有就让大语言模型根据代码差异自己写一份),还有一套用来打分的单元测试,包括验证新功能对不对的"fail-to-pass"测试和验证老功能没坏的"pass-to-pass"测试。
这里有个细节我觉得特别值得说:**沙箱环境是一台干净的Ubuntu系统,什么依赖包都没提前装好。**
如果直接把环境配置好交给模型,那就相当于让一个人去考试,答案已经写在桌上一半了。团队认为,能不能自己搭建开发环境本身就是自主智能体应该具备的能力,所以故意什么都不装,逼着模型自己去处理环境配置这个真实世界里再普通不过、但又经常被简化掉的环节。
这就像教一个人做饭,你不能把菜都切好调料都配好只让他掂勺,得让他从买菜洗菜开始全套走一遍,否则他永远学不会应对"冰箱里没有葱"这种真实厨房里天天发生的意外。如果跳过环境搭建这一步,模型学到的只是"在别人准备好的舞台上表演",一旦换个真实场景就露馅。
光有单个任务还不够狠。研究团队又搞了个"多任务链接",随机挑五个已经生成好的任务,把它们的代码仓库、任务说明、测试标准全部拼在一起,变成一个横跨多个大型项目、需要模型来回切换上下文的超级任务,团队管这个叫"前沿级任务"。
教模型模仿,再教模型自己练
数据有了,接下来是怎么把这种能力灌进模型里。团队用的是三步走:先合成数据,再"拒绝采样微调",最后强化学习。
**"拒绝采样微调"这个词听起来拗口,其实逻辑很简单:**
先找一个已经很擅长长时间干活的老师模型,这里用的是Kimi K3,让它在合成出来的任务上真刀真枪去做,用三种不同的执行框架(Claude Code、Codex、OpenClaw)分别跑一遍,采集下所有的操作轨迹。然后只留下那些最终结果通过了全部单元测试的轨迹,扔掉失败的,用剩下这些"成功案例"去微调一个基础模型,让它先学个八九不离十的样子。
这个筛选逻辑跟考试改卷子有点像,只不过反过来了:不是老师批改学生的卷子,而是让一个学霸先把题做一遍,只把做对的那些解题过程留下来,当成范本给新学生看。团队用三种不同框架生成轨迹这一点也有讲究,如果只用一种框架,模型很可能学到的不是"怎么解决问题",而是"怎么套用这一种工具的固定套路"。换个环境立刻抓瞎。用三种框架交叉训练,逼着模型学的是解决问题的通用逻辑,而不是死记硬背某个工具的按钮位置。
这一步用了四万多条筛选出来的高质量轨迹,序列长度设到了256k,意味着模型一次能处理的上下文极其长,这也是长时间执行的硬件基础,毕竟你要是记不住几个小时前的事情,谈什么坚持。
模仿是第一步,光靠模仿是不够的。
**接下来才是真正的硬仗:强化学习阶段,模型要在真实沙箱里自己动手,自己犯错,自己承担后果。**
这时候论文里提出了一个我觉得挺有意思的设计,叫"后期阶段奖励加成"(Later Stage Bonus Reward)。
它解决的问题是什么呢?很多长任务在执行到后半段的时候,模型容易开始"摸鱼",前面把主要框架搭起来了,后面就随便应付,哪怕后面藏着一个关键的隐藏bug没修,或者有个明显能提升性能的优化点,模型也懒得去碰。这跟人写论文或者做项目很像,前面攻坚阶段状态最好,越到收尾越容易松懈,甚至最后关头敷衍了事。
团队的办法是,每次执行完一个完整任务后,找一个强大的大语言模型来把整个操作过程拆成几个阶段(比如六个阶段),再逐阶段判断这个阶段里有没有出现"特别有价值的操作",比如揪出了一个隐藏很深的bug并且正确修复了,或者做了个关键优化让性能大幅提升。如果在执行过程的后半段(哪怕只有一个阶段)出现了这种高价值操作,模型就能额外拿到0.5分的奖励。
这个设计的巧妙之处在于,它不是单纯奖励"做完了",而是奖励"在快撑不住的时候还在认真干活"。
如果没有这个机制,模型很可能学会一种取巧策略:前半段表现得很努力,把明显的活干完,后半段随便应付混过验证测试就收工。毕竟只要最终测试通过,传统的"对错二元奖励"是不管过程质量的。加了这个后期奖励,相当于告诉模型,光把作业交上来还不够,最后那几道题也得认真做,不能敷衍。
论文里做了个消融实验验证这个设计到底有没有用,把奖励值从0.2试到0.8,最后发现0.5是最合适的。太小起不到激励作用,太大又会让模型在某些轨迹里过度追求"制造亮点"而忽视了任务本身能不能做对,本末倒置。这也挺有意思的,说明这个奖励的分寸感很重要,不是越大越好。
强化学习框架用的是GRPO(Group Reward Proximal Optimization,一种通过组内多次采样、比较相对奖励高低来优化策略的强化学习算法),每个任务采样8次,取相对表现好的那几次给正反馈。整个训练过程接了一个叫Harbor的框架,负责自动化管理沙箱创建、环境安装、执行调度、打分这些琐碎但必需的基础设施工作。
数字说话:这套方法到底行不行
论文在五个跟长时间执行相关的基准测试上做了对比,结果整理成了下面这张表(节选核心部分,完整版本论文原文有更详细的对照):
| 模型 | FrontierSWE | NL2Repo | SWE-Marathon | Terminal Bench 2.0 | SWE-Bench Verified |
|---|---|---|---|---|---|
| Qwen3.5-9B(基础模型) | 10.2 | 17.9 | 0 | 27.3 | 43.8 |
| Gemini-3.1-Pro(闭源) | 25.9 | 42.8 | 5.9 | 60.3 | 80.1 |
| **Marathoner-9B(本文方法)** | **26.4** | 34.7 | **8.2** | 57.2 | 77.5 |
这张表里最扎眼的一行是最后一行。
**一个只有9B参数的开源模型,在FrontierSWE和SWE-Marathon这两个基准上,居然打过了谷歌的Gemini-3.1-Pro。**
要知道9B参数在如今动辄百亿千亿参数的模型阵营里,属于比较小的那一档,能在长时间执行这个维度上超过体量更大的闭源模型,说明这套训练方法确实抓住了问题的关键,而不是靠堆参数硬刚。
当然也得说实话,跟Kimi K3、GPT-6-Astra、Claude Fable 5.1这些真正的顶级闭源大模型比,Marathoner-9B还有差距,人家分数普遍在80到90分区间。这也正常,毕竟这些模型的参数量根本不在一个量级。但对比同样规模的开源模型,比如原始的Qwen3.5-9B,几乎所有基准上都是成倍甚至十几倍的提升,SWE-Marathon这个基准原始模型直接是0分,Marathoner做到了8.2分。这个对比最能说明训练方法本身的有效性,而不是模型底子有多好。
论文还专门做了个统计,看Marathoner在两个基准上具体的执行画像:
| 基准 | 平均执行时间 | 平均步数 | 平均工具调用次数 |
|---|---|---|---|
| FrontierSWE | 3.56小时 | 426.2 | 648.3 |
| Terminal Bench 2.0 | 0.58小时 | 104.8 | 239.4 |
这两组数字放在一起看,能看出模型对任务难度是有感知的,不是所有任务都用同一套节奏死板地走完,简单任务半小时左右搞定,复杂任务能拖到三个半小时以上,符合直觉。
拆开来看,每个设计到底贡献了多少
光看最终成绩不够有说服力,团队还做了几组消融实验,一个一个拆解三个关键设计(多任务链接、多框架轨迹生成、后期奖励加成)各自的价值:
| 配置 | FrontierSWE | Terminal Bench 2.0 |
|---|---|---|
| 基础版本(无任何创新点) | 22.7 | 51.3 |
| + 多任务链接 | 24.9 | 54.8 |
| + 多框架轨迹生成 | 24.1 | 53.7 |
| + 后期奖励加成 | 24.6 | 54.4 |
三个设计单独加上去都能带来提升,多任务链接的效果最明显,从22.7涨到24.9,说明合成更难的训练数据这条路走对了。
论文还专门试验了多任务链接里到底该链几个任务合适,结果发现链5个效果最好,链2到3个不够难,起不到锻炼效果,链7到9个又太夸张,脱离了真实评测场景的任务分布,反而拖累表现。这个结果挺有意思,它说明训练数据的难度不是越极端越好,得跟目标场景的难度分布匹配,这跟健身增肌一个道理,训练强度太低练不出效果,太高了容易受伤,得找一个持续可承受又有挑战的区间。
团队还专门跑了环境规模的扩展实验,把强化学习训练用的任务数量从1000一路加到8000,发现随着任务数量增加,模型在FrontierSWE和Terminal Bench 2.0上的表现持续提升,没有出现明显的天花板。这暗示了一件事:只要愿意投入更多真实环境去训练,这种长时间执行能力的上限还能继续往上走,目前还没摸到顶。
写在后面
读完这篇论文,最让我意外的不是那个11.8小时的数字,而是团队处理环境搭建这个细节的态度。
很多做Agent的工作,为了让实验数据好看,会默默地把环境依赖提前配置好,模型只需要专注在"写代码"这一件事上。Marathoner的团队反其道而行,故意给一个什么都没装的裸系统,逼模型从头开始搭环境。这个选择在论文正文里只占了一小段,但它其实暴露了一种研究态度:宁可让训练难度提高、让指标短期内看起来没那么漂亮,也要保证学到的能力是真实可迁移的,而不是在温室里练出来的花架子。
另一个让我反复琢磨的是那个案例轨迹,模型在处理一个Rust控制流重构任务时,中途卡在一个pickle序列化的bug上,它自己去读了序列化的源码,定位到问题出在label_spec的标签值在反序列化时被弄乱了,然后自己设计了一个"归一化"的修复方案。这不是在背答案,这是真的在推理。而且它还在后面遇到了一个更隐蔽的bug,模型自己意识到"宽度检查"用错了数据来源,翻出根本原因后重写了逻辑。这种排查过程跟一个资深工程师debug的思路几乎一模一样,先复现,再对比预期和实际,再定位到具体代码行,再验证修复。
论文没有解决的问题也很明显:这种长时间执行能力目前主要在软件工程这个垂直领域被验证过,换到数学证明、科研写作这些同样需要长期坚持的场景,这套合成数据加拒绝采样加强化学习的框架还能不能直接搬过去用,论文没有给答案。GitHub上的PR天然自带"可验证的单元测试"这个奖励信号,但换成写一篇论文或者证一个数学定理,你怎么设计一个自动化的、二元的对错判断标准?这个问题恐怕比训练模型本身更难。
如果有一天AI真的能像论文里描述的那样连续工作几天去啃一个数学猜想,你会不会好奇,它在那些没人看着的凌晨三点,到底在想什么?
Q&A
Q1:Marathoner是什么?
A:Marathoner是Ant Group联合多所高校提出的自主智能体模型,核心能力是能持续执行超长时间的复杂任务,比如连续工作11.8小时完成872步操作和1273次工具调用。
Q2:Marathoner是怎么训练出长时间执行能力的?
A:分三步,先从GitHub重大版本更新的PR中合成大量高难度任务数据,再用强模型生成轨迹做拒绝采样微调打基础,最后通过强化学习在真实沙箱里让模型自主练习,并用后期阶段奖励加成机制鼓励模型在任务后半段也认真干活。
Q3:Marathoner-9B这么小的模型效果怎么样?
A:在FrontierSWE和SWE-Marathon两个基准上,9B参数的Marathoner超过了参数量更大的闭源模型Gemini-3.1-Pro,但和顶级闭源模型如GPT-6-Astra相比仍有差距,不过相较同规模开源基础模型有数倍提升。


 0赞
好文章,需要你的鼓励

至顶头条
科技行者
码客人生

奇客Solidot
高飞的电子替身
奇客情报站

 推荐文章
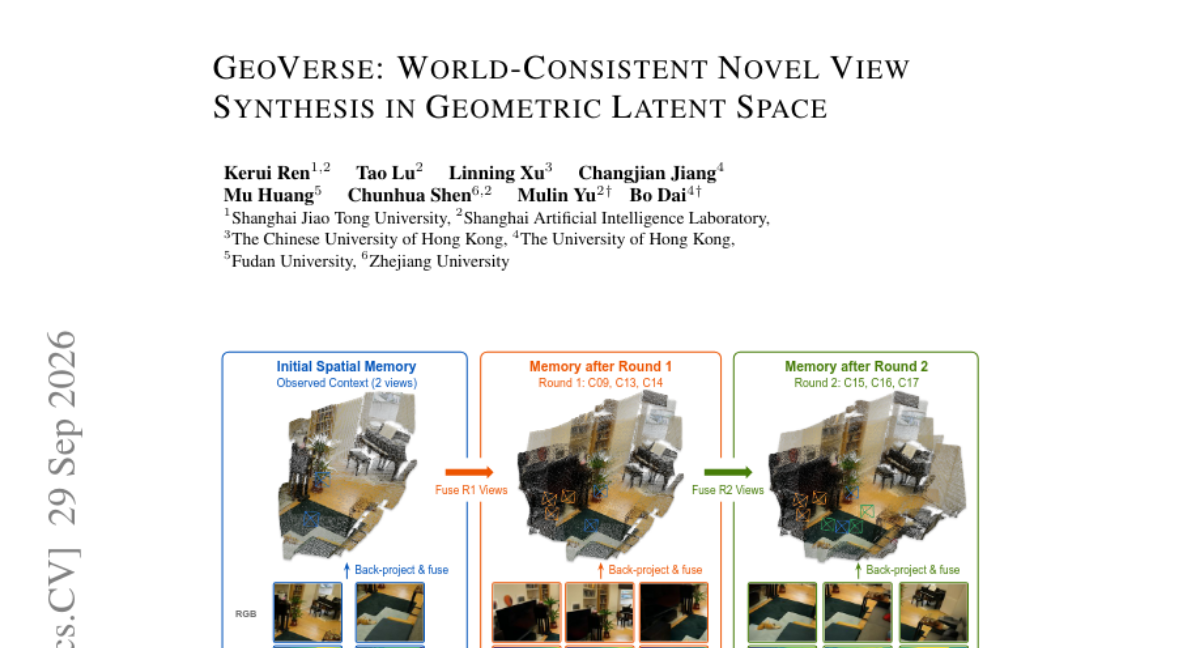
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。
该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





