




 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

CES2014主馆十个之最 中美日韩一统欧洲沒戏


我4点半醒了,哎,凌晨3点睡,4点半醒,好烦!5点多就起床,因为怕堵车,6点半集合去展览中心,还好,趁人少我快去拍照。在大门口我发现,离我第一次到这里参观Comdex已经20年了。
最疯狂的展台
应属统一选择了全白色的三星、索尼、LG尤其是三星展台,气势,总面积超过了国内所有大厂商的面积。
最笨厚
美国也有大屏电视展出,厚度是国内厂商屏的3倍。
最中国
最中国的展台是长虹,大红门前我拍了照。
最大屏
最大屏电视是110英寸,三星、TCL都有展出
最集人气
是英特尔(照8) 最尬尴 与英特尔相隔一个展台的展台是高通,兩位对手狭路相缝
最意外
最意外的展品是看到了YaHoo小屏电视。
最惹眼
最惹眼的是各品牌汽车出现展台,开玩笑说不久CES变成汽车展
最可怜
最可怜的展商是思科,只有一个口号墙缩在角落里(照15)
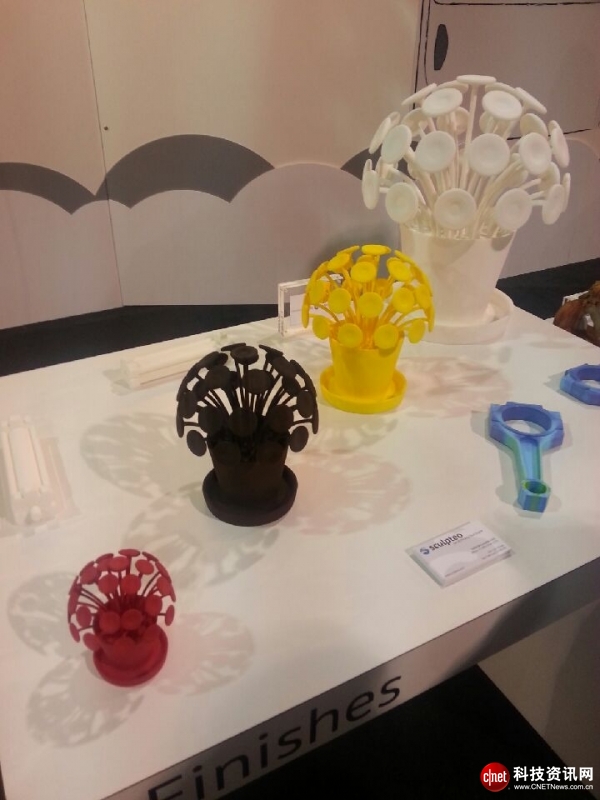
最前卫
在南馆中我看到了最前卫的3D打印成果,几乎都是美商所为。
结束语
凡是大电视厂商都推曲面电视。美、中、韩、日统治CES,欧洲厂商没戏。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章


为什么越难的题,AI 越学不会?RGPO 用一个"临时脚手架"解决了这个死结
RGPO用"临时脚手架"破解大模型强化学习的奖励稀疏难题:先让模型独立解题,失败则分段放出标准解法引导重写,仅采纳经验证更优的答案。难题测试准确率从0跃至99.5%,语言模型平均分高出最强基线5.0分。

让大模型学会"对齐":用专家路由给多语言能力松绑
论文提出用MoE模型的路由器输出作为跨语言对齐目标,通过持续预训练对翻译句对施加路由KL散度损失,在不改变分词和架构的前提下让隐藏表示更接近,并在四个开源MoE模型、七种语言上验证了下游任务性能的一致提升。

DiffGate:当老师和考官意见不一致时,AI学生该听谁的?
DiffGate提出难度门控的教师指导机制,让验证器决定何时需要教师介入,仅对失败且困难的轨迹提供有界教师指导,结合GRPO强化学习,在数学与代码任务上显著提升解题覆盖率与跨领域迁移能力。

语言模型真的需要一张可训练的词嵌入表吗?
研究者用固定不变的16位二进制编码替代传统可训练词嵌入表,在17亿参数规模模型上训练1000亿token,证明模型仍可获得实质语言能力,揭示输入表并非必需,但性能略逊于可学习方案。
为什么越难的题,AI 越学不会?RGPO 用一个"临时脚手架"解决了这个死结
让大模型学会"对齐":用专家路由给多语言能力松绑
DiffGate:当老师和考官意见不一致时,AI学生该听谁的?
语言模型真的需要一张可训练的词嵌入表吗?





