




 微信扫一扫,关注公众号

科技行者

算力行者
见证连接与计算的「力量」

连加油站都被比特币勒索病毒黑了!阿里云专家:关闭服务器445端口!


CNET科技资讯网 5月13日 北京消息:“我对大规模杀伤武器是很悲观的,但我认为发生核战争的可能性要低于生化武器与网络攻击。” 谁也不曾想到,巴菲特一周前在伯克希尔哈撒韦股东大会上所说的这番话这么快就变成了真。
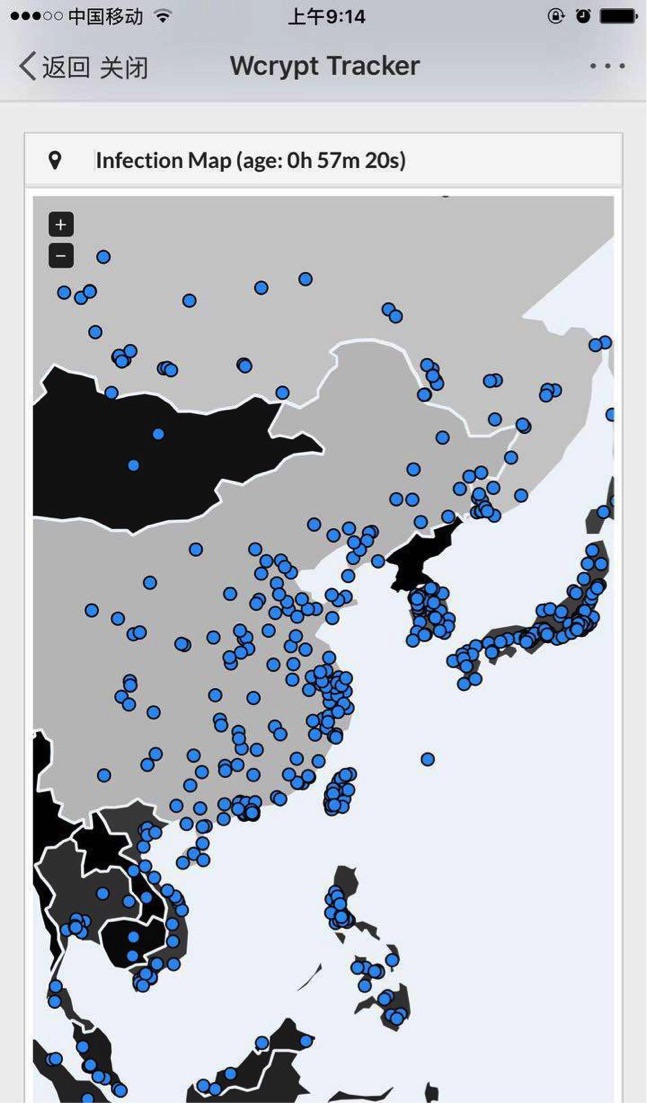
5月12日晚,WanaCrypt0r2.0勒索软件在全球爆发(简称WCry2.0)。在无需用户任何操作的情况下,Wcry2.0即可扫描开放445文件共享端口的Windows机器,从而植入恶意程序。

目前,病毒已经扩散至全球上百个国家。全英国上下25家医院遭到大范围攻击,中国众多高校也纷纷中招。黑客则通过锁定电脑文件来勒索用户交赎金,而且只收比特币。
阿里云安全专家分析,此次全球比特币勒索病毒是由NSA泄露的Windows系统 SMB/RDP远程命令执行漏洞引起。利用该漏洞,黑客可远程实现攻击Windows的445端口(文件共享)。如果系统没有安装今年3月的微软补丁,无需用户任何操作,只要开机上网,黑客即可在电脑里执行任意代码,植入勒索病毒等恶意程序。
考虑到Windows系统 SMB/RDP远程命令执行漏洞的危险性,国内外不少云服务厂商都在4月封掉了445端口。但全球不少个人电脑、IDC物理机房仍存在大量暴露着445端口的机器,这给了黑客可乘之机。
杭州都市快报消息,5月12日晚 11时,下沙高教园区校园网被黑。学生电脑上的资料文档被锁,需要付费才能解锁。目前发现浙传,计量,理工大学……好多校区校园网都被黑了。
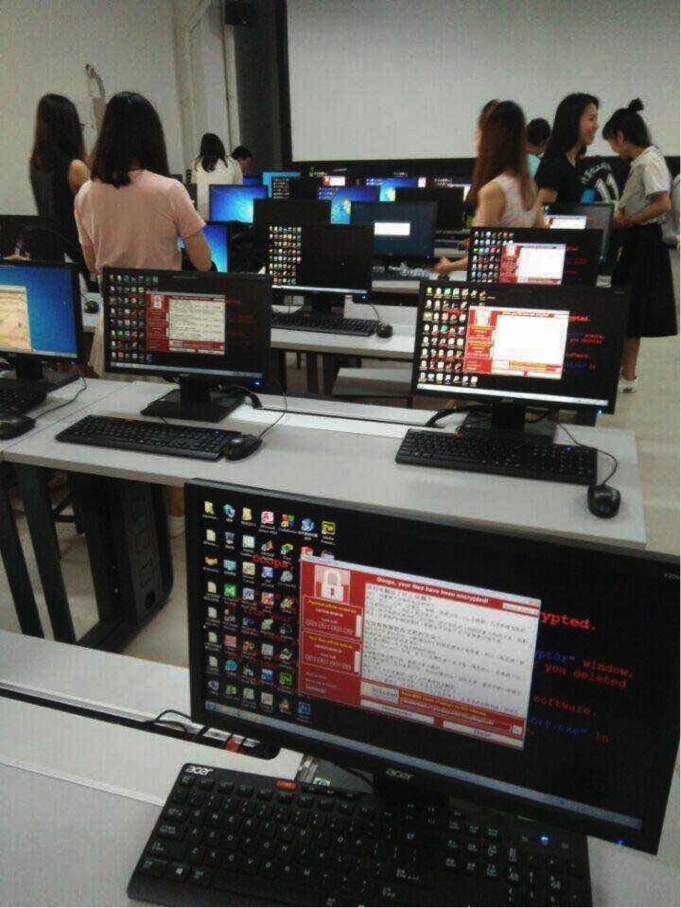
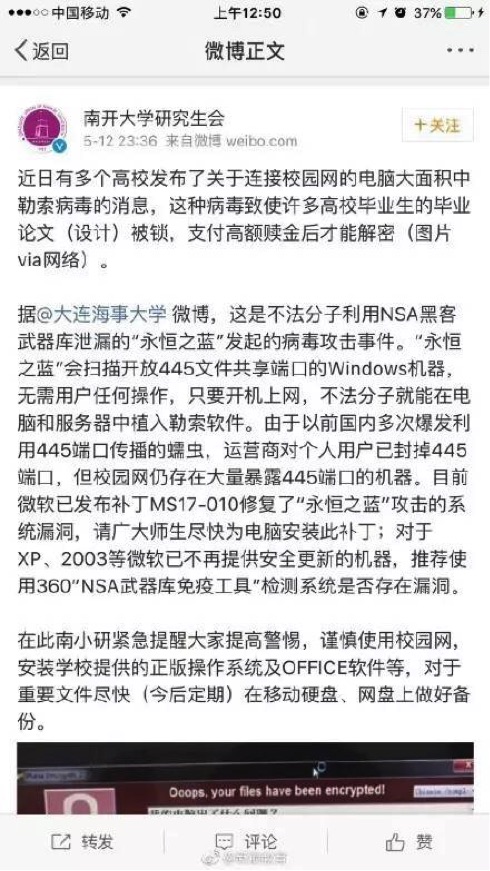
阿里云安全专家分析,此次勒索事件在校园网传播速度之快,影响面之大主要原因是当前大部分学校基本是一个大的内网互通的局域网,不同的业务未划分安全区域。例如:学生管理系统、教务系统等都可以通过任何一台连入的设备访问,
同时,实验室、多媒体教室、机器IP分配多为公网IP,如果学校未做相关的权限限制,所有机器直接暴露在外面。
事实上,被攻击的并不止中国的校园网。BBC发布消息称,目前全球范围内有大量的机构报告,受到了“勒索”软件的攻击,这些机构分别在美国、英国、中国、俄罗斯、西班牙、意大利、越南等地。
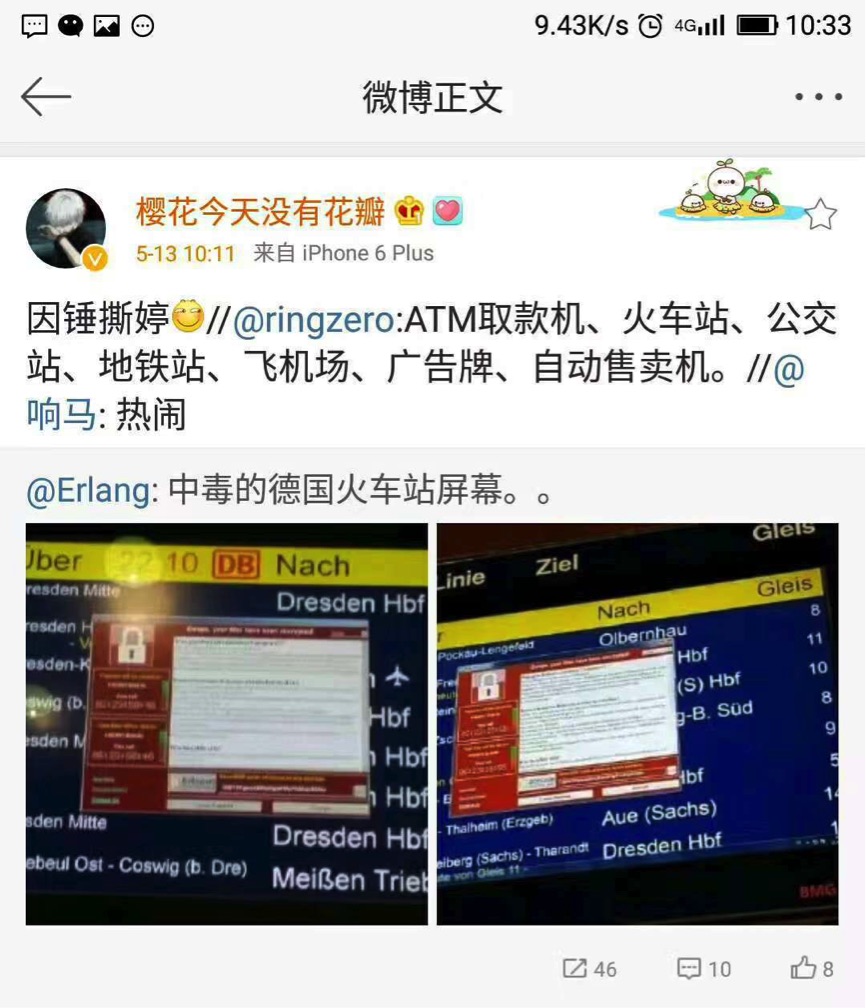
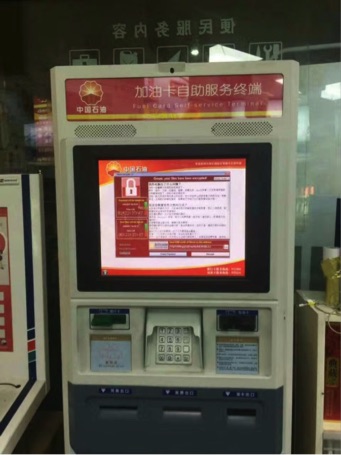
网上媒体报道,全国多地部分中国石油旗下加油站在今日0点左右也突然出现断网,只能使用现金支付,加油站加油业务正常运行。
据CNN报道,英国25家医院周五也因“大规模”的黑客攻击而瘫痪。手术被取消,救护车被迫转向其他医院。
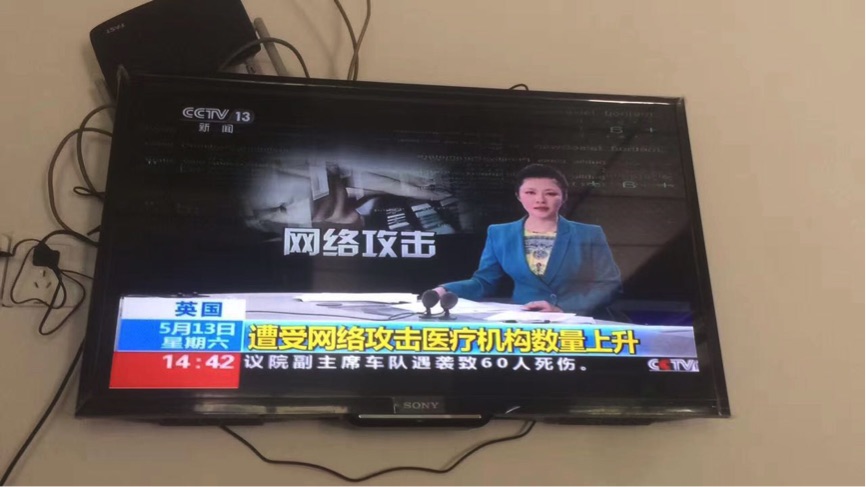
医疗工作者报告说,他们的系统被锁定了,根本进不去。屏幕上有消息显示,要求他们支付“赎金”以重新开启。
针对NSA黑客武器利用的Windows系统漏洞, 微软在今年3月已发布补丁修复。此前,阿里云第一时间发布预警,并推出一键检测修复NSA黑客武器攻击漏洞的工具。

目前,阿里云默认为ECS用户关闭445端口,且默认安装Windows官方补丁。所有在IDC托管或自建机房有服务器的企业,如果采用了Windows操作系统,立即安装微软补丁。
安全补丁对个人用户来说相对简单。只需自学装载,就能完成止血。但是对大型企业or组织机构而言,面对成百上千台机器,最好还是能使用客户端进行集中管理。比如,阿里云的安骑士就提供实时预警、防御、一键修复等功能。
可靠的数据备份可以将勒索软件带来的损失最小化。建议启用阿里云快照功能对数据镜像备份,并同时做好安全防护,避免被感染和损坏。


 0赞
好文章,需要你的鼓励


至顶头条

科技行者

码客人生

奇客Solidot

高飞的电子替身

奇客情报站

 推荐文章


GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
GeoVerse融合几何潜在扩散模型与Wan2.2视频生成先验,并引入全局空间记忆机制,实现了跨视角一致、生成质量高且推理速度快的新视角合成,在多个数据集上大幅超越现有方法GLD。

TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
本文解读TT-VidT,一种通过分离外观锚点与动作令牌、结合Diff Compression训练目标的视频自监督方法。在24种架构目标组合的受控实验中,仅TT3D与Diff Compression搭配才能进入强动作敏感区,且计算量比同类方法降低近一半。

该论文提出Imprint Reader模型
通过SMaRT训练方法从冻结的权重更新中读取模型学到的知识与行为
并利用其梯度信号构建MetaEdit技术
实现无需训练数据的行为干预
提升了安全拒绝率与推理能力。
2026-10-21 16:51AI模型能读懂自己学到了什么吗
Q&A Q1:Imprint Reader是什么? A:Imprint Reader是上海人工智能实验室团队开发的模型,通过SMaRT训练方法学会读取另一个模型冻结的权重更新,把参数层面的变化翻译成自然语言描述,判断这次更新到底注入了什么知识或诱导了什么行为习惯。 Q2:MetaEdit能做什么? A:MetaEdit能把Reader对目标行为的梯度信号迁移到原始模型上,不需要任何目标任务的训练数据,只用一句行为描述就能定向调整模型参数,已经在安全性拒绝率调节、数学推理风格转变和工具调用能力提升上验证过效果。 Q3:Imprint Reader读权重更新的准确率高吗? A:目前还不高,知识类目标的Pass@100只有2%,行为类目标是16%,说明自由生成描述的可靠性有限,但相比原始模型完全答不出来的0%基线,已经证明了权重更新的自然语言读取是可行的。

AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"
统一多模态模型能看也能画,理论上该会自我修正。本论文提出UMM-Reflection,用整条轨迹的强化学习联合训练诊断和修图能力,GenEval提升12分,且迁移到多个未训练基准,揭示RL提升的是选择可靠性而非新能力。
GeoVerse:给AI装一双"记得住场景"的眼睛,让新视角生成不再跑偏
TT-VidT:把视频拆成"这一帧长什么样"和"它怎么动了",能让AI学得更聪明吗
AI模型能读懂自己学到了什么吗
AI给自己的画反悔,然后又改好了:统一模型如何学会"回头看"





